MCA 机器检查架构:硬件错误如何通过 bank 寄存器与 CMCI 上报到软件
更新时间:2026-10-05。服务器跑久了总会遇到这种事:某天
dmesg里突然冒出一条mce: [Hardware Error],或者内存 ECC 计数悄悄涨了几百。这些信息不是玄学,它们全部来自 x86 处理器里一套专门的硬件错误上报通道——MCA(Machine Check Architecture,机器检查架构)。本篇属于微架构可靠性(RAS,Reliability/Availability/Serviceability)方向,和 精确异常与流水线冲刷 讲的「异常发生时流水线怎么办」是邻居:那边讲异常机制本身,这边讲「硬件出错时谁来敲门、敲几次、软件怎么接」。读完你会知道 bank 寄存器里每个字段是什么意思、为什么有的错误立刻宕机有的只是记一笔、以及 Linux 的 mce 子系统如何把硬件错误翻译成可运维的信号。
本文要回答的问题
- MCA 机器检查架构是什么?它管哪些硬件错误?
- bank 寄存器(MCi_STATUS / MCi_ADDR / MCi_MISC)各记录什么?怎么读?
- 错误分几级?UC、SRAR、CE 分别意味着什么处置方式?
- CMCI 是什么?为什么可纠正错误不走 #MC 异常而走这个中断?
- Linux 侧的 mce 驱动、EDAC、rasdaemon 如何接力处置一条硬件错误?
一、为什么需要 MCA:硬件会坏,但坏之前会先说
x86 处理器内部的错误来源非常杂:缓存行的 ECC 校验失败、内存控制器读到不可纠正的数据、总线上的奇偶校验出错、TLB 或寄存器堆里的多bit翻转、甚至内部互联(如 Intel 的 UPI、AMD 的 Infinity Fabric)的链路错误。在没有统一架构的年代,这些错误各报各的,操作系统根本接不住。
MCA 是 Intel 从 Pentium 时代开始引入、AMD 同步兼容的一套统一机制,核心思想有两条:
- 统一容器:不管错误出在哪个部件,都按统一格式写进一组寄存器(bank),软件只需要一套代码就能遍历所有错误源。
- 分级处置:把错误按严重程度分级——致命的错误当场通过 #MC(Machine Check Exception,机器检查异常,18 号向量)把 CPU 拉进异常处理;可纠正的错误攒起来,用一次普通的中断批量上报,不打扰正在跑的业务。
这两条线对应 RAS 的两个目标:致命错误要「fail fast」,宁可杀掉进程或宕机也不能让脏数据继续传播;可纠正错误要「可观测」,让运维能在硬件彻底坏掉之前发现趋势、计划换件。
| 维度 | 无 MCA 的世界 | 有 MCA 的世界 |
|---|---|---|
| 错误格式 | 各部件自定义,软件无法统一解析 | 统一 bank 寄存器格式 |
| 可纠正错误 | 静默累积,无感知 | CMCI 按阈值上报 |
| 致命错误 | 直接挂死或数据损坏 | #MC 异常,可尝试恢复或干净地 panic |
| 运维手段 | 等宕机后换件 | 看趋势预测性换件 |
二、bank 寄存器:每个错误源一组,格式统一
MCA 把处理器里的错误源组织成若干个 bank(库),每个 bank 对应一个可独立上报错误的硬件单元:某个核的 L1 数据缓存、某个核的 L2、内存控制器的某个通道、QPI/UPI 链路、北桥等等。具体有多少个 bank 由 CPUID 报告(CPUID.1:EDX.MCA 表示支持 MCA,IA32_MCG_CAP MSR 的 Count 字段给出 bank 数量,现代服务器 CPU 通常在 20 到 40 个之间)。
每个 bank 由四个 MSR(Model-Specific Register,型号特定寄存器)组成:
| 寄存器 | 作用 | 关键字段 |
|---|---|---|
IA32_MCi_CTL | 控制位:该 bank 上报哪些错误类型 | 每一位对应一种错误使能 |
IA32_MCi_STATUS | 错误状态:本次错误的核心信息 | VAL、UC、PCC、S、AR、MISCV、ADDRV、MCACOD |
IA32_MCi_ADDR | 出错地址:数据缓存错误时的物理地址 | 物理地址(仅 ADDRV=1 时有效) |
IA32_MCi_MISC | 杂项信息:厂商自定义补充 | 内存错误时的通道/DIMM 定位等 |
软件读 MCA 的标准动作是遍历所有 bank,对每个 bank 检查 MCi_STATUS 的 VAL 位(bit 63,表示本寄存器内容有效),有效就解析其余字段,最后写 0 清掉(表示软件已经收走这条记录)。
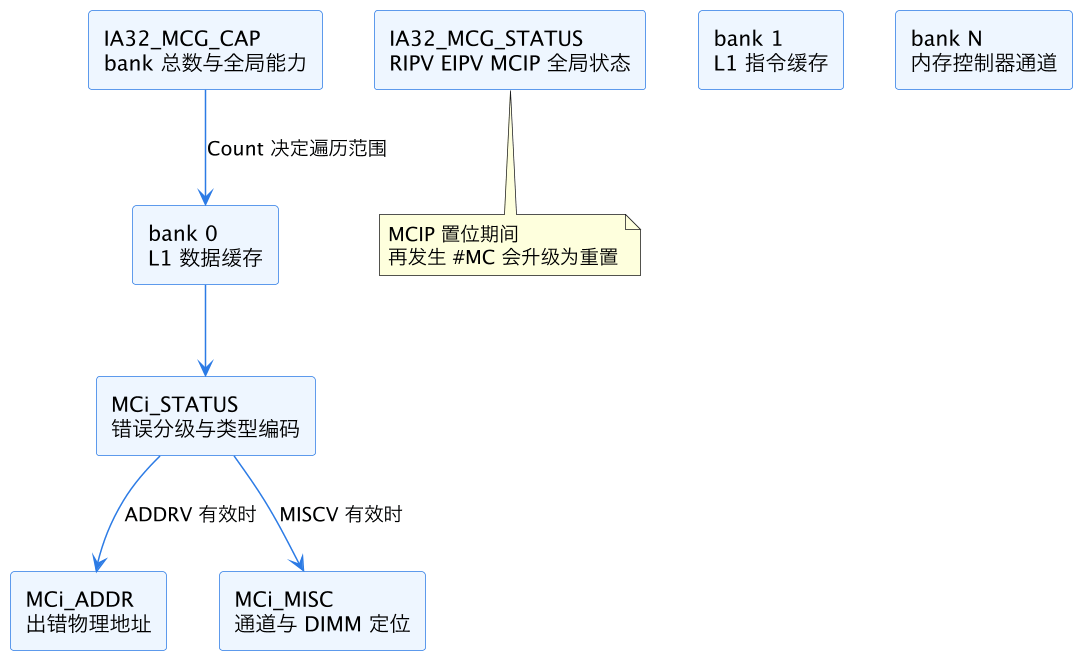
上图是 MCA 寄存器的组织方式:全局的 MCG_CAP 和 MCG_STATUS 描述处理器整体能力,每个 bank 自带 STATUS/ADDR/MISC 三件套。解读任何一条 MCE 日志,本质就是把 STATUS 里的位拆开翻译。
MCi_STATUS 里最有价值的几个位:
- UC(Uncorrected):本次错误不可纠正。UC=0 是硬件已经纠正的可纠正错误(CE,Corrected Error),只值得记录;UC=1 是脏数据已经流出去了,需要软件介入。
- PCC(Processor Context Corrupted):处理器上下文已损坏,不可恢复,只能宕机。
- S 与 AR(Signaling 与 Action Required):AR=1 表示这条错误要求软件立刻行动(典型就是内存回收),否则数据会继续扩散。
- MCACOD(低 16 位):错误类型编码,比如
0x0150是内存控制器的未纠正读错误、0x000A是缓存层级的 ECC 错误。Linux 日志里打印的mce: ... MEMORY CONTROLLER RD_CHANNEL error就是查表翻译 MCACOD 的结果。
三、错误分级:从悄悄纠正到当场宕机
MCA 把错误按「能不能纠正、要不要立刻行动」分成几档,每一档对应完全不同的硬件动作与软件处置路径:
| 级别 | 缩写 | 含义 | 上报方式 | 典型处置 |
|---|---|---|---|---|
| 可纠正错误 | CE | ECC 已自动修复,数据无损 | CMCI 中断(阈值触发) | 计数、趋势分析、预测性换件 |
| 未纠正但可恢复 | SRAR | 数据脏了但可被软件丢弃或重取 | #MC 异常 | 杀掉受影响进程(SIGBUS) |
| 未纠正且需行动 | SRAO | 数据脏了但未被消费,可提前回收 | #MC 或 CMCI | 内存离线(page offline) |
| 致命错误 | PCC | 上下文损坏,无法恢复 | #MC 异常 | 内核 panic,干净地死 |
SRAR(Software Recoverable Action Required)与 SRAO(Software Recoverable Action Optional)是 Intel 从 Nehalem 之后逐步引入的「可恢复机器检查」能力,它是现代内存 RAS 的地基:以前内存出现不可纠正错误基本等于宕机,现在只要脏页还没被消费(SRAO),内核可以悄悄把这一页隔离;就算已经被某个进程读了(SRAR),也可以只杀掉那个进程而不是整台机器。
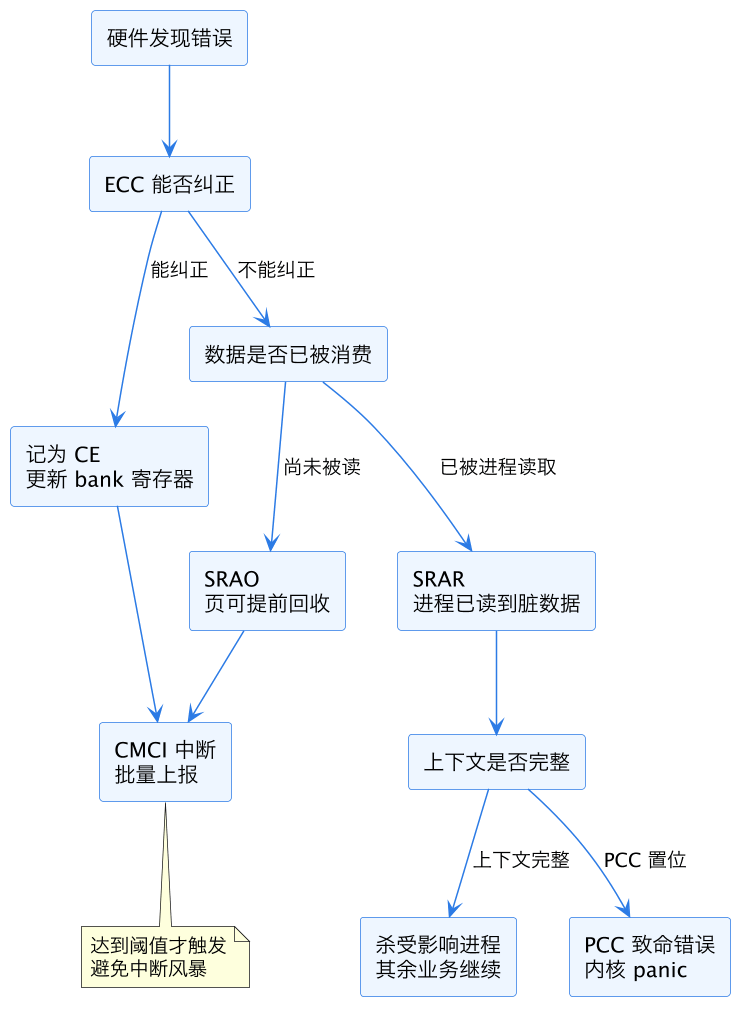
上图是 MCA 错误从硬件发现到分级处置的完整决策树。注意最右边那条路:CE 与 SRAO 最终都汇入 CMCI 这条「不紧急」通道,这正是下一节的主角。
四、CMCI:可纠正错误的批量上报通道
如果每一个可纠正错误都触发一次 #MC 异常,那内存稍有老化的服务器会被异常淹没——ECC 单位翻转在数据中心里是日常事件,一台机器一天几十上百次很正常。CMCI(Corrected Machine Check Interrupt,可纠正机器检查中断,本地 APIC 的 LVT 表里有专门的 CMCI 表项)就是为此设计的:它是一次普通的中断,不是异常,不冲刷流水线、不切换上下文语义,业务几乎无感。
CMCI 的聪明之处在于阈值机制。每个 bank 的 IA32_MCi_CTL2 MSR 里有一个 threshold 字段:硬件计数可纠正错误,只有累计达到阈值才拉起 CMCI。默认值通常是 1(每个 CE 都报),但对已知老化的部件可以调高——比如设成 100,意思是「这条内存通道每攒够 100 次 CE 才打扰我一次」,把中断频率压到可接受的范围,又不至于完全失明。
| 对比项 | #MC 异常 | CMCI 中断 |
|---|---|---|
| 触发错误 | 未纠正错误(UC=1) | 可纠正错误(CE) |
| 向量 | 18(异常) | 本地 APIC LVT 表项(通常 0xF8 左右) |
| 上下文 | 冲刷流水线,进入异常处理(机制见 精确异常与流水线冲刷) | 普通中断,开销低 |
| 频率控制 | 无(每个未纠正错误都要处理) | 阈值累计,可降噪 |
| 软件动作 | 评估恢复或宕机 | 计数、记录、趋势分析 |
还有一个细节常被忽略:CMCI 只在「该 bank 的阈值被触达」那一刻发一次中断,之后如果继续出错,硬件会把计数器清零重新累计——也就是说阈值相当于一个可编程的降频器。Intel 的手册里明确建议,对已知高发的错误源(比如某根正在老化的 DIMM 对应的内存控制器 bank)应适当调高阈值,否则 CMCI 本身也会变成一种中断风暴。虚拟化场景下还要特别注意:CMCI 是否暴露给虚拟机由 hypervisor 决定,KVM 默认只把 #MC 类事件注入客户机,客户机内部看到的 CE 计数通常是宿主过滤后的结果。
一个容易混淆的点:CMCI 只是「通知机制」,错误记录本身仍然写在 bank 寄存器里。如果阈值设得大,两次 CMCI 之间可能攒了好几条记录,而 bank 里同一时刻只留最新的一条(旧记录被覆盖)——所以软件收到 CMCI 后除了读 bank,还要结合累计计数判断丢了多少历史。这也是为什么数据中心侧更依赖带外通道(BMC 通过 PECI 或 SMBus 定期轮询 bank)来做完整的 CE 历史采集。
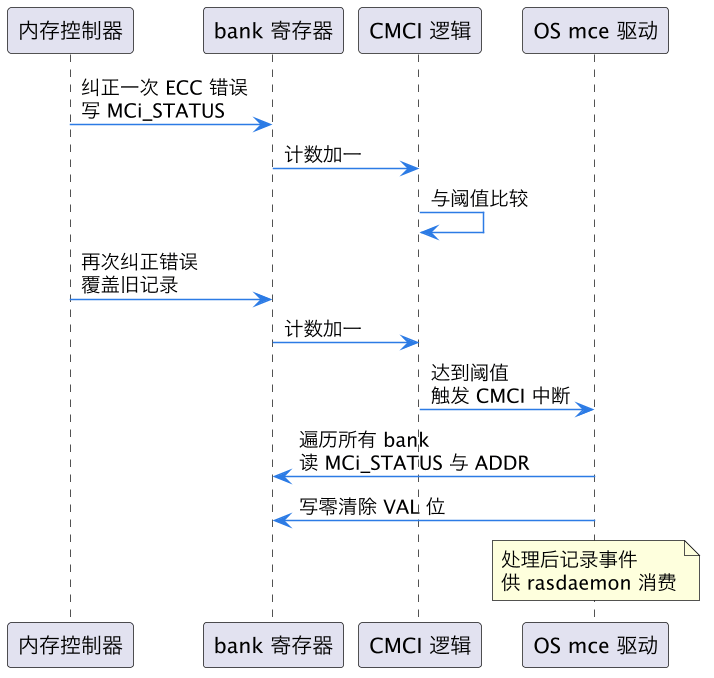
这张时序图是 CMCI 的典型生命周期:错误随时发生、随时写入 bank,但中断只在攒够阈值时触发一次,软件在中断处理里把 bank 里现存的记录读走清零。中间被覆盖的那条记录就靠累计计数来推断「丢了几条」。
五、Linux 侧的处置链:从 mce 驱动到 rasdaemon
Linux 内核对 MCA 的支持集中在 arch/x86/kernel/cpu/mce/ 目录,处置链分三层:
第一层:mce 驱动(中断/异常处理)。do_machine_check() 是 #MC 异常的入口,mce_intel_feature_init() 在 CPU 初始化时使能各 bank 并注册 CMCI 处理。处理流程是:扫描所有 bank,把有效的 STATUS/ADDR/MISC 打包成 struct mce,然后按严重度走不同路径——致命错误直接 panic;SRAR 类型标记受影响页,调度后续恢复;CE 只入环形缓冲。用户态有两种消费方式:/dev/mcelog 字符设备(传统 mcelog 守护进程用)和 tracepoint mce:mce_record(现代 rasdaemon 用)。
第二层:内存恢复与离线。对 SRAR 错误,内核用 memory_failure() 尝试恢复:找到出错物理地址对应的页,如果该页属于某个进程,给进程发 SIGBUS(BUS_MCEERR_AO/AR);如果是空闲页或可重取页(如干净的 page cache),直接隔离。对 SRAO 错误则走 soft_offline_page() 提前把页踢出分配池。大量 CE 集中在一个物理区域时,mce 子系统还会触发「溢出页离线」建议,让运维或自动化脚本把整段内存离线。
第三层:用户态守护进程。rasdaemon 是当前主流:它订阅 tracepoint,把 MCE 事件连同解码后的 DIMM 槽位(依赖 EDAC 的内存拓扑信息)写入 SQLite 数据库,支持按 DIMM、按错误类型统计趋势。EDAC(Error Detection And Correction,drivers/edac/)则负责把「物理地址」翻译成「哪个通道哪根内存条」——MCA 给的 MCi_ADDR 只是物理地址,要知道是哪根 DIMM,必须结合内存控制器的地址交织(interleave)规则反推,这正是 EDAC 各家驱动(skx_edac、amd64_edac 等)干的活。
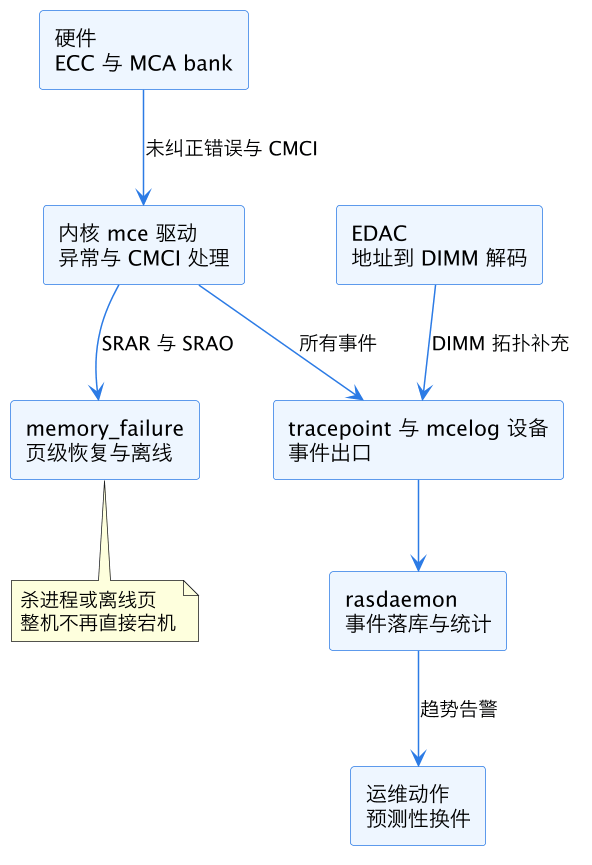
上图是 Linux RAS 处置链的全貌:硬件事件从 mce 驱动进入内核,按可恢复性分流——能恢复的走 memory_failure 做页级手术,所有事件都经 tracepoint 送达 rasdaemon 沉淀为长期趋势。运维看的「这台机器三个月内 CE 增长了十倍,该换内存了」这种结论,就是这条链最右端的产物。
六、实战:读懂一条 MCE 日志
把前面所有东西收拢,看一条真实的 dmesg 输出该怎么解读:
mce: [Hardware Error]: CPU 12: Machine Check: 0 Bank 7: ba00000000000405
mce: [Hardware Error]: RIP !INEXACT! 33:<ffffffff810abcde> {some_function+0x1e}
mce: [Hardware Error]: TSC 8f3a2b1c ADDR 2a3f5c000 MISC 8000001400860000
mce: [Hardware Error]: PROCESSOR 0:50654 TIME 1759630000 SOCKET 0 APIC 18
EDAC MC0: 1 CE memory read error on CPU_SrcID#0_MC#0_Chan#1_DIMM#0
逐字段拆解:
Bank 7:错误来自第 7 号 bank。bank 编号与部件的映射因 CPU 型号而异,Intel 服务器上高位 bank 通常是内存控制器(每个通道一个),这条日志下面的 EDAC 行证实了它是内存侧错误。ba00000000000405:这是MCi_STATUS的原始值。最高位b展开二进制是1011,即 VAL=1(有效)、OVER=0、UC=1(未纠正)、EN=1;低 16 位0x0405是 MCACOD,查表是内存控制器的 scrubbing 错误。ADDR 2a3f5c000:出错的物理地址,结合 EDAC 行可定位到 0 号插槽、1 号通道、0 号 DIMM。- 前缀
[Hardware Error]而没有 panic,说明这是一次可处理事件;若是 PCC 置位,你看到的会是内核 panic 栈而不是这行日志。
日常运维上,值得养成的习惯是:rasdaemon 常驻 + 定期 ras-mc-ctl --summary 看错误分布 + 对单 DIMM 的 CE 速率设告警阈值(经验值:单条 DIMM 每天 CE 超过几十次就该列入更换计划)。把 MCA 从「宕机后翻日志」变成「宕机前看趋势」,正是这套架构存在的意义。
这一篇在知识体系里的位置
MCA 是 x86 微架构可靠性故事的「上报层」:往底层,错误的发生与检测依赖缓存与内存的 ECC 机制,异常进入内核的流水线语义见 精确异常与流水线冲刷;往软件层,页级恢复的 memory_failure()、内存离线(memory hot-remove)与 cgroup 级的故障隔离是「处置层」,值得另开一篇。微架构专题的其余入口见 concepts/microarch/。
总结
MCA 机器检查架构用统一的 bank 寄存器(MCi_STATUS/ADDR/MISC)给处理器里所有硬件错误源提供标准化上报:可纠正错误经 CMCI 按阈值批量通知、几乎零打扰,未纠正错误经 #MC 异常按 SRAR/SRAO/PCC 分级——能杀进程就杀进程、能离线页就离线页、实在救不了才 panic;Linux 侧由 mce 驱动、EDAC 地址解码与 rasdaemon 趋势统计接力,把硬件错误从「莫名宕机」变成可观测、可预测、可计划处理的运维信号。