DSB/LSD 切换:Intel 前端三条取指译码路径的切换条件与性能差异
承 cpu-frontend-pipeline-panorama 对前端流水线的全景介绍,以及 uop-cache-decode-frontend 对 DSB 工作原理的拆解。同一段代码,CPU 给它喂 uop 的方式可能每几纳秒就变一次——MITE、DSB、LSD 三条路径的 DSB/LSD 切换,决定了前端实际能交付多宽的供给。
本文要回答的问题
- Intel 前端为什么要有 MITE、DSB、LSD 三条并行的 uop 供给路径?各自的能力边界在哪?
- DSB/LSD 切换的触发条件是什么?循环多大才能进 LSD,代码多大才装得下 DSB?
- 三条路径的交付带宽差多少?性能差异在真实负载里有多大?
- 用哪些 PMU 事件能看到当前走的是哪条路、热点分布在哪个供给源?
- 写代码时怎么刻意让热点落在 DSB/LSD 友好的形态上?
一、三条路径:为什么是「切换」而不是「分工」
x86 指令变长、前缀多、最长达 15 字节,传统译码器(MITE,Microcode Instruction Translation Engine 的俗称,即 legacy decode pipeline)每条指令要先经指令长度译码(见 instruction-length-decoder-x86)才能切出边界,再翻译成 uop。这条路功耗高、带宽受限(通常每周期 4-5 uop),还容易被长度译码的对齐问题拖累。
从 Sandy Bridge 开始,Intel 给前端加了「译码结果缓存」DSB(Decode Stream Buffer,即 uop cache)和「循环短路器」LSD(Loop Stream Detector,详见 loop-stream-detector-lsd),形成三级供给结构:
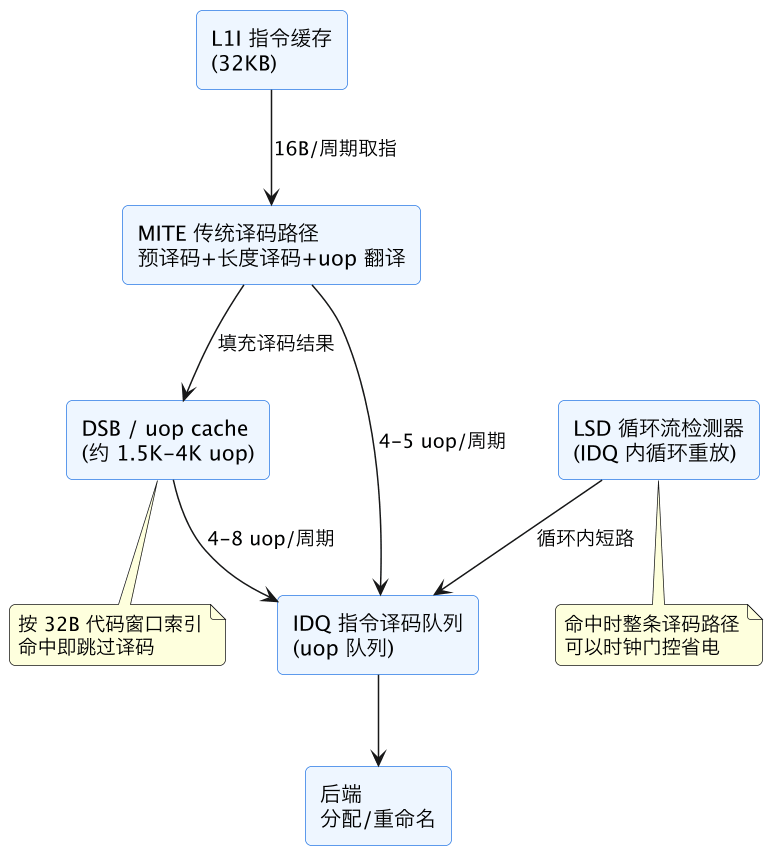
这张图的关键点:三条路径终点都是 IDQ,而且它们是互斥供给——任一时刻,某段代码的 uop 只从一个源来。硬件动态地在三者之间切换:代码第一次跑走 MITE,译码结果顺手填进 DSB;代码足迹稳定后进 DSB 命中;发现小循环则交给 LSD 在 IDQ 里原地重放。所谓 DSB/LSD 切换,就是这套「同一份 uop 流,换更快的供给源」的接力机制。
二、切换条件:每条路各有什么门槛
三条路径的准入条件是理解切换的核心,用一张表先给结论:
| 维度 | MITE | DSB | LSD |
|---|---|---|---|
| 覆盖对象 | 一切代码 | 能装进 uop cache 的热点代码 | 小循环体(所有迭代共享) |
| 容量限制 | 无(随取随译) | Skylake 约 1536 uop,Ice Lake 约 2250,Golden Cove 约 4000 | 通常 ≤64 uop/迭代,总窗口受 IDQ 大小限制 |
| 索引粒度 | 按分支预测取指 | 32 字节代码窗口 × 每路 uop 行 | 检测后向分支重复触发 |
| 典型带宽 | 4-5 uop/周期(Skylake 后 5) | 4-8 uop/周期(Golden Cove 8) | 与 IDQ 出队带宽一致 |
| 进入条件 | 默认路径 | DSB 行被填充且下次命中 | 循环体稳定重复且体积达标 |
| 被踢出的常见原因 | — | 代码足迹超限/自修改代码/CPUID 切换 | 循环变大、含不可重放指令 |
LSD 的门槛最苛刻。它要求循环体(含全部迭代共享的 uop 流)能整个塞进 IDQ——Nehalem 时代是 28 uop,Sandy Bridge 合并到 DSB 体系后 LSD 一度被取消,Haswell 又恢复,现代核一般能容纳几十到上百 uop 的循环。循环里一旦混入微码协助的指令(复杂字符串操作、某些 rep 前缀指令见 microcode-rom-assist-decode),整条迭代就不配重放。
DSB 的门槛是「代码足迹」。DSB 按 32 字节代码窗口组织,每个窗口最多容纳 18 个 uop(Skylake 口径),一个宏融合对占一行。热点函数加起来超过几千 uop,就开始互相驱逐,命中率随之下滑——这正是「代码膨胀」在前端层面的直接代价。
MITE 是兜底:冷代码、DSB 未命中、被 LSD 拒绝的循环,全部回到这条最贵也最不挑的路。
三、切换的动态细节:惩罚、抖动与边界形态
三条路之间的切换不是免费的。DSB 命中流与 MITE 译码流在 IDQ 入口合流时,硬件需要先排空当前供给源、再接入新源,这个交接窗口就是 DSB2MITE_SWITCHES.PENALTY_CYCLES 度量的几个周期的空泡。单次惩罚很小,问题出在频率:如果热点代码的布局让 DSB 行反复被驱逐又填回,或者一个循环恰好大到 LSD 吃不下、又小到在 DSB 边界来回横跳,惩罚就会乘上一个巨大的次数。
两类典型的「边界形态」值得记住。第一类是循环体恰好超界:循环 uop 数比 IDQ 容量多那么十几个,LSD 拒绝,DSB 能装但每次进出循环都要切换供给源,性能曲线在循环体积跨过阈值的那个点上会出现一个明显台阶——不少团队做 benchmark 时见过「循环加两条语句性能掉 8%」的现象,根源常在这里。第二类是热点函数交错布局:A、B 两个函数在地址空间上穿插,各自单独跑都能 DSB 高命中,交替跑就互相驱逐——前端版的工作集超限,与 cache 冲突的思路完全同构。
还有一个容易忽略的事实:SMT 双线程共享 DSB 与 IDQ(Skylake 之后 DSB 按线程静态或动态分区,代际间有差异)。两个逻辑核各跑一个热点循环时,等效 DSB 容量对每线程近乎减半,本来能进 LSD/DSB 的循环可能被挤回 MITE——解释「同进程绑两个 HT 就慢、绑两个物理核就快」时,除了执行端口争抢,前端供给源的瓜分也是标准嫌疑之一。
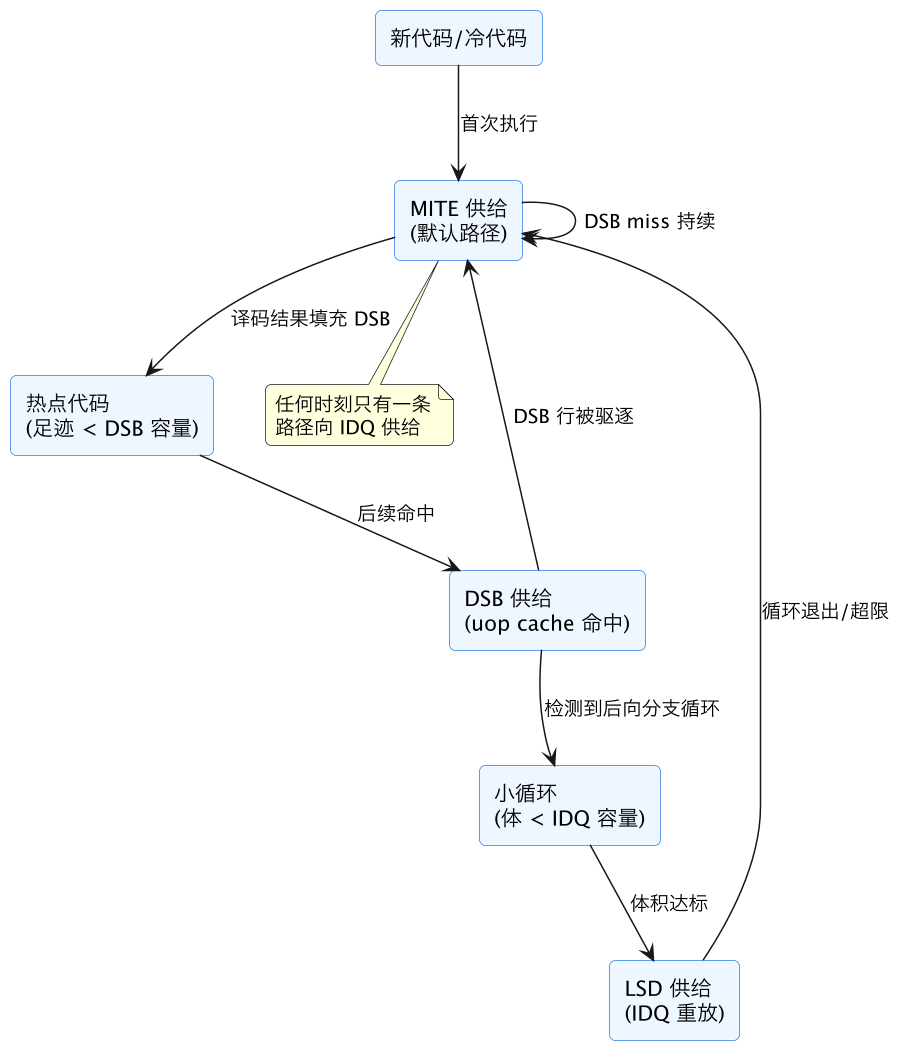
这个状态机是理解 PMU 数据的钥匙:一次执行里同一段代码会在状态间迁移,所以观测到的永远是「各源交付 uop 的占比」,而不是非黑即白的单一路径。
再补充几个容易踩空的细节。DSB 不是「译码了就一定能进」:跨越 32 字节窗口的指令、带某些前缀组合的指令、uop 数超过单窗口上限的密集代码段,都会导致对应窗口无法入缓存,这些代码永远走 MITE。自修改代码(JIT 改写已填充的窗口)会让 DSB 行失效,高频 JIT 场景(某些 JVM 热替换、动态代码生成器)的 DSB 命中率天然偏低,这类负载看 mite_uops 占比高不必惊慌,它是结构性的。另外,CPUID 变化(上下文切换跨到不同 stepping 的核,虚拟化迁移的常见场景)会清空 DSB,相当于每条路径重新热身——容器环境里偶发的性能毛刺,有一部分能追溯到这种「隐形冷启动」。
四、带宽差异:为什么切换值得关心
三条路的差距体现在两个地方:稳态带宽和延迟平滑度。
MITE 路径的痛点不只是 4-5 uop/周期的标称带宽,而是它的抖动:16 字节取指窗口对不齐(分支目标落在窗口中后段)、变长指令恰好跨窗口、前缀串拉长单条指令译码,都会让实际交付跌到 2-3 uop/周期。DSB 命中则不同——uop 已经按执行顺序排好在行里,一行就是一拍,交付既宽又稳。Golden Cove 把 DSB 交付提到 8 uop/周期,几乎追平重命名宽度,此时后端能不能吃掉反而成了新问题。
LSD 的收益更偏「能效+稳定」:循环在 IDQ 内重放时,取指、译码、DSB 整段可以时钟门控(见 microarch-clock-power-gating),功耗下降,且完全不受分支预测之外的任何取指扰动影响。
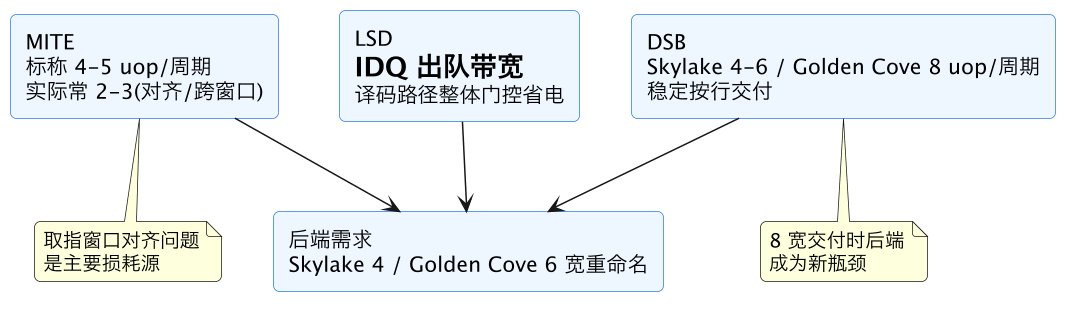
量级的直观感受:一个每周期能 retire 4 uop 的循环,如果被迫从 MITE 供给且平均只拿到 2.5 uop/周期,前端就是硬瓶颈,IPC 直接腰斩;切到 DSB/LSD 后前端带宽富余,瓶颈让位给执行端口(见 execution-port-contention)。同一二进制、同一数据,只因为热点代码布局变了导致 DSB 命中率变化,性能波动 5-10% 是实测里反复出现的数字。
五、PMU 观测:热点分布与切换证据
Intel PMU 直接按供给源拆账,核心是一组 IDQ_UOPS_NOT_DELIVERED 与 uop 交付计数事件:
| PMU 事件 | 含义 | 用法 |
|---|---|---|
IDQ.DSB_UOPS | DSB 交付的 uop 数 | 占比 = DSB_uops / 总交付 |
IDQ.MITE_UOPS | MITE 交付的 uop 数 | 占比高 = 冷代码或 DSB 驱逐 |
IDQ.MS_UOPS | 微码 ROM 交付 | 高占比警惕微码协助 |
LSD.UOPS | LSD 重放的 uop 数 | 循环负载的健康度 |
DSB2MITE_SWITCHES.COUNT / PENALTY_CYCLES | DSB→MITE 切换次数与惩罚周期 | 切换抖动的直接证据 |
IDQ_UOPS_NOT_DELIVERED.CORE | 后端要但前端没给的周期 | Topdown FE Bound 的原始事件 |
FRONTEND_RETIRED.DSB_MISS 等 | 按供给源细分的退休统计 | Icelake 后更细的口径 |
按 topdown-analysis-methodology 的口径,FE Bound 高之后就该拆这组事件:如果 DSB2MITE_SWITCHES.PENALTY_CYCLES 占总周期 5% 以上,说明热点在两条路径间反复横跳——典型原因是循环体恰好卡在 DSB/LSD 容量边界上,每次切换都要付几个周期的切换惩罚。
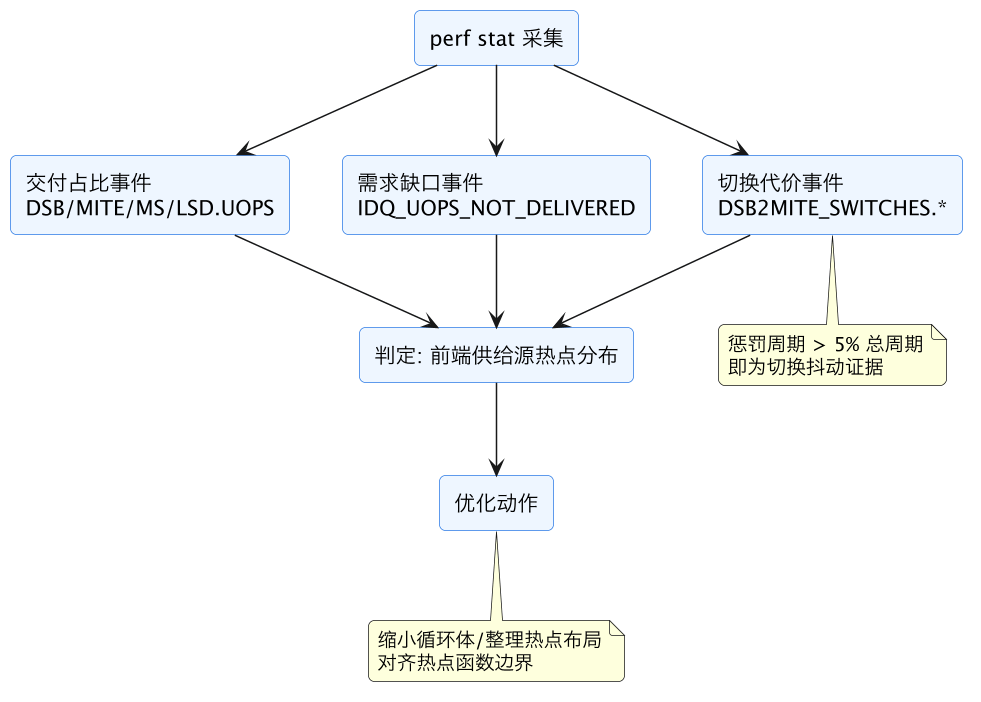
一个实战读数组合:perf stat -e cycles,instructions,idq.dsb_uops,idq.mite_uops,lsd.uops,dsb2mite_switches.penalty_cycles ./app。计算 DSB 覆盖率 = dsb_uops/(dsb_uops+mite_uops),循环型负载健康值应在 90% 以上、且 lsd.uops 占大头;MITE 占比超过 20% 就说明相当一部分执行时间在走最贵的那条路。
再给一个代际视角:三条路径的容量阈值随微架构逐代放宽,所以「同样形态的热点在不同代 CPU 上落在不同供给源」是常态,做跨代性能对比时要先想这层。
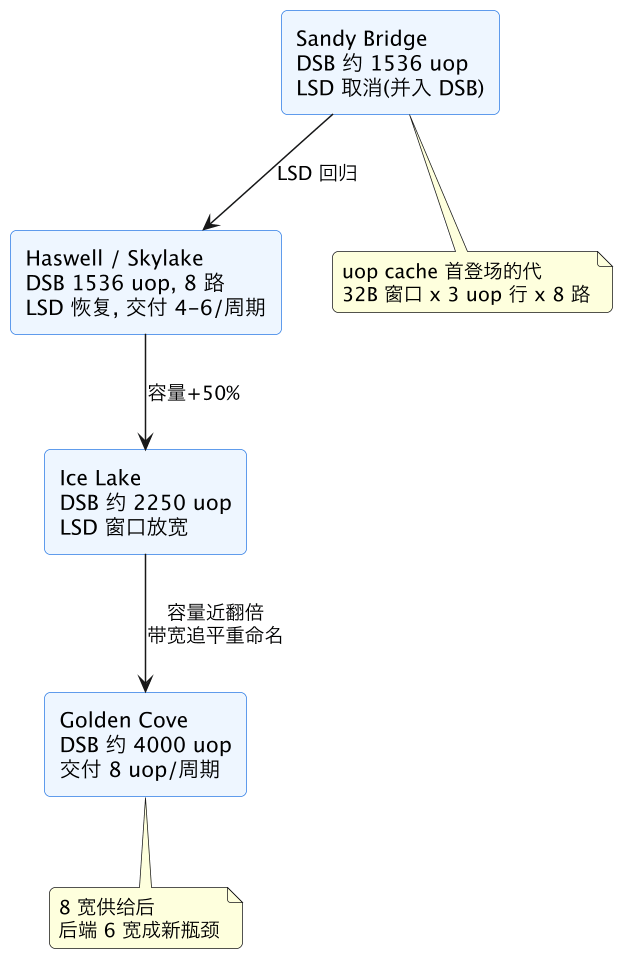
这张图的读法:越新的核,「能被快路径接住」的代码体积上限越大,MITE 兜底的占比天然下降;反之,在老核上调优过的循环体积阈值(比如卡着 Skylake 的 1536 uop 做布局),搬到新核上不必再那么苛刻,但 LSD 对小循环的偏好始终成立——「循环做小」这条原则跨代不过时。
看一个完整的排查实例。某服务升级后 IPC 从 2.8 掉到 2.4,Topdown 显示 FE Bound 从 8% 涨到 19%。拆供给源:mite_uops 占比从 6% 升到 31%,dsb2mite_switches.penalty_cycles 占总周期 7%——典型的切换抖动。perf record 配合注释定位到一个新增的热路径校验函数:它被内联进了三个调用点,把原本紧凑的循环体撑过了 IDQ 容量线,LSD 拒绝重放,DSB 行又与相邻热点互踢。解法不是删校验,而是加 noinline 把它收成一个独立小函数:循环体瘦回 LSD 容量内,校验函数本身走 DSB 也绰绰有余。改完 MITE 占比回到 5%,IPC 恢复。这个案例说明:DSB/LSD 问题的修法往往不是「让代码更快」,而是「让代码的形状更合三条路径的胃口」。
六、工程启示:怎么让代码对切换友好
落到写代码与调优上,几条可操作的原则:
- 热点循环做小做整。循环体控制在几十 uop 以内、避免混入微码协助指令,让它能进 LSD;这是收益最大也最便宜的一招。
- 热点代码聚合布局。把热函数放到相邻地址(链接期 hot/cold 分离、PGO 的 function reordering),提高 DSB 有效容量利用率——无关冷代码不占 uop cache 行。
- 警惕「恰好超界」。函数体略超 DSB 行容量、循环体略超 IDQ,是最差的形态:每次执行都在切换惩罚里打转。宁可拆成两个干净的循环,也不要一个卡在边界上的大循环。
- 对齐不是玄学。32 字节窗口边界的分支目标对齐,影响 MITE 取指窗口利用率与 DSB 行数;现代编译器
-falign-loops的价值就在前端这层。 - 宏融合别浪费。
cmp+ja这类可宏融合对(见 macro-fusion-micro-fusion)在 DSB 里只占一个行槽位,等于白送的容量。
需要提醒的是,DSB/LSD 切换本身不是你能在代码里直接控制的东西——它是硬件策略,你能做的只是塑造代码形态,让切换的收敛方向对你有利。
最后给一个判断顺序,遇到前端瓶颈时按它走一遍:先 Topdown 确认 FE Bound 是否显著;显著则拆 DSB/MITE/LSD 三源占比定位「贵路径」占比;再看 DSB2MITE_SWITCHES.PENALTY_CYCLES 判断是否有切换抖动;最后用采样找到具体的热函数,对照容量阈值(DSB 容量、IDQ 大小、32B 窗口密度)判断它卡在哪条边界上。这个顺序把「前端慢」从一句笼统的结论,变成「某段代码从某条路径被挤到了另一条路径」的可操作陈述。
这一篇在知识体系里的位置
本篇属于前端流水线专题:全景见 cpu-frontend-pipeline-panorama,DSB 细节见 uop-cache-decode-frontend,LSD 细节见 loop-stream-detector-lsd;上游取指侧的代价见 fetch-taken-branch-bubble 与 itlb-miss-frontend-stall,观测方法论见 topdown-analysis-methodology 与 perf-counter-pmu-programming。DSB/LSD 切换正是串起这一切的枢纽:它决定了前端三条路里,你的代码最终从哪条路拿到 uop。
总结
DSB/LSD 切换是 Intel 前端在 MITE(贵而通用)、DSB/uop cache(宽而稳,受代码足迹约束)、LSD(循环短路,省电且最稳,受循环体积约束)三条供给路径间按代码形态动态接力的机制;用 IDQ.DSB/MITE_UOPS、LSD.UOPS、DSB2MITE_SWITCHES.PENALTY_CYCLES 这组事件就能看到热点分布与切换代价,而把循环做小、热点代码聚合布局,是让切换收敛到快路径的最有效手段。