CLDEMOTE 指令:缓存行层次降级提示与生产者-消费者加速
承 缓存一致性协议 MESI/MOESIF 对缓存状态机的讲解,以及 CLFLUSHOPT/CLWB 持久内存冲刷 对「把缓存行往外赶」一族指令的梳理。那一族指令解决的是持久化与内存回收问题,而本篇的主角 CLDEMOTE 指令解决的是另一个方向的效率问题:数据我已经写完了、短期内不会再碰,能不能主动把它从私有缓存下放到共享的 LLC,让别的核少绕路?
本文要回答的问题
- CLDEMOTE 指令的「降级(demote)」到底把缓存行搬到了哪一层?状态怎么变?
- 它和 CLFLUSHOPT、CLWB 这些「往外赶」的指令有什么本质区别?
- 为什么生产者-消费者场景能从中获益?收益量级有多大?
- 硬件与编译器支持现状如何?代码里怎么写?
- 哪些场景不适合用,用错了会发生什么?
一、CLDEMOTE 指令的降级语义
先看它要解决的路径问题。核 A 写了一条缓存行,这行待在 A 的 L1/L2 里处于 Modified 状态。稍后核 B 要读它,按 MESI 协议,B 的读请求会触发一次核间传输:数据从 A 的 L2(甚至 L1)被「偷」出来送到 B,A 侧状态降级。这次核间传输(core-to-core transfer)在现代服务器上大约 60-110 个周期,比直接命中 LLC 的 40-70 周期明显更贵,而且两核离得越远(跨 CCX、跨 tile、跨 socket)越贵。
CLDEMOTE 的思路是:A 写完之后、B 来读之前,先发一条提示指令,把这行从 A 的 L1/L2 下放到 LLC——数据仍留在片上共享缓存里,只是不再占用私有层级。等 B 来读时,请求在 LLC 就命中了,省掉核间传输那一段。这就是「demote(降级)」的全部含义:层次下移,但不离开缓存体系,更不写回内存。
状态变化上,CLDEMOTE 通常把私有缓存里的该行置为无效(Invalid),在 LLC 中保留一份(Modified 或 Shared 取决于实现)。它是提示(hint)不是命令——硬件可以忽略它,比如在私有缓存压力很小时不执行降级;也不保证同步完成,效果有延迟。
这张图的核心对照是两条供数路径:没有 CLDEMOTE 时走「核 A 私有缓存 → 核间传输 → 核 B」的弯路;有了 CLDEMOTE 则提前走「核 A → LLC」的直路,核 B 读时一次 LLC 命中解决。注意图中 LLC 到 DRAM 的箭头只在将来容量回收时才发生——降级和写回内存是两回事。
二、与 CLFLUSHOPT、CLWB 的本质区别
三条指令都在「把缓存行往外赶」,但目的地和用途完全不同,混淆它们是新手最常见的误解。
| 维度 | CLDEMOTE | CLFLUSHOPT | CLWB |
|---|---|---|---|
| 行的终点 | LLC(仍在缓存里) | 内存(彻底逐出) | 内存(写回但可留在缓存) |
| 之后访问该行 | LLC 命中,快 | 走 DRAM,慢一个量级 | 缓存命中(若未被逐出) |
| 主要用途 | 加速跨核共享 | 持久化 / 回收缓存容量 | 持久内存写回 |
| 数据是否会丢 | 不会(掉电除外,同普通缓存) | 到达持久域才算稳 | 到达持久域才算稳 |
| 典型场景 | 生产者-消费者队列 | pmem flush、内存压力大时让位 | pmem 日志刷盘 |
一句话:CLDEMOTE 是为别的核让路,CLFLUSHOPT/CLWB 是为持久化和容量服务(详见 CLFLUSHOPT/CLWB 持久内存冲刷)。把 CLDEMOTE 当成「轻量版 flush」用在需要持久化的数据上是错的——它不提供任何持久性保证。
三、生产者-消费者场景的收益
最典型的受益者是单生产者-单消费者队列(SPSC ring buffer),这是网络收发包、日志管线、线程间任务分发的骨干结构。生产者核填完一个槽位、更新尾指针后,这个槽位的数据它短期内不会再读——完美的 demote 时机。
不带 CLDEMOTE 时,消费者核每消费一格都要付一次核间传输的代价。带上 CLDEMOTE,数据提前躺进 LLC,消费者的首次读直接 LLC 命中。Intel 官方与第三方实测显示,这类场景下单次交接延迟可降约 20-40%,队列吞吐在交接密集的负载下提升 10-30%;跨 socket 的生产者-消费者对收益最大,因为省掉的那段核间传输本来最贵。
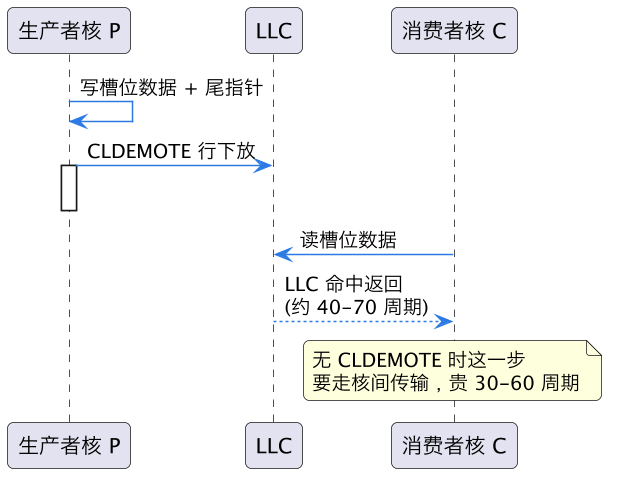
这张时序图把因果讲清楚了:CLDEMOTE 的代价由生产者提前付(一次 hint 指令,几乎免费),收益由消费者在「读」那一刻兑现。它本质上是一次跨核的预取——只不过预取的方向是把数据推向共享层,而不是拉进自己。
落到代码里的样子很直白:生产者线程写完槽位的 64 字节(或若干行)后,对每个行地址发一次 __builtin_ia32_cldemote,然后执行 release 语义的尾指针发布。顺序上 demote 在指针发布之前即可,因为它是数据面的提示,不参与可见性排序——真正的可见性保证仍由 release/acquire 配对提供,CLDEMOTE 管的是「供数走哪条路」这条性能维度,不管内存序。
四、硬件与编程现状
CLDEMOTE 随 Sapphire Rapids(2023)进入主流服务器 CPU,CPUID 有独立特性位,Linux 的 /proc/cpuinfo flags 里能看到 cldemote。GCC 11+ 提供 __builtin_ia32_cldemote(ptr) 内建函数,也可以用 _cldemote 或内联汇编;编译时加 -mcldemote 或 -march=sapphirerapids。
使用前提有三条:先在运行时检测 CPUID 再发指令(老机器上会 #UD,未检测就内联汇编等于埋随机崩溃);生产者在写完数据、发布指针(release 语义)之后发 demote;只对未来不被本核再访问的行使用。库层面,DPDK 等高频框架已开始引入类似 hint;应用层手写时建议封装成带特性检测的小函数,检测失败时退化为空操作,同一份代码就能跨新老机器部署。
还有一个部署上的现实提醒:虚拟化环境大多透传这条指令,但个别云机型会屏蔽较新的特性位,迁移机型后最好重新确认 /proc/cpuinfo 里的标志还在,别让「悄悄失效的优化」混进性能回归排查里。
五、什么时候别用
三种情况 CLDEMOTE 反而帮倒忙。一是生产者很快还要再读这行(比如写后校验、就地累加的统计变量)——降级后本核再读就要多跑一趟 LLC,约多花 20-40 周期,纯亏。二是多消费者广播场景:第一个消费者读完后行还在 LLC 没问题,但如果消费者们本来会依次从某个核的私有缓存取数,demote 的收益会被摊薄。三是行级乒乓严重的假共享区域——对乒乓行乱发 demote 只会增加私有缓存的 miss 次数,徒添流量。经验法则:只在「写一次、移交、不再碰」的交接点用,每次一个明确的缓存行,别批量乱发。
最后强调测量:CLDEMOTE 是提示指令,硬件可忽略,收益与拓扑强相关。上生产前用 perf 对比 LLC-load-misses 与交接延迟分布,确认在你这台机器、这个拓扑上确实兑现,再常驻。
这一篇在知识体系里的位置
本篇是缓存提示指令家族的成员,与 CLFLUSHOPT/CLWB 持久内存冲刷(往外赶到内存)和 MOVDIRI/MOVDIR64B 直接存储(绕开缓存直接写)构成「缓存行生命周期干预」三件套;状态语义见 缓存一致性协议 MESI/MOESIF。
总结
CLDEMOTE 指令把写完即移交的缓存行从私有 L1/L2 提前下放到共享 LLC,让跨核消费者的一次 LLC 命中取代昂贵的核间传输;它只管层次降级、不做持久化,与 CLFLUSHOPT/CLWB 分工不同——在单生产者-单消费者队列这类「写一次、不再碰」的交接点上,它能砍掉两三成的交接延迟,用错地方则纯亏。