VIPT 重名问题:索引超出页内偏移后,同一份数据怎么在 L1 里出现两份
承 cache-organization-addressing——那一篇把 VIVT / VIPT / PIPT 三种寻址方式摆在一起对比,VIPT 只分到一段。本篇把镜头只对准 VIPT(Virtually Indexed, Physically Tagged,虚拟索引物理标签)这一个主流方案:它凭什么成为几乎所有现代 CPU L1 的选择,又在什么条件下踩进 VIPT 重名问题(synonym,也叫 aliasing,缓存别名) 的坑。替换策略见 cache-replacement-policies-lru,TLB 侧见 tlb-pagewalk-cache,本篇不重复。
本文要回答的问题
- VIPT 为什么能鱼和熊掌兼得:像虚拟索引一样快、像物理标签一样不用刷缓存?
- "索引位超出页内偏移"到底指什么,为什么这是 synonym 的触发条件?
- 两个不同虚拟地址映射到同一物理页时,L1 里怎么就会出现两份副本,危害有多大?
- L1 容量、组相联路数、页大小三者之间那条"安全线"怎么算?
- 软件 page coloring 和硬件 synonym 探测两条路各自怎么解围,现代 CPU 选了哪条?
一、VIPT 为什么成为 L1 的主流:一拍干两件事
缓存寻址方式的选择,本质是在回答一个问题:拿虚拟地址找缓存行,还是拿物理地址找?
纯虚拟寻址(VIVT)最快——省掉 TLB,但进程切换后虚拟地址含义全变,缓存必须整片刷掉,还要给每个条目加 ASID(地址空间标识)区分主人,别名问题也最严重。纯物理寻址(PIPT)最干净——物理地址全局唯一,但必须先过 TLB 翻译才能开始查缓存,L1 命中延迟被 TLB 拖长一拍甚至更多。
VIPT 走的是折中路线,利用了一个关键观察:虚拟地址的低位(页内偏移)在翻译前后是不变的。4KB 页下,虚拟地址 bit[11:0] 就是物理地址 bit[11:0]。于是:
- 用虚拟地址的低位立刻索引 SRAM 组——这一拍不用等 TLB;
- 同一拍,虚拟地址的高位送进 TLB 做翻译;
- 下一拍,TLB 吐出物理页号,和索引选出来的那几路的 tag(存的是物理地址高位)比对,命中即返回数据。
索引和翻译是并行的,L1 命中延迟里 TLB 被藏掉了。这就是 VIPT 的立身之本。
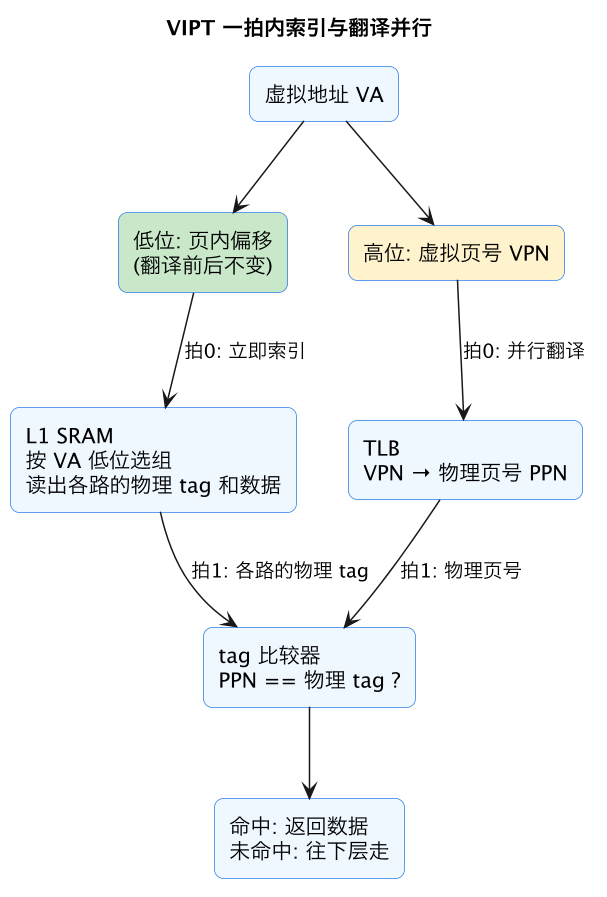
这张图的核心是两条并行的箭头:低位走 SRAM、高位走 TLB,谁也不等谁。但请注意一个隐含前提——这张图能成立,是因为索引用的位全部落在"翻译前后不变"的区间内。一旦索引需要用到更高的位,平行世界就裂开了,这就是下一节的主题。
二、触发条件:索引位超出页内偏移
缓存需要的索引位数由三个参数决定:
索引位数 = log2(缓存容量 / (路数 × 行大小))以 4KB 页(页内偏移 12 位)、64 字节行(行内偏移 6 位)为例,组索引可用的"安全位"只有 bit[11:6],共 6 位,即最多 64 组。如果缓存被设计成超过 64 组 × 路数 × 64B 的容量,索引就必须借用 bit[12] 甚至更高——这些位属于虚拟页号,翻译前后会变。
借用之后会发生什么?同一物理页可以被多个虚拟页映射(共享库、共享内存、mmap 同一文件)。虚拟页 A 的 bit[12]=0,虚拟页 B 的 bit[12]=1,它们指向同一物理地址,但用各自的虚拟地址索引时落进不同的组。于是同一物理地址的数据,在 L1 里可能同时存在两份(甚至更多份)副本——这就是 VIPT 重名问题。
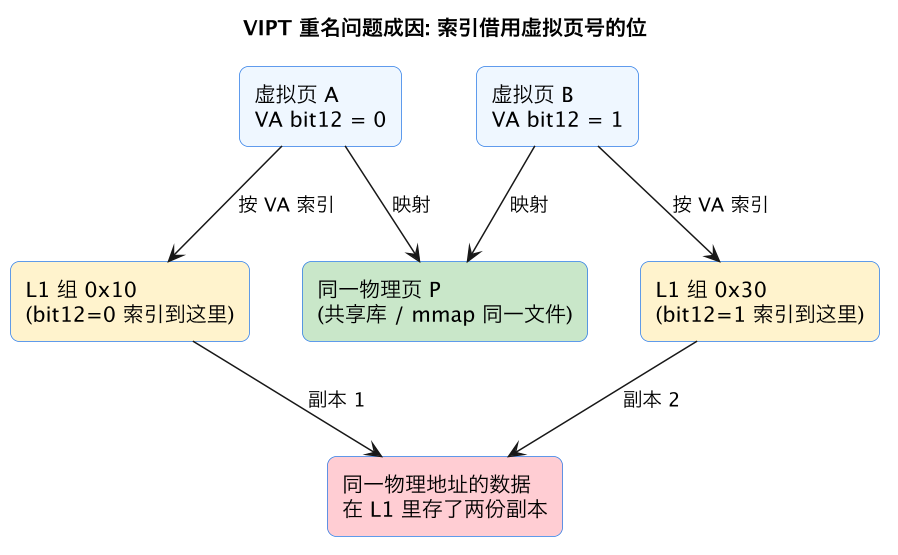
看图说话:tag 比较环节用的是物理地址,两个副本的物理 tag 其实相同,但它们躺在不同的组里——硬件按虚拟地址索引时只看一个组,根本不知道另一个组里还有个孪生兄弟。tag 一致反而让问题更隐蔽:普通 miss 至少会暴露自己,synonym 是"查也查得中、改也改得对,但改的不是唯一那份"。
三、两份副本的危害:从脏数据到一致性破功
有人可能觉得:多读一份副本而已,反正读出来是一样的。问题出在写。
- 写穿一份、读中另一份:CPU 通过虚拟页 A 写入,副本 1 被更新(write-back 下只有副本 1 变脏);稍后另一段代码通过虚拟页 B 读同一物理地址,命中副本 2——拿到的是旧值。这在共享库全局变量、用户态与内核映射同页(如 vDSO、
MAP_SHARED)场景下是真会咬人的。 - DMA 与自修改代码:设备 DMA 改写内存后,缓存按物理地址做一致性失效;如果失效逻辑只扫了"该物理地址可能出现的一个组",另一组里的过期副本照样存活。
- 指令缓存同名:自修改代码通过数据别名写入、又通过另一别名取指,I-Cache 里的旧指令副本会让 CPU 执行到天外去。
历史上 VIVT 时代(早期 MIPS、ARM9 之前的一些核)别名是家常便饭,操作系统被折磨得够呛:System V ABI 甚至规定共享映射的虚拟地址必须满足"同余约束"(各映射地址对某个对齐值取模相等),等于把缓存组索引的位预先对齐,从软件侧绕开硬件缺陷。VIPT 把问题面收窄了,但只要索引越位,坑还在原地。
| 场景 | 是否触发 synonym | 后果 |
|---|---|---|
| 单进程私有映射,一个物理页只有一个虚拟名 | 否 | 无副本,天然安全 |
| 共享库被多进程映射(物理页共享) | 索引越位时可能 | 跨进程写入可见性出错 |
| 内核线性映射 + 用户映射同页 | 索引越位时可能 | 内核写、用户读到旧值 |
mmap 同一文件两次到不同 VA | 索引越位时可能 | 两个视图数据漂移 |
| 自修改代码 / JIT 写后执行 | I-Cache 别名时 | 执行过期指令 |
四、安全线:L1 容量、路数、页大小的三角约束
把触发条件翻过来写,就得到那条著名的安全线:
缓存容量 / 路数 ≤ 页大小 ⟹ 索引位全部落在页内偏移里 ⟹ 无 synonym道理很直白:每一路的大小(容量除以路数)不超过一页时,选组需要的位数就超不出页内偏移。4KB 页、64 字节行的条件下:4 路组相联的 L1 最多 16KB 安全,8 路最多 32KB 安全,16 路最多 64KB 安全。看一眼真实产品就明白这条线在如何塑造硬件:
| 微架构 | L1D 容量 / 路数 | 每路大小 | 4KB 页下是否安全 | 应对 |
|---|---|---|---|---|
| Intel Sandy Bridge | 32KB / 8 路 | 4KB | 恰好压线 | 无需处理 |
| Intel Skylake~Golden Cove | 48KB / 12 路 | 4KB | 恰好压线 | 靠提高路数扩容 |
| Intel Golden Cove(部分) | 48KB / 12 路 | 4KB | 压线 | 同上 |
| AMD Zen 2 | 32KB / 8 路 | 4KB | 恰好压线 | 无需处理 |
| AMD Zen 4 | 32KB / 8 路 | 4KB | 恰好压线 | 无需处理 |
| 假想 64KB / 8 路 @ 4KB 页 | 64KB / 8 路 | 8KB | 越位 1 位 | 必须 coloring 或硬件探测 |
观察这张表能发现一个耐人寻味的现象:x86 阵营的 L1D 容量在 32KB~48KB 上"卡"了很多代,不是 SRAM 做不大,而是每路 4KB 这条天花板把容量锁死了——想扩容只能拼命加路数(8 路到 12 路),而路数增加意味着命中判定要并行比较更多 tag、功耗和延迟都在涨。Apple 和高通的 ARM 核敢上 128KB 甚至 192KB L1,底气之一是 ARM 生态更常跑 16KB 页,每路上限跟着放大四倍。页大小不是操作系统的一个抽象参数,它直接给 L1 容量封顶——这是 VIPT 重名问题送给整个硬件设计的最硬约束。
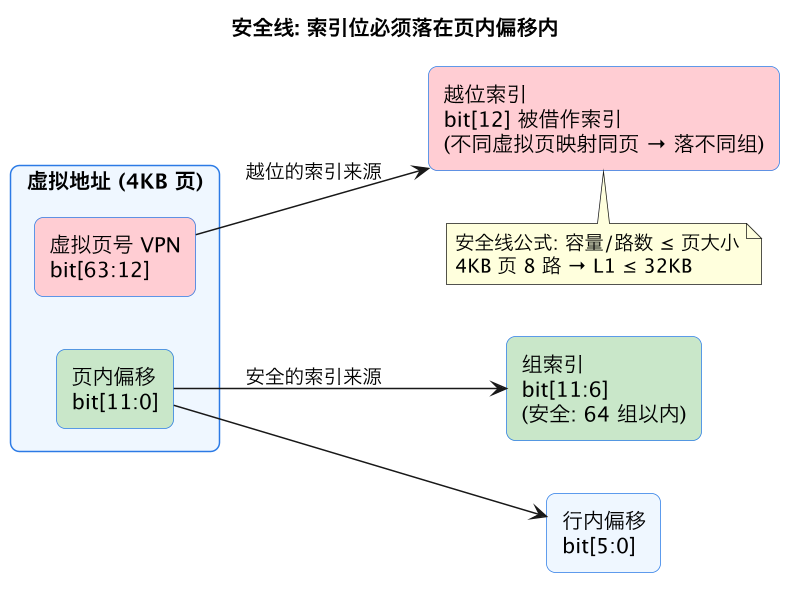
这张图把安全线画在地址比特上:绿色区是"翻译前后不变"的页内偏移,索引从这里取材就永远安全;红色区是虚拟页号,索引一伸手过去,synonym 的门就开了。下面注释里的公式就是硬件设计师排布 L1 规格时第一道算术题。
五、两类解法:page coloring 与硬件 synonym 探测
实在想要"每路超过一页"的大 L1(或者页大小改不了、容量必须涨),就得正面解决 synonym。路线有两条。
路线一:软件 page coloring(页着色)。思路是让操作系统在分配物理页时"挑颜色":颜色 = 物理页号里"会被借作索引的那几位"的取值。保证同一物理页的所有虚拟映射在这些位上取值一致——既然索引位大家都一样,虚拟地址 A 和 B 自然落进同一个组,两份副本变回一份,问题从根上消失。
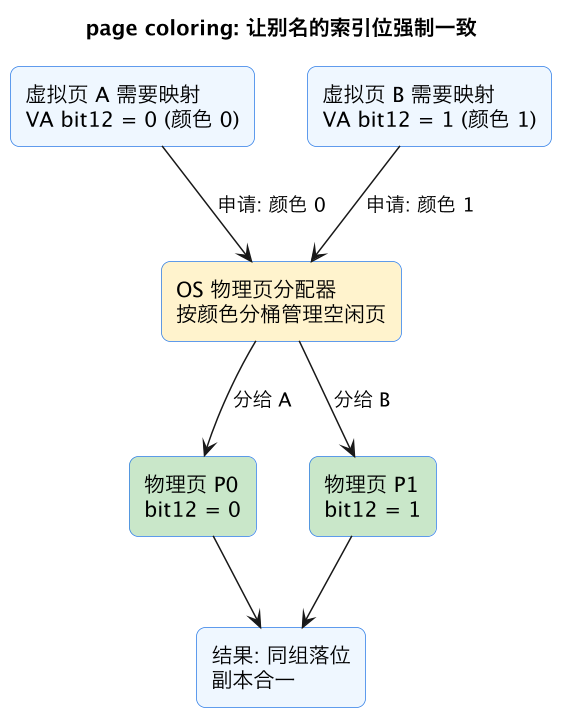
page coloring 零硬件成本,还能顺带当缓存分区手段用(把不同应用的页分到不同颜色,减少互相挤占,见 page-coloring-cache-partition)。代价全在 OS 侧:分配器要维护按颜色分桶的空闲链表,大页/透明大页与着色策略互相打架,内存紧张时可能出现"有页但颜色不对"的分配失败,共享映射场景还要所有映射方颜色协调一致。FreeBSD、Solaris 历史上都实装过着色;Linux 主流没有上全局着色,靠的是另一条路。
路线二:硬件 synonym 探测(synonym detection / L1 反向探测)。思路是让缓存硬件在 miss 时多走一步:用物理地址把"所有可能藏有别名的组"都查一遍(越位几位就多查 2^n 个组,1 位越位查 2 组)。发现别名副本后,要么直接返回它、要么把它失效/迁移到正确组。写入时同理,把所有候选组里的同 tag 副本一起更新或失效。这本质上是把 PIPT 的确定性"补"回 VIPT——VIPT 前台快,后台悄悄做别名清理。
| 维度 | page coloring(软件) | 硬件 synonym 探测 |
|---|---|---|
| 硬件成本 | 零 | miss/写路径多查 2^n 组,功耗与复杂度过账 |
| 软件成本 | 分配器改造、大页协调、共享映射约束 | 零 |
| 对 L1 命中最快路径 | 无影响 | 无影响(探测走慢路径) |
| 扩容自由度 | 颜色数=页数分桶,桶多时碎片 | 越位位数越大探测越贵,一般只容忍 1~2 位 |
| 典型采用者 | 历史 BSD 系、部分嵌入式 OS | 现代大 L1 设计(ARM 服务器核、部分 IBM/Apple 核) |
两条路线不互斥,也有"大页治本"的第三视角:页从 4KB 升到 2MB,页内偏移从 12 位变 21 位,每路上限从 4KB 变 2MB——任何现实容量的 L1 都稳稳在线内。这就是为什么支持大页的机器上 synonym 几乎从运维视野里消失;坑留给跑 4KB 小页又配大 L1 的组合。页表与翻译侧的细节见 page-table-translation 与 tlb。
六、对性能分析者的实战意义
VIPT 重名问题对应用开发者多数时候是"知道即可"的底层知识,但有几个场合它会浮出水面:
- 评估异构平台:同一份代码从 x86(L1D 32~48KB)搬到 ARM 服务器核(L1D 64KB 配 4KB 页)时,L1 行为差异有一部分就来自 synonym 处理路径的额外开销与 OS 策略,别只盯着容量数字对比。
- 共享内存性能异常:两个进程通过
shm/mmap共享一页做高频通信,若发现写入后另一视角读延迟异常或值漂移,且平台是"大 L1 + 小页"组合,把 synonym 列入怀疑清单,用getconf PAGE_SIZE确认页大小、对照 L1 容量/路数算一遍安全线。 - 自行设计 SoC / 评估 IP 核:L1 规格评审时第一道算术就是安全线公式;越位方案必须写明走 coloring 还是硬件探测,否则一致性模型就是漏的。缓存组织的更完整背景见 cache-organization-access 与 cache-organization-mapping,片上大容量 LLC 的另一套别名问题(非均匀切片寻址)见 llc-slicing-complex-addressing。
一句话记住这个三角:页大小给页内偏移定界,路数给每路容量定界,索引位数不许越界——三者凑不齐,synonym 就进门。
这一篇在知识体系里的位置
本篇是缓存组织"寻址方式"专题里 VIPT 路线的纵深篇:
- 上游总览:cache-organization-addressing 的 VIVT/VIPT/PIPT 三方案对比是本篇的入口;cache-organization-access 讲一次缓存访问的完整流水线。
- 同层伙伴:cache-replacement-policies-lru 讲组内条目怎么换进换出,与本篇"组怎么被选中"互补;chip-design 视角的 cache-organization-replacement 从硬件实现侧看同一问题。
- 翻译一侧:tlb-pagewalk-cache 讲 VIPT 里那条并行的 TLB 通路内部结构;page-table-translation 与 tlb 讲页表与翻译全过程。
- 下游应用:page-coloring-cache-partition 把着色从"避坑手段"升级为"缓存分区手段";llc-slicing-complex-addressing 讨论 LLC 层面另一类地址散列与别名问题。
总结
VIPT 重名问题(synonym)的根源是索引位借用了虚拟页号:当 L1 每路容量超过页大小时,映射到同一物理页的不同虚拟页会被索引进不同的组,同一数据在缓存里存出多份副本,写穿一份、读中另一份就是脏数据;安全线公式"容量/路数 ≤ 页大小"锁死了 4KB 页下 L1 的容量天花板,解法只有两条——软件 page coloring 让别名的索引位强制一致,或硬件 synonym 探测在慢路径上多查几组清理副本,而 x86 多年不涨 L1D、ARM 靠大页放开容量,背后都是这同一条约束。