UCIe 芯粒接口:物理层与协议层结构、封装档位与私有 die-to-die 接口的定位对比
更新时间:2026-10-05。单芯片时代的 SoC 内部互连靠片上总线和 NoC(Network-on-Chip,片上网络),信号从不离开硅片;芯粒(chiplet)时代,一个封装里要塞下计算 die、IO die、HBM 内存堆栈,die 与 die 之间的互连第一次变成了「跨硅片的高速总线」。这片灰色地带长期被各家私有方案占据——Intel 的 EMIB/AIB、AMD 的 Infinity Fabric on-package、台积电的 LIPINCON——互不兼容,直接后果是小厂想用别人的 chiplet 根本没有公共语言。UCIe(Universal Chiplet Interconnect Express,通用芯粒互连标准)就是为解决这件事而生的开放规范。芯粒间还要跑缓存一致性流量的大背景见 芯粒多 die 缓存一致性,die 内部互连结构见 Uncore 环形与 Mesh 互连。本篇讲透 UCIe 的物理层/协议层分层结构、标准封装与先进封装两档规格的工程取舍,以及它相对私有 die-to-die 接口到底赢在哪、输在哪。
本文要回答的问题
- UCIe 芯粒接口为什么要分层?物理层、适配层、协议层各自干什么?
- standard 封装档与 advanced 封装档差在哪?bump 间距、带宽密度、成本各是多少?
- UCIe 链路怎么训练起来?sideband 通道在干什么?
- PCIe 与 CXL 事务是怎么「原生」跑在 UCIe 上的?延迟代价多大?
- 与 AMD Infinity Fabric、Intel EMIB/AIB 这类私有接口比,UCIe 的定位是什么?什么时候仍该用私有方案?
一、为什么需要 UCIe:die-to-die 互连的「巴别塔问题」
把一颗大芯片拆成多个芯粒的动机已经算过账:大 die 良率随面积指数下降,先进工艺节点每平方毫米成本高企,把 IO 这类不随工艺缩放的逻辑留在成熟节点、只把计算核心放先进节点,成本和良率双赢。但拆完之后,die 之间要说话,而 die-to-die 链路和板级互连(PCIe over PCB)完全是两个世界:距离只有几毫米、走线在封装基板或硅中介层上、功耗预算是每比特不到 1 皮焦的量级(板级 SerDes 是 5 到 10 皮焦/比特),误码率要求却同样苛刻。
在 UCIe 出现之前,每家公司都自己定义这套接口。问题不在技术——私有方案个个能打——而在生态:你想把 A 厂的 CPU chiplet 和 B 厂的加速器 chiplet 放进同一个封装,两边的物理层 bump 图、电气参数、链路协议都对不上,等于让两个说不同语言的人握手。UCIe 联盟(Intel、AMD、Arm、台积电、三星、日月光等发起)给出的解法是把 die-to-die 接口像 PCIe 当年对板级互连做的那样标准化:统一位宽、统一 bump 排布、统一训练流程、统一协议映射。2022 年发布 1.0,2024 年的 2.0 又补上了可测试性(DFT)与封装级管理能力。
UCIe 芯粒接口的设计目标可以浓缩成三个数:带宽密度(shoreline 上每毫米边缘跑出多少 GB/s)、能效(每比特皮焦)、延迟(封装内跳一次加多少纳秒)。所有分层与档位设计都是围绕这三个数做取舍。
二、UCIe 分层结构:协议层、适配层、物理层
UCIe 规范把接口切成三层,切法和 PCIe 类似但动机不同——die-to-die 场景下「物理链路极可靠但形态极多样」,所以把「适配」单独抽成一层,让协议层看到的永远是干净的 flit 流。
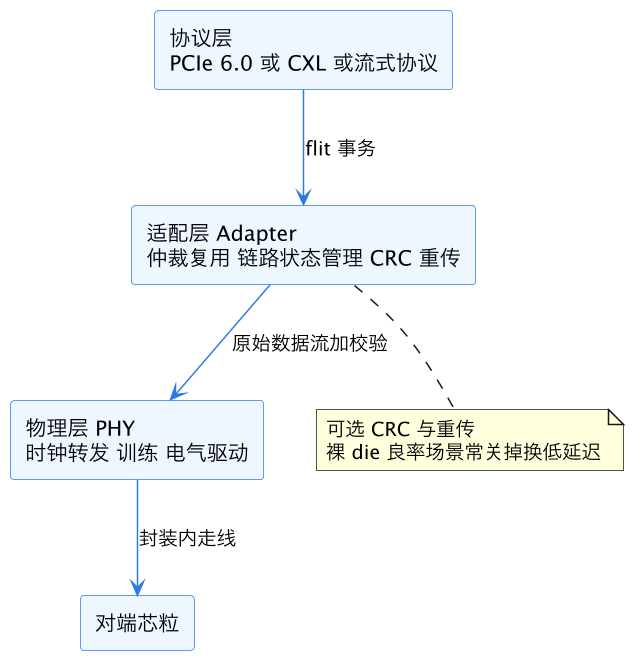
上图是发送路径的视角。三层各自的分工:
- 协议层(Protocol Layer):直接复用成熟协议的事务语义,默认是 PCIe 6.0 的 flit 模式或 CXL(Compute Express Link,一种跑在 PCIe 物理层之上、给内存扩展和加速器缓存一致性用的开放协议),也允许「流式」原生模式承载厂商自定义 NoC 协议(比如 Arm CHI 网格事务直接切片发送)。复用 PCIe/CXL 的意义是软件栈零改动:操作系统看到的仍然是一个 PCIe 设备树,芯粒边界对软件透明。
- 适配层(Adapter Layer):UCIe 里最芯粒味的一层。它负责多协议仲裁与复用(同一条物理链路上 PCIe 和 CXL.io、CXL.cache 可以共存)、链路状态机管理(对应 PCIe 的 Link Training and Status State Machine 思想),以及可选的 CRC 校验与重传缓冲。为什么重传是可选的?因为封装内走线又短又受控,误码率天然低,开重传要付出几个纳秒的弹性缓冲延迟;追求极致延迟的场景(比如一致性协议流量)宁愿把裸 die 的先验已知良好(KGD,Known Good Die)测试做严,换关掉重传的低延迟模式。
- 物理层(PHY Layer):负责时钟转发(UCIe 采用 forwarding clock,随数据一起送时钟,省掉两端各自的 PLL 锁定)、链路训练、lane 修复映射和电气驱动。一个 UCIe 模块(module)在 advanced 档是 64 条数据 lane 加时钟和 sideband,standard 档是 16 条。
分层的收益在换协议时体现得最清楚:同一个 PHY 和 Adapter,协议层从 PCIe 切成 CXL.mem,只是上层的 flit 内容变化,下面的训练、时钟、电气参数原封不动——这正是私有接口给不了的解耦。
三、两档封装规格:standard 与 advanced
UCIe 最实用的设计是把物理规格切成两档,对应两种封装工艺,让「用得起」和「堆得满」各得其所。
| 维度 | standard 标准封装 | advanced 先进封装 |
|---|---|---|
| 封装载体 | 有机基板(传统封装基板走线) | 硅中介层 / 硅桥 / RDL 扇出 |
| bump 间距 | 100 到 130 微米 | 25 到 55 微米 |
| 每模块数据 lane | 16 条 | 64 条 |
| 单 lane 速率 | 4 到 16 GT/s(2.0 扩到 32) | 4 到 32 GT/s |
| 带宽密度 | 每毫米约 28 到 224 GB/s | 每毫米约 165 到 1317 GB/s |
| 能效 | 约 0.5 pJ/bit | 约 0.25 pJ/bit |
| 典型成本 | 低,成熟供应链 | 高,中介层/桥片良率敏感 |
两档的本质差异在 bump 间距。先进封装把微凸点间距压到 25 微米级,同样一毫米的 die 边缘能塞下的 bump 数量是标准封装的四五倍,带宽密度自然拉开近一个数量级——1317 GB/s/mm 意味着一条 10 毫米宽的 die 边缘就能跑出 13 TB/s,这正是 HBM 控制器与计算 die 之间需要的量级。代价是硅中介层或 EMIB 类硅桥本身的成本与良率:中介层面积越大越贵,这也是为什么多数产品是「计算 die 之间用 advanced、低速 IO die 之间用 standard」的混搭。
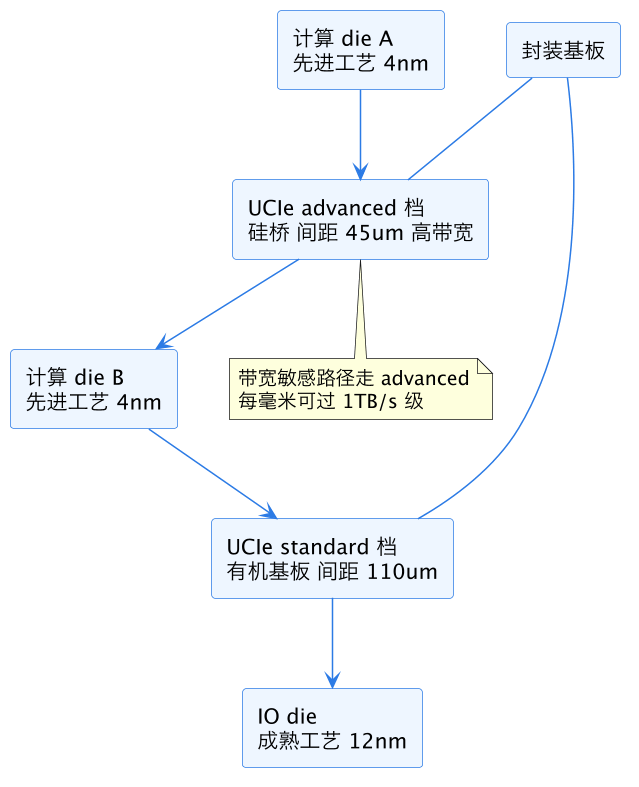
上图是典型的混搭封装布局:两颗计算 die 之间的一致性流量走 advanced 档(延迟和带宽都敏感),计算 die 到 IO die 的外设流量走 standard 档(带宽要求低一个数量级,省掉一块硅桥)。这种按流量特性选档的自由度,是 UCIe 规范直接写进设计假设的——两档共享同一套训练与协议逻辑,只是物理 lane 数和 bump 图不同。
四、链路怎么建起来:sideband 与训练流程
UCIe 的主数据通道是「哑巴」——只负责高速传比特。所有协商动作都走一组独立的低速边带(sideband)引脚:每个模块有专用的 sideband 时钟和数据对,跑 800 MHz 的低速信号,即使主 lane 完全没训练起来也能通信。这个设计直接继承了 PCIe 的教训:训练握手绝不应该依赖被训练的那条链路本身。
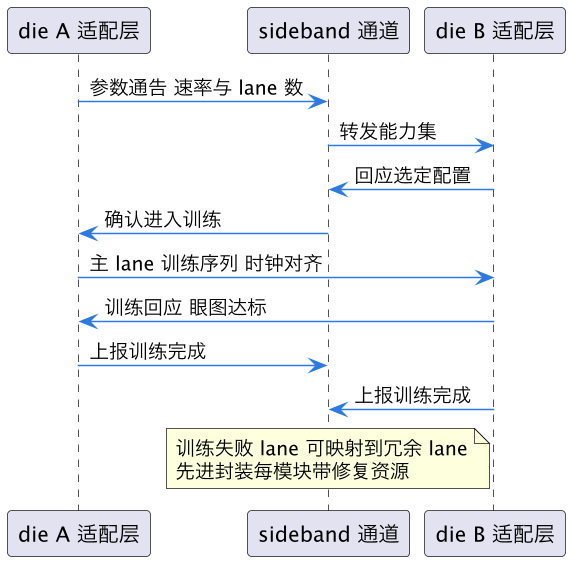
上图把一次建链拆成三步:sideband 上先交换能力集(支持哪些速率、哪个封装档、要不要开 CRC),双方在主 lane 上跑训练序列做时钟与数据对齐、测眼图质量,最后结果再经 sideband 回报。值得注意的是冗余修复:advanced 档每个模块预置了备用 lane,训练时发现某条 lane 失效(bump 虚焊、基板断线),就把它在映射表里换掉——对芯粒产品这是良率生命线,一个封装里几十条 die-to-die 链路,任何一条硬失效都不能让整颗封装报废。
建链完成之后,sideband 并不退场:运行时的链路降速、功耗状态切换(L1/L2 类睡眠)、错误上报、以及 2.0 版加入的封装级管理消息,都走这条通道。可以理解为 UCIe 给每个模块配了一条永不掉线的「控制面专线」,数据面怎么折腾都不影响管理可达性。
五、协议映射:PCIe 与 CXL 如何原生跑在 UCIe 上
UCIe 芯粒接口最大的生态杠杆是「协议层白嫖」:不重造事务协议,直接把 PCIe 6.0 和 CXL 2.0/3.x 的 flit 搬过来。对软件而言,跨 die 访问内存的完整路径是:CPU 核心发出 load → 片上 NoC 路由到 die 边缘的 CXL 端口 → 适配层把 flit 切进 UCIe 物理流 → 对端 die 还原成 CXL.mem 事务 → 访问对端内存控制器。整条路径上没有任何一次协议翻译,只有封装格式的切换。
延迟代价集中在两端 PHY 与适配层的串并转换、时钟域跨越上。规范给出的目标是每端控制在 2 纳秒量级,来回封装内一跳增加的总延迟大约 4 到 8 纳秒——对比之下,访问一次本地 DRAM 约 80 到 100 纳秒,访问跨 die 内存大致相当于「NUMA 远端节点的轻量版」,远好于经板级 PCIe 往返(微秒级)。这也正是 UCIe 和 NUMA 话题天然纠缠的原因:跨 die 延迟与 NUMA 本地远端延迟差异 同处一个量级,调度器和内存放置策略对芯粒拓扑几乎可以直接复用 NUMA 的整套方法论。
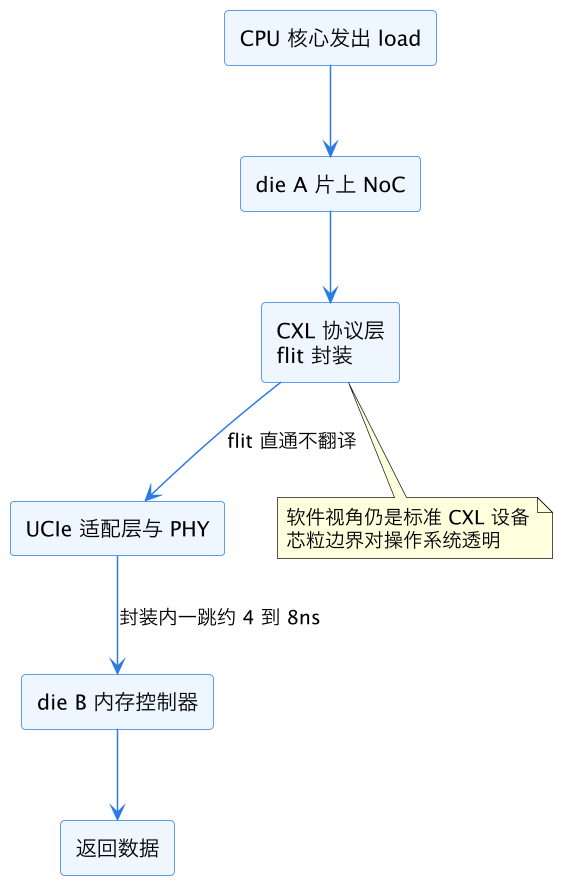
上图里最关键的一笔是「flit 直通不翻译」。如果 die-to-die 接口定义了自己的一套事务协议,那每跨一次 die 就要做一次协议转换,延迟和验证复杂度都会失控;UCIe 复用 CXL 之后,一致性语义(CXL.cache/CXL.mem 的监听与目录行为)可以端到端保留,这正是它和 芯粒多 die 缓存一致性 那篇衔接的接口点:UCIe 负责「比特可靠地到达」,一致性协议负责「到达之后语义正确」。
六、与私有 die-to-die 接口的对比定位
公平地说,UCIe 在纯技术指标上并不是碾压私有方案的。各家私有接口在自家封装里深耕多年,功耗与延迟可以针对自家 PHY 电路和封装工艺做极限优化。把它们摆在一起看:
| 维度 | UCIe | AMD Infinity Fabric on-package | Intel AIB/EMIB | 台积电 LIPINCON |
|---|---|---|---|---|
| 开放性 | 联盟标准 跨厂商 | AMD 内部 | Intel 主导 AIB 部分开源 | 台积电生态 |
| 协议层 | PCIe/CXL 原生 加流式 | Infinity Fabric 语义 | PCIe 或自定义 | 自定义 |
| 带宽密度 | 高 advanced 档 1317 GB/s/mm | 高 | 中到高 | 高 |
| 软件透明 | 完全 PCIe 设备树 | 需 AMD 平台栈 | 部分 | 无标准 |
| 适配场景 | 跨厂 chiplet 混搭 | AMD 自家产品线 | Intel 自家加代工客户 | 晶圆厂集成 |
定位结论可以一句话说清:自家全栈产品用私有方案赚最后一皮焦和最后一纳秒,跨厂商混搭或者要构建开放 chiplet 市场时用 UCIe。现实格局也印证这一点:AMD 在自家 EPYC 上继续用 Infinity Fabric(一致性语义深度定制,换标准协议不划算),Intel 一边推 UCIe 一边在自家产品里混用 EMIB 加私有协议;而 AI 加速器初创公司几乎没有例外地押 UCIe——它们买不起私有生态,需要的是「今天买一颗标准 IO die 明天就能对接」。这个分工和当年 PCIe(开放板级)与各家片上 NoC(私有片内)的格局完全同构:标准占领边界,私有守住腹地。
还有一个容易被忽略的推力:UCIe 2.0 把可测试性设计(DFT)标准化了——封装后的多 die 系统怎么分 die 定位故障、怎么做已知良好 die 筛选,规范给出了统一的测试访问结构。对没有自家测试团队的中小设计公司,这份「开箱即用的良率工程」往往比带宽数字更值钱。
这一篇在知识体系里的位置
本篇属于微架构模块「互连与芯粒线」的接口篇。die 内部互连背景见 Uncore 环形与 Mesh 互连,跨 die 之后的一致性语义在 芯粒多 die 缓存一致性 展开,跨 die 延迟对调度与内存放置的影响与 NUMA 本地远端延迟 同套方法论,片上缓存一致性协议本身见 缓存一致性协议 MESI 与 MOESI。全景地图见 CPU 微架构总览。
总结
UCIe 芯粒接口把 die-to-die 互连从各家私有方言统一成开放标准:分层上协议层原生复用 PCIe 6.0 与 CXL 的 flit(软件视角零改动、无协议翻译),适配层负责多协议复用和可选的 CRC 重传(关掉换 2 纳秒级低延迟),物理层用时钟转发加 sideband 控制面完成训练与 lane 冗余修复;规格上分 standard(有机基板、bump 间距 100 微米级、每毫米数百 GB/s)与 advanced(硅中介层或硅桥、25 到 55 微米间距、每毫米最高约 1.3 TB/s)两档,按流量敏感度混搭选用。相对 AMD Infinity Fabric、Intel EMIB/AIB 这类私有接口,UCIe 的单点性能不是最优,但跨厂商互操作、PCIe 设备树透明和 2.0 版标准化的 DFT 测试体系让它成为开放 chiplet 市场的唯一公共语言——自家全栈产品继续用私有方案抠极致能效,跨厂混搭与初创生态押 UCIe,是当前 die-to-die 互连的基本格局。