uop cache 前端:DSB 解码旁路命中、MITE 切换与功耗收益
本篇是微架构系列里聚焦取指译码前端的一篇。前面几篇已经把执行端讲透了:乱序执行机制 讲后端怎么消化 µop,CISC 与 RISC 的关系 讲译码器为什么存在。但 µop 从哪来、译码这条窄路怎么被绕开,是前端自己的故事——主角就是 uop cache(Intel 叫 DSB)。
本文要回答的问题
- x86 译码器(MITE 路径)为什么又贵又慢?
- uop cache / DSB 是怎么把译码结果直接旁路给后端的?
- DSB 与 MITE 两条路径什么时候切换、切换有代价吗?
- 命中 uop cache 对性能和功耗各有多少收益?
- 什么代码布局会让 uop cache 失效?
一、先看问题:译码器是前端最贵的一级
x86 指令长度 1~15 字节不等,一条 add eax, [rsi+8] 要先做长度判定、前缀解析、ModRM 拆解,才能切成 µop。Sandy Bridge 之后的典型 x86 译码集群是「1 复杂 + 3 简单」:复杂译码器能处理 1~4 µop 的指令,简单译码器只接 1 µop 的指令。每拍最多译 4 条,遇到复杂指令(比如 adc、带段前缀的访问)只能走那 1 个复杂译码器,吞吐立刻掉到 1 条/拍。
更麻烦的是微码指令:一条 rep movs 要展开成几十上百条 µop,得跳进微码 ROM(MSROM)慢慢吐。译码器还极其耗电——长度判定是多级全并行比较,前缀状态机每拍都在翻转,业界经验值是整个译码集群占核心功耗的 5%~10%。
这就是 uop cache 前端存在的动机:既然热代码每次译出来的 µop 一模一样,为什么不把结果存起来,下次直接给? 这个思路和指令 cache 缓存字节如出一辙,只是缓存的对象从「译码的输入」换成了「译码的输出」,省掉的是中间整个译码过程——包括最不规则、最难流水化的长度判定那一级。
二、结构:DSB 与 MITE 双路径供指
Intel 从 Sandy Bridge 起在前端放了一块 µop cache,官方名 DSB(Decode Stream Buffer)。它和传统的译码流水线 MITE(Micro-instruction Translation Engine)并列,后端供指时二选一:
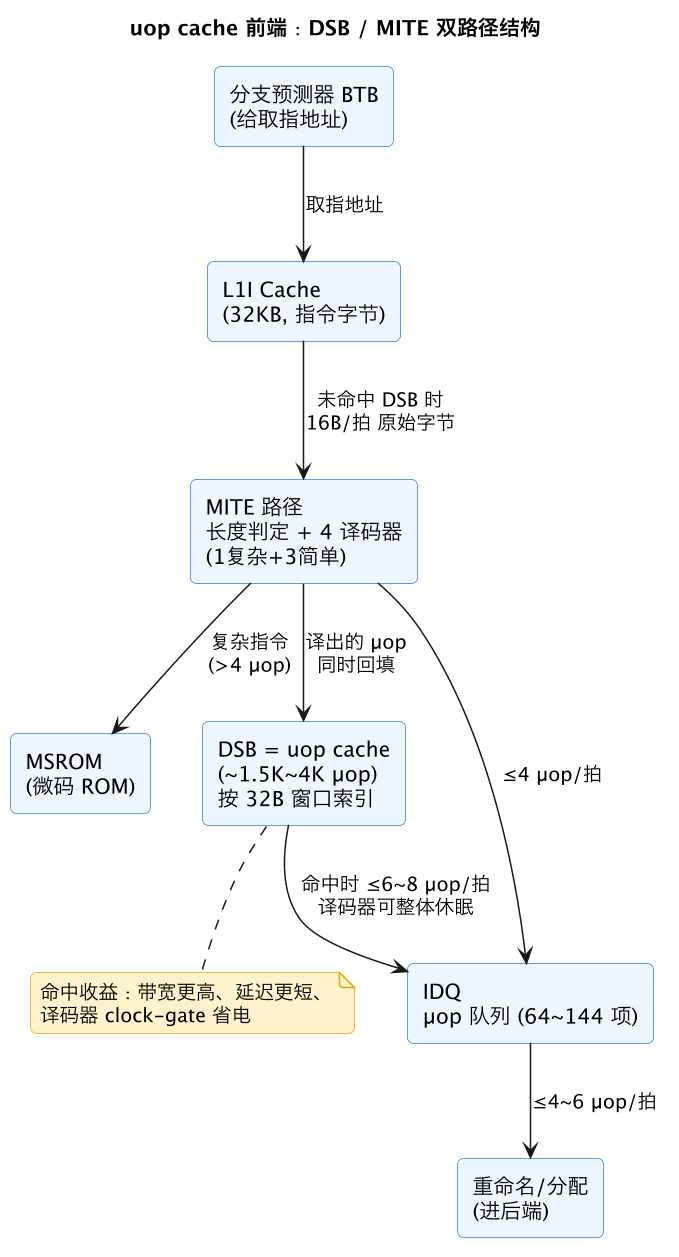
图里有三条关键信息。第一,DSB 不替代 L1I,它挂在 L1I 旁边,用取指地址的 32 字节窗口做索引,里面存的是译好的 µop而不是原始字节。第二,MITE 译出的 µop 是「边送 IDQ 边回填 DSB」——第一次执行走慢路,之后同一段代码就能走快路。第三,命中 DSB 时整条 MITE 路径(长度判定、四个译码器)可以被 clock-gate 关掉,这就是功耗收益的来源。
DSB 命中时供指带宽约 6~8 µop/拍,明显高于 MITE 的 4 µop/拍,而且省掉了译码那几拍的前端延迟。后端重命名宽度是 4~6 µop/拍,所以 DSB 命中时前端的「供指」第一次不再比「消化」窄。
三、DSB ↔ MITE 切换与 LSD
两条路径不是静态二选一,而是逐 32 字节窗口动态切换的:预测器给出取指地址,先查 DSB 有没有这个窗口的 µop——有就走 DSB,没有就走 MITE 译码并回填。切换本身几乎无惩罚,因为两者的出口都是 IDQ 队列,µop 在队列里无缝衔接。下面这张图把一段代码「第一次执行 → 第二次执行」的供指路径变化按时序画出来:
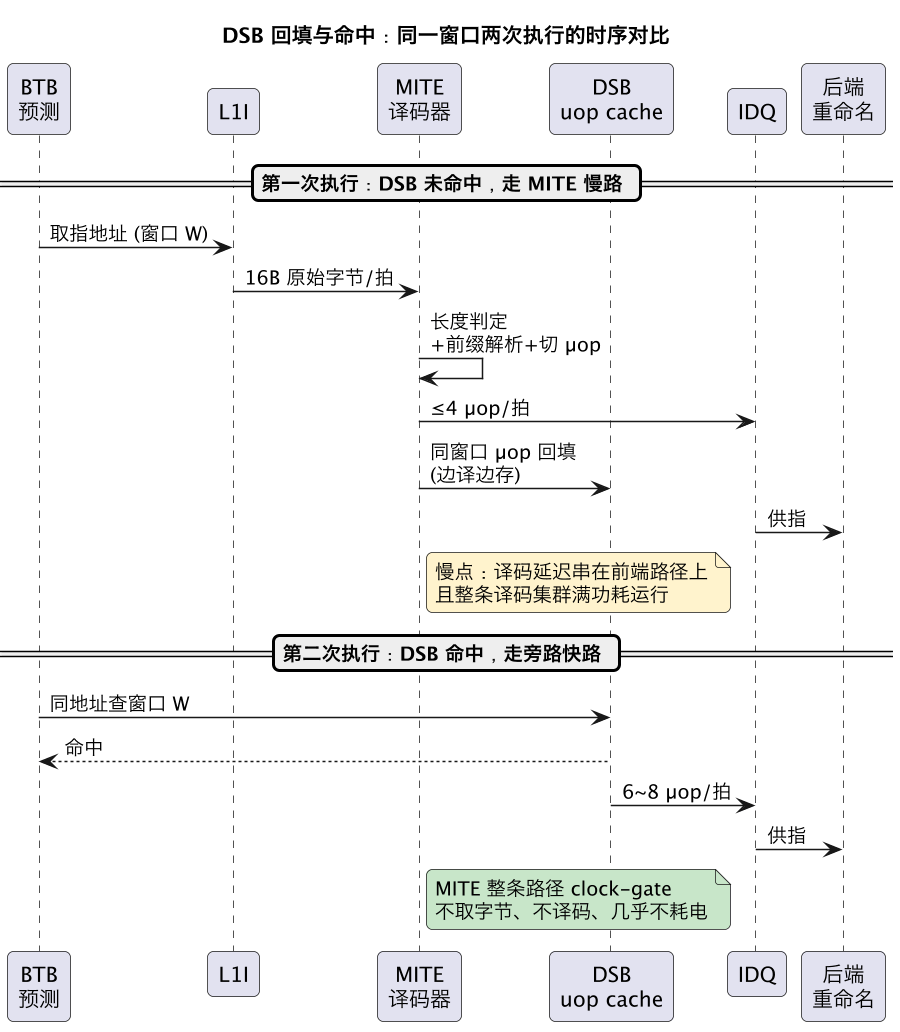
读这张图注意两点:第一,回填发生在 MITE 译码的同时,不额外占拍,所以第一次执行的代价就是正常译码代价,没有「为缓存付出的写入开销」。第二,命中时 IDQ 的输入速率(6~8 µop/拍)已经超过后端重命名的消费速率(4~6 µop/拍),IDQ 会被填满——前端第一次从「追不上后端」变成「等后端」,这正是 uop cache 前端想要达到的状态。
还有第三条更隐蔽的旁路:LSD(Loop Stream Detector,循环流检测器)。当 IDQ 发现最近发出的 µop 序列是一个小于几十 µop 的短循环,它会把这段序列锁在 IDQ 里反复回放——此时连 DSB 都不用查,L1I、MITE、分支预测器全部可以休眠。Sandy Bridge 引入 DSB 后一度把 LSD 关了,Haswell 又加了回来,因为短循环是功耗最值得优化的场景。
三种供指来源的对比:
| 供指来源 | 带宽 | 前端延迟 | 功耗 | 适用场景 |
|---|---|---|---|---|
| MITE 译码 | ≤4 µop/拍 | 最长(含长度判定) | 最高 | 冷代码、DSB 未命中 |
| DSB(uop cache) | 6~8 µop/拍 | 短 | 中(译码器关闭) | 热代码主体 |
| LSD 循环回放 | 循环体大小 | 最短 | 最低(前端全关) | <几十 µop 的短循环 |
| MSROM 微码 | 慢、串行 | 最长 | — | rep movs 等复杂指令 |
四、收益有多大:性能与功耗两头都赚
uop cache 前端的收益分两层。性能层:DSB 命中率高时,前端不再是瓶颈。用 perf 可以直接观测——Intel 的 Top-down 方法里,idq_uops_not_delivered.core 反映前端欠供,而 frontend_retired.dsb_miss 类事件告诉你有多少 µop 是从 MITE 慢路来的。经验数据:典型整数负载 DSB 覆盖率能到 70%~90%,命中时前端供指提升约 1.5 倍。
功耗层:译码器是前端耗电大户,DSB 命中时整条 MITE 路径 clock-gate。Intel 官方披露过 Sandy Bridge 的 DSB 在典型负载下能省掉译码功耗的 80% 左右——对移动和服务器 SKU 都是实打实的收益,这也是为什么 ARM 阵营(Cortex-A 系列的 L0 µop buffer)纷纷跟进同样的设计。
还有一个容易被忽略的二阶收益:DSB 命中时 µop 已经带上了精确的指令边界和宏融合(macro-fusion)信息,比如 cmp + jcc 两条指令在译码时融合成一条 µop。这条融合结果同样被缓存,意味着热代码每次都白赚一次融合,不会因为重新译码而丢失优化。
五、什么时候 uop cache 会失效
DSB 的容量和组织方式带来几条硬性失效条件,写热点代码时值得记住:
- 容量与映射冲突:DSB 只有约 1.5K(Skylake)到 4K(Golden Cove)µop,按 32 字节窗口 Way 组相联。热循环体超过容量,或者多个热窗口映射到同一组,就会频繁挤掉、退回 MITE。
- 单窗口 µop 数上限:一个 32 字节窗口译出的 µop 超过 DSB 单条目上限(18 条左右),整个窗口不缓存。密集的 AVX-512 代码(一条指令多个 µop)容易踩这条。
- 微码与某些指令不缓存:走 MSROM 的指令、部分 SSE/AVX 过渡指令不进 DSB,每次都得重新译。
- 自修改代码与频繁 JIT:DSB 靠 i-cache 一致性协议失效,JIT 场景反复写代码页会让 DSB 跟着反复失效。
- 跨窗口的长指令:一条指令横跨两个 32 字节窗口时,其 µop 归属和回填规则更苛刻,某些微架构上这类窗口的缓存效率会下降——这也是编译器倾向把热循环对齐到 16/32 字节边界的原因之一。
实践结论很朴素:让热点循环紧凑、对齐、少微码指令。编译器 -falign-loops、避免在热路径里放 rep movs 手写内联,都是在给 uop cache 前端让路。反过来,如果你用 perf 看到 frontend_bound 占比高而 DSB 命中率低,先怀疑代码布局而不是后端宽度。
这一篇在知识体系里的位置
本篇回答「µop 从哪来」。译出的 µop 往后走,进入 乱序执行机制 讲的后端;指令为什么是 CISC、为什么要译码,见 CISC 与 RISC;译码延迟如何变成流水线气泡,见 流水线基础;前端欠供如何体现为 IPC 损失,见 IPC 瓶颈分析。
总结
uop cache 前端(Intel DSB)把译好的 µop 按 32 字节窗口缓存起来,热代码再执行时绕过又贵又耗电的 MITE 译码路径直接供指:带宽从 4 µop/拍提到 6~8,译码器整体休眠省电约八成,短循环还能进一步锁进 LSD 让前端全关;代价是容量小、对代码布局敏感——循环体过大、单窗口 µop 超上限、微码指令都会把它打回 MITE 慢路。