ITLB miss:指令侧 TLB 未命中对前端的独特杀伤力与 2M 大代码页的收益
更新时间:2026-10-03。谈 TLB(Translation Lookaside Buffer,地址翻译后备缓冲)的文章大多围着数据侧打转——缺页、大页、page walk,说的都是 load/store 的地址翻译,大页与 TLB 压力 就是那条线的代表。但流水线里还蹲着一个更冷血的 TLB:ITLB(指令侧 TLB),负责把「下一条要取的指令的虚拟地址」翻译成物理地址。它 miss 的时候,遭殃的不是某一条 load 的延迟,而是整条取指流水当场断粮——前端一个字节都喂不进来,后端几百项深的乱序窗口只能空转等死。这一篇专讲指令侧:ITLB miss 在哪一级发生、为什么它的杀伤面比 DTLB miss 大、大跳转 footprint 的代码为什么格外容易踩雷、以及把代码段抬上 2M 大页之后能拿到多少真实收益。背景见 CPU 微架构总览 与 两级 TLB 与 STLB 设计。
本文要回答的问题
- 取一条指令为什么要过 ITLB?它和 icache 的查询是怎么重叠的?
- ITLB miss 触发页表遍历期间,前端到底停成什么样?为什么乱序执行救不了它?
- ITLB miss 和 DTLB miss 的代价差在哪?谁的 CPI 杀伤力更大?
- 大代码 footprint、far jump、冷函数为什么会放大 ITLB miss 率?
- 2M 大代码页、代码布局优化各能压掉多少 miss?怎么测?
一、取指的第一道关卡:ITLB 与 icache 的并行查询
每条指令在被译码、重命名之前,先要被「取到」。取指单元的输入是分支预测器给出的下一个取指地址(虚拟地址),它必须同时回答两个问题:这个虚拟地址对应的物理地址是什么(翻译问题),这个物理地址的指令字节在不在 L1 icache 里(缓存问题)。现代核把这两件事并行做:ITLB 查虚拟页号对应的物理页框,icache 用虚拟地址的索引位同时定位 cache set,两边结果汇合后做 tag 比对——这就是 VIPT(Virtually Indexed Physically Tagged,虚拟索引物理标签)结构,细节见 VIPT 与同义别名问题。
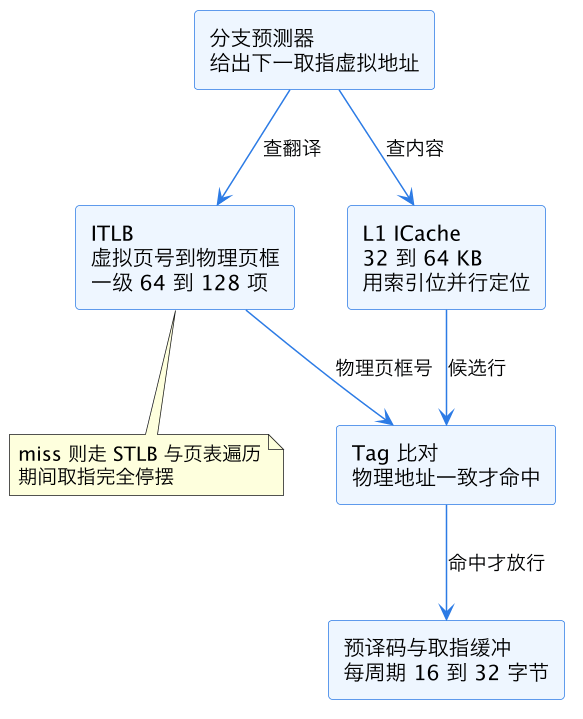
上图是取指通路的并行结构。关键点在于:tag 比对用的是物理地址,所以 ITLB 不出结果,icache 即使查到了候选行也不敢放行——翻译是取指放行的必要条件,没有旁路。L1 ITLB 很小,典型只有 64 到 128 项,每项覆盖一个 4K 页,合起来只能记住 256K 到 512K 的指令地址空间。一个热点代码 footprint 超过几百 K 的程序(这在服务端大单体里是常态),ITLB 的压力就已经上桌了。
ITLB 一级 miss 还不算完,后面还有 STLB(Shared L2 TLB,共享二级 TLB)兜底,STLB 再 miss 才走硬件页表遍历(page walk)。这套层次和数据侧共享,两级 TLB 与 STLB 设计 有完整展开;本篇只关心:这条链上每一级 miss 的代价,为什么落在指令侧格外疼。
二、miss 那一刻:前端断粮与乱序窗口的饿死
先看代价的数字量级。一次 ITLB miss 命中 STLB,大约 7 到 10 个周期;STLB 也 miss,硬件页表遍历器开始跑四级页表,最好情况(每级页表项都命中 TLB 的页表缓存或 L1)二十来个周期,最坏情况(四级页表项全要访存)轻松破百周期,page walk cache 的作用见 页表遍历缓存。这几十上百个周期里,前端是什么状态?
答案是彻底的零输出。取指地址翻译不出来,取指单元连下一个字节往哪取都不知道——注意取指是串行依赖链:第 N 块指令的地址要靠第 N-1 块译出分支后由预测器推进,而当前这块连翻译都没完成。没有任何投机机制能绕过 ITLB miss:分支预测可以猜方向、BTB(Branch Target Buffer)可以猜目标(见 BTB 分支目标缓冲),但猜出来的虚拟地址照样要过 ITLB。于是取指缓冲被抽干、译码级空转、重命名级饿着,取指遇到分支的气泡 讲的普通前端气泡是十几周期量级,ITLB miss 加一个页表遍历直接把这个气泡放大五到十倍。
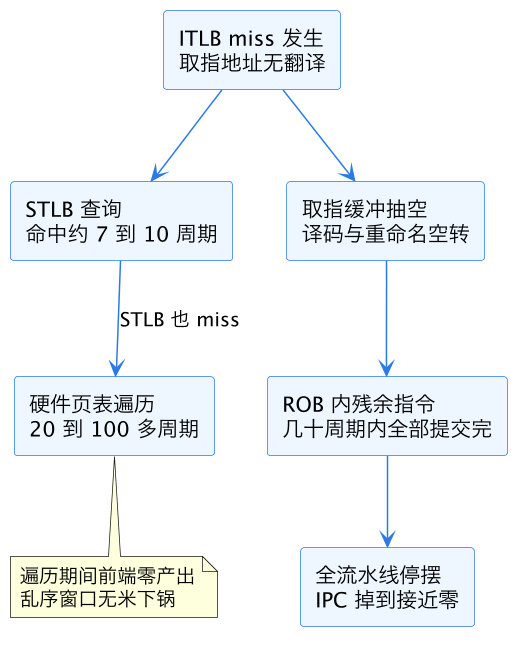
上图展示了 miss 发生后流水线的死亡顺序。最致命的一环是「ROB 内残余指令几十周期内全部提交完」——乱序执行本来是靠深窗口吸收延迟的(机制见 CPU 乱序执行),窗口里通常躺着一两百条在飞指令,miss 刚发生的前十几周期它们还能继续执行提交,制造出「一切正常」的假象。但窗口只出不进,抽干之后整条流水线进入硬停摆,IPC(每周期指令数,见 IPC 瓶颈)直接掉到零。这就是为什么 ITLB miss 的代价不是「几十周期」而是「几十周期乘以前端停摆期间本可交付的全部指令」。
三、为什么 ITLB miss 比 DTLB miss 更毒
数据侧的 DTLB miss 同样要走页表遍历,代价数字差不多,但杀伤面完全不同。核心差异在一张表:
| 维度 | DTLB miss | ITLB miss |
|---|---|---|
| 受阻对象 | 一条 load 或 store | 整个取指流 |
| 乱序窗口能否掩盖 | 能:其他无关指令继续执行 | 不能:窗口只出不进,抽干即全停 |
| 投机绕过可能性 | 有(地址预测、无关指令先行) | 无:翻译是取指放行硬条件 |
| 典型后果 | 该 load 的消费者延迟几十周期 | 前端整体停摆几十上百周期 |
| 对 IPC 的影响 | 局部、可分摊 | 全局、断崖 |
这张表的第一行是全部差异的根源。load 的 DTLB miss 只卡住「等这个数据的那一小撮指令」,乱序窗口里与它无关的几百条指令照常推进,等翻译回来数据再取,损失被窗口摊薄——这正是乱序执行存在的意义。而 ITLB miss 卡住的是「制造指令的那台机器」本身,窗口里没有新指令补充,再好的乱序引擎也只能坐吃山空。用 Top-Down 方法论(见 Top-Down 分析方法)的话说:DTLB miss 落在 Memory Bound 或 Core Bound 的格子里,ITLB miss 直接顶在 Frontend Bound 的最上游——而且是「Fetch Latency」这一类里最难被其他机制吸收的一种。
还有一个隐蔽的放大器:ITLB miss 和 icache miss 经常结伴出现。代码 footprint 大到 ITLB 装不下的时候,通常 L1 icache 甚至 L2 也装不下,翻译好不容易回来了,取指又是一个 icache miss 再等一次内存层级。两次串行延迟叠在同一个取指地址上,前端气泡被拉长到数百周期,这类「翻译加内容双 miss」是冷函数首调用的标配,与 取指遇到分支的气泡 里讨论的单纯 BTB miss 不可同日而语。
四、谁在大规模制造 ITLB miss:大 footprint、far jump 与冷函数
哪些程序会频繁踩 ITLB?答案由 L1 ITLB 的覆盖面积直接决定:64 到 128 项乘 4K,覆盖 256K 到 512K。热点代码(循环加上常用调用路径)超出这个范围越多,抖动(thrash)越狠。三类典型场景。
第一类是巨型单体的主循环。一个编译后 .text 段几十上百 MB 的服务端二进制,其主事件循环跨几十个编译单元、调用图铺开几百 K 到几 MB,每绕一圈,ITLB 表项被逐出又重填一遍。这类程序的 perf 采样里 itlb_misses.miss_causes_a_walk 计数高得扎眼,Intel 的实测数据是某些数据库和 JVM 工作负载下 ITLB miss 造成的周期占比能到 5% 到 15%。
第二类是 far jump(远跳转)密集的访问模式。函数按编译单元顺序排布,而运行期的调用顺序完全由业务路径决定——A 模块调到 Z 模块,跨越的虚拟地址范围动辄几十 MB,一次跳转就是一次几乎必然 miss 的新页。间接调用多的代码(虚函数、函数指针表、解释器分派循环)把这个问题进一步放大,间接分支本身就要靠 ITTAGE 这类预测器猜目标(见 间接分支预测),猜对了目标也还得过 ITLB。
第三类是冷函数首调用。错误处理路径、超时回调、低频管理接口,平时从不执行,ITLB 和 icache 里都没有它们的影子;一旦触发,翻译 miss、内容 miss、分支训练缺失三连。单次代价无所谓,但如果「冷函数」其实每几百毫秒就被摸一次(比如周期性的健康检查走了另一条代码路径),累计的前端停摆相当可观。
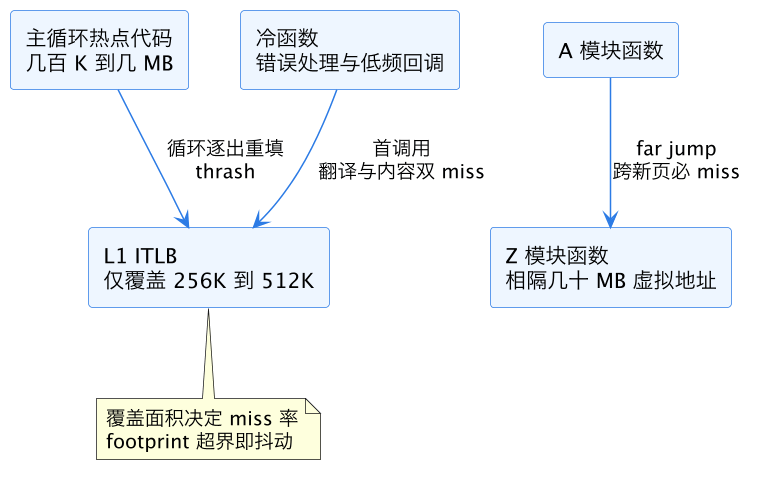
上图把三类 miss 制造者画在 ITLB 的覆盖瓶颈周围。注意它们的共性:问题都不在「代码总量」,而在「单位时间触及的不重叠 4K 页数」——这正是 2M 大页能一剑封喉的原因。
五、解法:2M 大代码页与代码布局优化
思路一:把翻译的粒度从 4K 换成 2M。一个 2M 大页的 ITLB 表项顶 512 个普通表项的覆盖面积,L1 ITLB 里大页表项哪怕只有 8 到 16 个,也能罩住 16M 到 32M 的代码——绝大多数程序的全部热点都装下了。miss 率常常直接掉一个数量级,前端停摆周期占比从两位数压到 1% 上下,整体性能提升在大 footprint 工作负载上实测 5% 到 10% 起步。落地手段在 Linux 上有几条路:把 .text 段链到 2M 对齐并用 hugeedit/libhugetlbfs 或显式 madvise 挂进大页;新一点的发行版支持 CONFIG_TRANSPARENT_HUGEPAGE 对可执行段的透明大页;部分运行时(JVM 的 -XX:+UseLargePages)自带开关。大页与 TLB 压力 里的大页机制原理完全适用,只是本篇的场景换到了指令侧。
思路二:缩小热点 footprint 本身。PGO(Profile Guided Optimization,按 profile 反馈优化)加 BOLT 这类二进制布局工具,把运行期真正热的函数重排到相邻地址,冷代码甩到远处。热点从几 MB 压缩到几百 K,ITLB 和 icache 的抖动一起消失——这本质上是把「单位时间触及的页数」直接做小,和大页是互补关系:先靠布局把热点捏紧,再靠大页把捏紧的热点整片罩住。编译期的函数重排信息还会顺带改善 BTB 命中率,与 uop 缓存与译码前端 讨论的前端其他环节形成连锁收益。
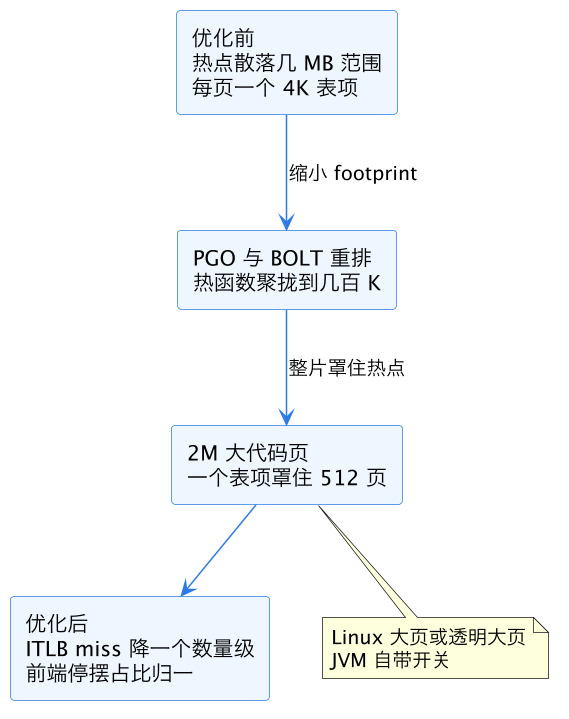
上图是两步走的优化路线。先重排再上大页的顺序不是强制的,但组合效果稳定好于任何单一手段。
最后给一个量级参照表,把本篇的数字钉死(以 2020 年代高性能核为参照):
| 项目 | 典型量级 | 备注 |
|---|---|---|
| L1 ITLB 容量 | 64 到 128 项乘 4K | 覆盖 256K 到 512K |
| L1 ITLB 大页项 | 8 到 16 项乘 2M | 覆盖 16M 到 32M |
| ITLB miss 命中 STLB | 7 到 10 周期 | 前端短停摆 |
| STLB miss 页表遍历 | 20 到 100 多周期 | 期间前端零产出 |
| 大 footprint 负载 ITLB 开销 | 5% 到 15% 周期占比 | 大页后压到约 1% |
| 大页加布局优化的综合收益 | 5% 到 10% 以上 | 数据库、JVM、大单体类 |
测量侧也一并交代:perf stat -e itlb_misses.miss_causes_a_walk,itlb_misses.walk_completed(事件名随微架构代次微调)看 miss 频率与完成的遍历数,Top-Down 里的 Frontend Bound 占比确认杀伤面,优化前后各跑一次对照,数字会说话。有两个测量细节容易踩坑:其一,页表遍历走内存时会污染数据侧缓存,对照实验要在相同数据集热度下跑,否则你测到的改善里混着缓存效应;其二,透明大页是否真正落到了代码段上要用 /proc/<pid>/smaps 里的 AnonHugePages 与 FileHugePages 字段核实,挂页失败时 perf 数字不会替你报警——先把「页真的大了」验证掉,再谈性能归因。
这一篇在知识体系里的位置
本篇是微架构模块 TLB 线「指令侧专题」,把 两级 TLB 与 STLB 设计 和 页表遍历缓存 的通用机制落到取指通路上。上游背景是 CPU 微架构总览 与 取指遇到分支的气泡(前端气泡家族),数据侧对照见 大页与 TLB 压力(同一套大页手段的数据侧版本)、VIPT 与同义别名问题(翻译与缓存查询的并行结构)。相邻的前端主题还有 BTB 分支目标缓冲、间接分支预测、uop 缓存与译码前端。性能归因方法见 Top-Down 分析方法 与 IPC 瓶颈。
总结
ITLB miss 是取指地址的翻译未命中,它卡住的不是某条 load 而是整条取指流水——翻译回来之前前端零产出,乱序窗口只出不进几十周期内被抽干,IPC 断崖式归零,杀伤面远大于可被乱序掩盖的 DTLB miss;大代码 footprint、far jump 密集的调用图和冷函数首调用是三类主要 miss 制造者,病根都在「单位时间触及的不重叠 4K 页数超出 L1 ITLB 那 256K 到 512K 的覆盖面积」;解法两步走:先用 PGO 加 BOLT 把热点代码重排聚拢缩小 footprint,再把代码段挂上 2M 大页让一个 TLB 表项罩住 512 个 4K 页,miss 率通常掉一个数量级,大单体工作负载整体性能提升 5% 到 10%——记住一句话:DTLB miss 饿死一条指令,ITLB miss 饿死整条流水线。