FMA 延迟吞吐链:乘加单元两个参数如何决定依赖链代码的性能
承 pipelining-basics 对流水线延迟与吞吐两个概念的拆解,以及 vector-simd-execution-units 对向量执行单元的介绍。那两篇讲的是「流水线是什么、执行单元有什么」,本篇聚焦一个更具体的问题:浮点乘加单元(FMA)的延迟和吞吐这两个参数,如何分别支配两类代码的性能——以及为什么大量浮点代码的实际速度既不看主频也不看峰值 FLOPS,只看一条依赖链的长度。
本文要回答的问题
- FMA 指令是什么?它的延迟和吞吐分别指什么、典型值是多少?
- 为什么「累加求和」这种简单循环会被延迟卡死,离峰值算力差 8-10 倍?
- FMA 延迟吞吐链的性能公式怎么推导?链长、延迟、展开份数怎么代入?
- 多累加器展开为什么有效?展开多少份才算够?
- 怎么用 PMU 和简单实验确认自己的代码是被 FMA 依赖链限住的?
一、FMA 单元:一条指令,两个速度参数
FMA(Fused Multiply-Add,融合乘加)是一条指令完成 a = a + b * c:一次乘法、一次加法,中间结果不做舍入,精度比分开写 mul + add 更高,速度还更快。从 Haswell(2013)起,Intel 每代桌面/服务器核都配了 FMA 单元,AMD 从 Piledriver 起跟进,ARM 的 Neon/SVE 同样提供。它是现代处理器浮点峰值算力的全部来源——厂商宣传的 FLOPS 数字,就是按「每个 FMA 单元每拍吐一条向量 FMA」算出来的。
关键在:这个单元有两个独立的速度参数,绝不能混为一谈。
- 延迟(latency):一条 FMA 从发射到结果可写回,要走多少拍。典型值 4-5 拍(Skylake 4、Ice Lake 4、Zen 4 4、Golden Cove 4-5)。这是「一条指令等结果」的时间。
- 吞吐(throughput):单元每拍能接受几条新 FMA。取决于端口数:Intel 多数核有 2 个 FMA 端口(port 0、port 1/5),即每拍 2 条、吞吐倒数 0.5;Zen 系列同样是 2 条/拍;只有 1 个端口的服务器阉割核(部分 Atom、低端 Xeon)是 1 条/拍。
补一句向量宽度的账:FMA 单元是按位宽计酬的。Skylake-SP 起 512 位 FMA 一条指令装 8 个双精度数,256 位装 4 个,128 位装 2 个。所以「每拍 2 条 FMA」在 AVX2 双精度下是 8 FLOP/拍(2 条 × 4 通道 × 2 次运算),在 AVX-512 下翻倍到 16。后面所有「离峰值差几倍」的倍数,都是相对这个口径说的。另外注意 x86 的 FMA 是三操作数破坏性写形式 vfmadd231pd dst, src1, src2,dst 被覆写——这个细节决定了依赖链上寄存器的复用方式,反汇编时认准 132/213/231 三种编码里哪种会把累加器当输入。
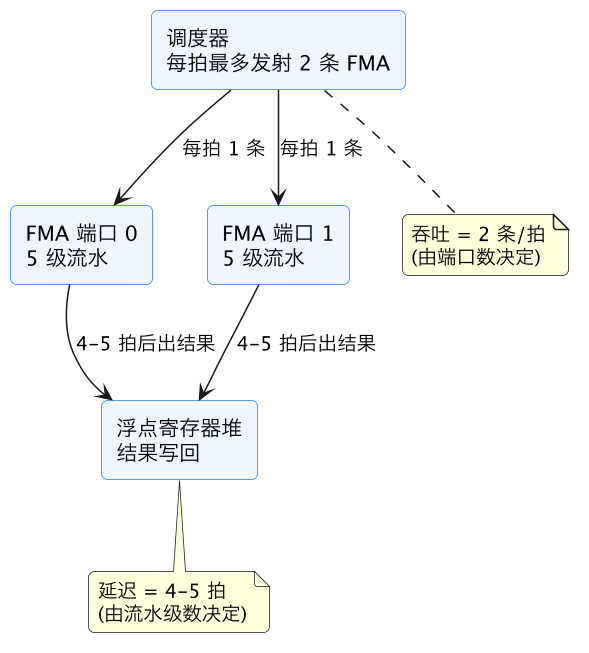
读这张图注意两条注释的分工:吞吐由「入口有几个端口」决定,延迟由「每条管道有多深」决定。两个参数正交——端口多不缩短单条延迟,管道深也不减少入口宽度。而代码命中哪一个,取决于指令之间的数据依赖关系,这正是下一节的主题。
先给一张各代参数速查表,后文公式都从这里取值:
| 代次(代表核) | FMA 延迟(拍) | FMA 端口数(T) | 打满所需独立链 K=L×T |
|---|---|---|---|
| Intel Skylake / Cascade Lake | 4 | 2 | 8 |
| Intel Ice Lake / Tiger Lake | 4 | 2 | 8 |
| Intel Golden Cove(12-14 代) | 4-5 | 2 | 8-10 |
| AMD Zen 2 / Zen 3 / Zen 4 | 4 | 2 | 8 |
| ARM Neoverse N2 / V2 | 4 | 2 | 8 |
有意思的是,过去十年主流核的 FMA 延迟几乎没动过——从 Haswell 到 Zen 4 都停在 4 拍上下。厂商把晶体管预算花在加宽向量(256 位到 512 位)和加端口上,而不是缩短流水级,因为更深的流水会拖累分支误预测恢复和能效。这意味着「链式代码跑不快」不是某一代的缺陷,而是整个时代的结构性约束;多累加器这套手法在可预见的几代硬件上都不会过时。
二、依赖链:延迟当家,吞吐插不上手
看一个再普通不过的浮点累加:
double sum = 0.0;
for (int i = 0; i < N; i++)
    sum += a[i] * b[i];   // 编译成 vfmadd231pd 或 mulpd+addpd
编译器用 FMA 后,循环体每轮一条 vfmadd,但每一条的累加结果 sum 都是下一条的输入——这是 data-hazards-raw 讲的 RAW(读后写)真依赖。第 i+1 条 FMA 必须等第 i 条完整走完 4-5 拍流水、结果写回后才能发射。于是每轮迭代的开销不是 0.5 拍(吞吐),而是 4-5 拍(延迟)。
这就是 FMA 延迟吞吐链 的核心图景:当代码里存在一条「上一条的结果是下一条的输入」的依赖链时,整条链的推进速度 = 链上每条指令的延迟之和,吞吐再高也用不上。两个 FMA 端口里有一个长期闲置,峰值算力 8 FLOPS/拍(双口 AVX2)实际只跑出 1 FLOPS 每 4 拍——离峰值差 8 倍。
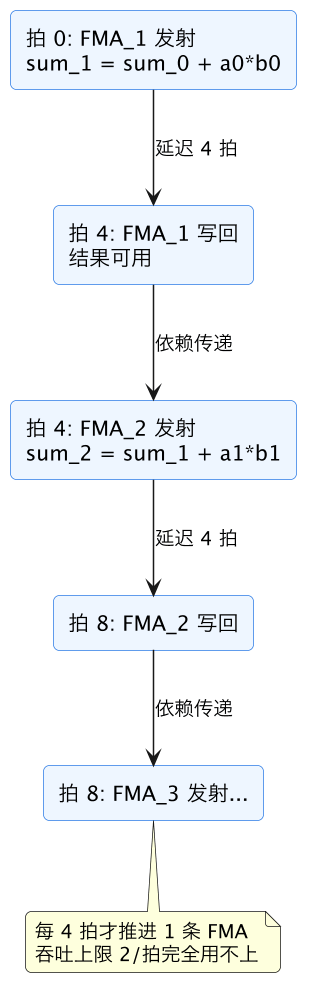
图上每个「发射」框都只能出现在上一条「写回」之后,链式推进的节拍被延迟锁死。同理可推到其他链式运算:多项式求值(Horner 法则)、递推滤波(IIR)、迭代收敛(牛顿法内层)——这些场景里 FMA 依赖链的长度就是性能本身,换更快的 CPU 如果没有更短的 FMA 延迟,提速为零。
这里值得把 Horner 法则单独拎出来看一眼,因为它是「数学上最优、硬件上最差」的典型。n 次多项式用 Horner 只要 n 条 FMA,比朴素法少一半乘法,教科书都推荐它。但 n 条 FMA 串成一条完整依赖链,总耗时 n×4 拍;而拆成奇偶两个子多项式分别用 Horner、最后合并,条数几乎不变,链长砍半,耗时直接对折。数学课本优化的是「运算次数」,硬件在意的是「链长」——这两本账在 FMA 时代经常打架,本文就是教你怎么按硬件这本账来改。
还有一个隐蔽的链式场景:循环里的条件累加。if (w[i] > 0) sum += ... 这种写法编译器会用 mask 或分支实现,看似每轮只有一次累加,但 sum 这根链依然全串,且分支误预测会在链上叠加气泡。排查时先看链、再看分支,顺序不要反。
三、性能公式:链长、延迟、吞吐的代入法
把上面的力学写成可计算的式子。设循环共 N 条 FMA,延迟 L 拍,每拍最多发射 T 条(端口数),代码被展开成 K 条相互独立的依赖链:
总拍数 ≈ max(N / (K × 1), N / T) 的下限由 max(L, N/(K·T)) 级别的两项瓶颈取大决定——更直观的写法是:
- 每条独立链上,FMA 之间至少隔 L 拍,K 条链并行时每拍最多消耗 K 条链的推进份额;
- 当 K × (1/L) ≥ T,即 K ≥ L × T 时,链的供给足以喂饱所有端口,性能被吞吐封顶,达到峰值;
- 当 K < L × T 时,端口吃不饱,性能 = 峰值 × K/(L×T)。
代入典型参数 L=4、T=2:K=8 条独立链才能打满。这就是「8 个累加器」这个经验数字的出处——它不是玄学,是延迟乘以吞吐。
| 独立链数 K | 每拍有效 FMA(L=4, T=2) | 相对峰值 |
|---|---|---|
| 1(朴素累加) | 0.25 | 12.5% |
| 2 | 0.5 | 25% |
| 4 | 1.0 | 50% |
| 8 | 2.0 | 100% |
| 16 | 2.0(端口封顶) | 100% |
表格里能看到两个相位:K 从 1 到 8 是「延迟区」,性能线性增长;K 超过 8 进入「吞吐区」,再加链也没用——端口只有 2 个。优化浮点链式代码,本质就是把 K 从 1 抬到 L×T。
四、多累加器展开:把一条链劈成八条
对上面的累加循环,标准修法是拆累加器:
double s0=0,s1=0,s2=0,s3=0,s4=0,s5=0,s6=0,s7=0;
for (int i = 0; i < N; i += 8) {
    s0 += a[i+0]*b[i+0];  s1 += a[i+1]*b[i+1];
    s2 += a[i+2]*b[i+2];  s3 += a[i+3]*b[i+3];
    s4 += a[i+4]*b[i+4];  s5 += a[i+5]*b[i+5];
    s6 += a[i+6]*b[i+6];  s7 += a[i+7]*b[i+7];
}
double sum = ((s0+s1)+(s2+s3)) + ((s4+s5)+(s6+s7));
8 个累加器对应 8 条互不依赖的链,每条链的 FMA 仍隔 4 拍,但 8 条链错相位喂进 2 个端口,每拍 2 条全部吃满。实测在 Skylake 类核上,这一改动让 AVX2 双精度点积从 ~1.2 GFLOPS 提到 ~9 GFLOPS,接近线性 8 倍。
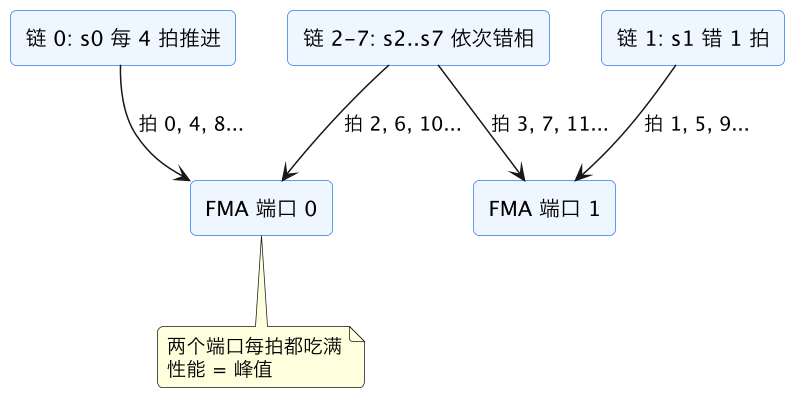
三个细节决定成败。其一,累加器必须用独立寄存器变量,写成 s[i&7] 这种数组形式编译器可能合并回单链,务必 -O2 后反汇编确认有 8 个独立的 ymm 目标寄存器。其二,浮点求和换序改变结果——多累加器的归约顺序和原顺序不同,末尾若干位会有差异,对数值可重复性有硬要求的场景(金融对账、跨平台校验)要先确认可接受。其三,链内如果混有除法或开方,它们的延迟是 13-20 拍且单元不流水,8 条链远远不够,那是 fpu-divider-latency 的领域,修法是把除法提出循环或换成乘倒数。
五、编译器会替你做吗:自动展开的边界
一个自然的疑问:都 2026 年了,GCC/Clang 不会自动把累加器拆开吗?答案是:默认不会,也不能会。浮点加法不满足结合律,把单链拆成多链等于改变运算顺序,IEEE 754 严格模式下这是非法优化。所以 -O2 -march=native 编译出来的累加循环,反汇编里就是一个 ymm 寄存器反复当 vfmadd 的目标——链长 1,性能被延迟钉死。
给编译器松绑的开关是 -ffast-math(或更精细的 -fassociative-math -fno-signed-zeros 等子项)。开了之后 GCC 和 Clang 都会做归约变量展开,Clang 还接受 #pragma clang fp contract(fast) reassociate 这种局部放行。实测 Clang 17 开 fast-math 后能把点积自动拆成 4 条链——但仍不到 L×T=8,手写 8 累加器依然有 1.5-2 倍空间。ICC/ifx 做得最激进,经常直接拆满,这也是同类代码换编译器性能突变的原因之一。
工程上的推荐姿势:性能关键的浮点 kernel 手写展开、对数值顺序敏感的外围代码保持严格模式,用函数属性或单独编译单元隔离 fast-math 的作用范围,而不是全项目一把梭。
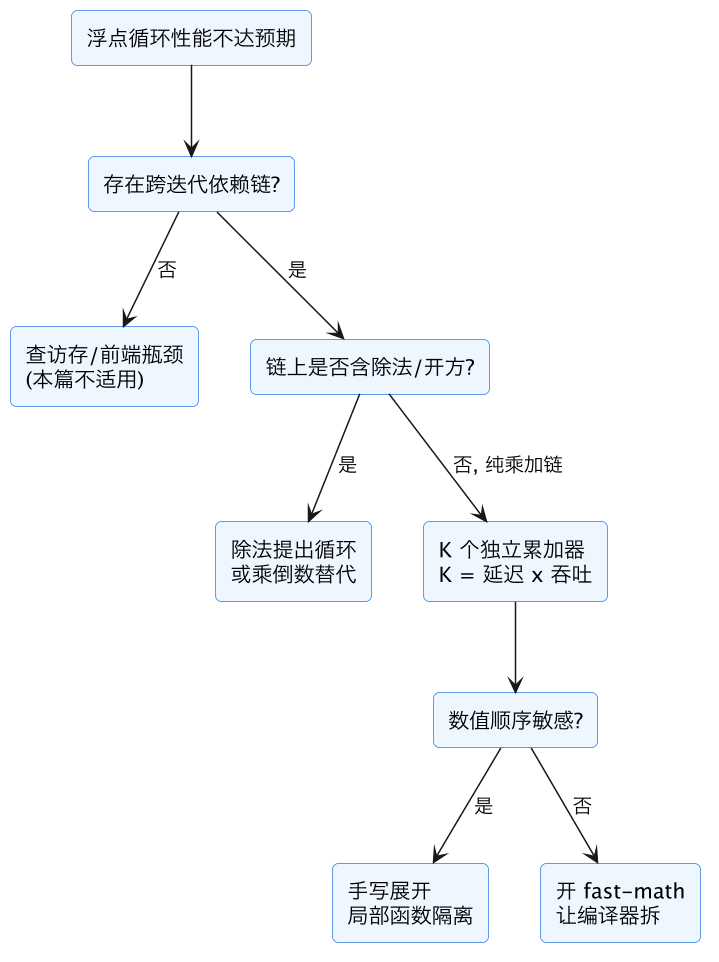
这张决策图把前几节串成一条排查路径:先确认是依赖链问题而非访存问题,再看链上有没有除法这类「超级延迟源」需要优先处理,最后按数值可重复性要求选「手写」还是「编译器代劳」。注意 fast-math 那条路虽然省事,但它影响整个编译单元的所有浮点语义,接入前先在测试集上对比一次输出。
六、确认与排查:你的代码是不是被链限住的
怀疑 FMA 依赖链限流,按三步走。
第一步,算理论上限。数出热点循环每轮的 FMA 条数和依赖链结构,代入第三节的公式算期望拍数,再和实测拍数比。实测拍数用 perf stat -e cycles,instructions 拿,除以迭代数。如果实测 ≈ L ×(链上 FMA 数),而远低于吞吐上限 N/T,依赖链限流基本坐实。注意数 FMA 条数要看反汇编而不是源码——编译器可能把 a*b+c 合成 FMA,也可能在没开 -ffp-contract=fast 时拆成 mul 加 add,两条链的参数完全不同。
第二步,看端口利用率。Intel 上 perf stat -e uops_dispatched_port.port_0,uops_dispatched_port.port_1(不同代事件名略异),如果两个 FMA 端口的每拍 uop 数都远低于 1,而 IPC 也不高、无 cache miss、无分支误预测——排除法指向的就是执行单元饿肚子,即链不够长。这一步和 execution-port-contention 的排查路径正好相反:那篇是端口太挤,这里是端口太闲。
第三步,做对照实验。把累加器复制成两份(K=2)重跑,如果性能近乎翻倍,说明原代码 K=1 确实被延迟锁死;如果纹丝不动,瓶颈在别处(访存、前端),别再往展开上投时间。这个对照实验成本极低——改两行代码、重跑一次基准——但判别力极强,强烈建议在任何「凭公式猜瓶颈」的优化前先做它。经验上,浮点 kernel 性能问题里约三成最后证明是依赖链,其余是访存和端口争抢,不先做对照,很容易把三种病开同一张药方。
另外一个实用技巧:造一个微基准固定住结论。写一个 4096 元素的点积循环,分别编译单累加器和 8 累加器两个版本,把两者的性能比记进团队文档。换硬件、换编译器、换编译参数后重跑一次,如果比值偏离预期(比如从 7 倍掉到 2 倍),说明环境的 L 或 T 变了——可能是 AVX-512 降端口,也可能是编译器突然自动展开了。这个微基准不到 50 行,却能把本文所有公式变成随时可验证的实测锚点。
还有两个容易误判的边界。一是 AVX-512 核上展开份数要重新算:512 位 FMA 在部分型号只剩 1 个端口(T=1),K=4-5 即够,且重负载下频率下探,见 avx512-downclock-license。二是 链上混着 load:如果每轮 FMA 的操作数来自内存,L1 命中的 load-to-use 延迟(4-5 拍)也会串进依赖链,此时有效链延迟是 load 延迟加 FMA 延迟,展开份数要按 9-10 拍算,或者用软件流水线把 load 提前一拍解耦。
这一篇在知识体系里的位置
本篇属于 concepts/microarch 的「执行单元微架构」支线,向上承接 pipelining-basics 的延迟/吞吐概念与 vector-simd-execution-units 的执行单元版图,把两个参数落到 FMA 这个最要害的单元上。横向关联 fpu-divider-latency(延迟更长且不流水的兄弟单元)、execution-port-contention(吞吐端的争抢视角)、data-hazards-raw(依赖链的成因)与 avx512-downclock-license(宽向量下的频率修正)。向量化改造的方法论见 simd-vector-length-agnostic。
总结
FMA 延迟吞吐链讲的是乘加单元「延迟 4-5 拍、吞吐每拍 2 条」两个参数对代码性能的分治:存在 RAW 依赖链的代码被延迟锁死、每 4-5 拍才能推进一条 FMA、离峰值差近一个数量级;破解之道是把单链劈成 K ≥ 延迟×吞吐(典型 8)条独立链,用多累加器展开喂饱全部端口;排查时先代入公式算理论拍数,再看 FMA 端口每拍 uop 数是「太闲」而非「太挤」,最后用加倍累加器的对照实验一锤定音——浮点性能的账,从来都是先算链、再算端口、最后才轮到主频。