FPU 除法器延迟:浮点除法与开方为什么是微架构里最难喂的非流水线单元
更新时间:2026-10-03。在 CPU 乱序执行 搭建的舞台里,绝大多数执行单元是「全流水」的:浮点加法 3 到 4 个周期延迟,但每周期都能吃一条新指令,吞吐是每周期一条。唯独浮点除法和开方是个刺头——一条双精度除法动辄 13 到 20 个周期,而且除法器在被占用的整个期间不接收新指令,吞吐直接塌成「十几周期一条」。这篇「FPU 除法器延迟」专题回答这个刺头的全部来龙去脉:为什么除法不能像乘法那样流水铺开、SRT 迭代算法在硬件里长什么样、「可变延迟」的提前退出机制为什么让除法延迟变成一个分布而不是常数、以及这个又慢又独的单位怎么反过来卡住调度器和 IPC。上游背景见 CPU 微架构总览,与它争抢端口的邻居见 执行端口竞争。
本文要回答的问题
- 为什么浮点加法、乘法能全流水,除法和开方却被做成非流水线单元?
- SRT 迭代除法在硬件里怎么工作?基数 4、基数 16 差在哪?
- 「可变延迟」提前退出是什么?为什么同一条
divsd这次 13 周期、下次 19 周期? - 除法器被占住的那十几周期,调度器、发射队列和后续指令各自受到什么影响?
- 实际优化中怎么避开除法:倒数乘法、编译器标志、算法重写各有什么代价?
一、为什么除法不流水:迭代算法的本质约束
先看一组数字直觉(以近几代高性能 x86 核为参照):浮点加法延迟约 3 到 4 周期、全流水;浮点乘法延迟约 4 到 5 周期、全流水;融合乘加 FMA 约 4 到 5 周期、全流水;而双精度除法延迟 13 到 20 周期、非流水,双精度开方 18 到 27 周期、非流水。同一个 FPU 家族里,除法的延迟是加法的四五倍,吞吐差距还要再乘上「不可流水」这个系数——别人每周期收一条,它十几周期收一条。
为什么不做成流水?乘法可以流水,是因为乘法可以拆成「部分积生成 → 压缩树 → 最终加法」三段,各段之间数据上没有循环依赖,寄存器一拍一段就能铺开。除法不行。经典除法的基本循环是「用当前部分余数减去除数的某个倍数,得到新的部分余数」——下一次迭代必须等上一次的部分余数算出来才能开始,这是一个真正的串行递归,物理上就是一个组合逻辑块加一个寄存器反馈环。想吞吐翻倍,只能把这个迭代块复制多份展开成流水级,面积随基数线性甚至超线性膨胀,而除法在典型程序里的动态指令占比往往不到 1%,为它铺满流水级是赔本买卖。芯片厂商的账算得很清楚:除法器做成一个「一次只服务一条指令」的迭代盒子,接受它的低吞吐。
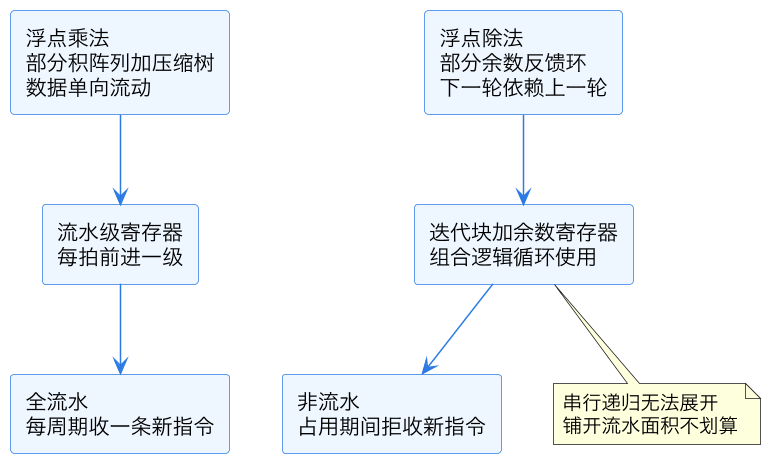
上图是两种数据流形态的对照:乘法的数据单向流过若干流水级,除法的数据在同一个迭代块里绕圈。这个「绕圈」就是后面一切特性的总根源——延迟高、不可流水、延迟可变,全是它的推论。
二、SRT 迭代:每周期吐几位商的硬件
除法器的主流实现是 SRT 除法(以 Sweeney、Robertson、Tocher 三人命名),开方则用同族的 SRT 开方算法,两者共享大部分硬件。SRT 的核心思想:每轮迭代从部分余数的高位和除数的高位查一张表(商数字选择表,QST),猜出本轮商数字属于某个小集合(比如基数 4 时是 -2、-1、0、+1、+2 五个值),然后做一次「部分余数 = 余数左移 - 商数字乘除数」的乘减,进入下一轮。允许商数字为负是个聪明的技巧——猜错了不要紧,后面的轮次可以用负数商数字把误差拉回来,这样查表就只需要看部分余数的高几位,不用等全精度比较,关键路径被压进一个时钟周期。
基数(radix)决定每轮吐出几位二进制商:基数 4 每轮 2 位,基数 16 每轮 4 位。双精度尾数 53 位,基数 4 需要约 27 轮,基数 16 需要约 14 轮——再扣掉预处理和规格化收尾,就是 13 到 20 周期这个量级的由来。基数 16 的代价是商数字选择表大得多、乘减的组合逻辑更宽,一轮差点塞不进一个周期,实际做法常是把两个基数 4 的迭代块级联起来「折叠」出基数 16 的效果。更高基数(基数 512 之类)只在开方里偶见,因为面积曲线实在太陡。
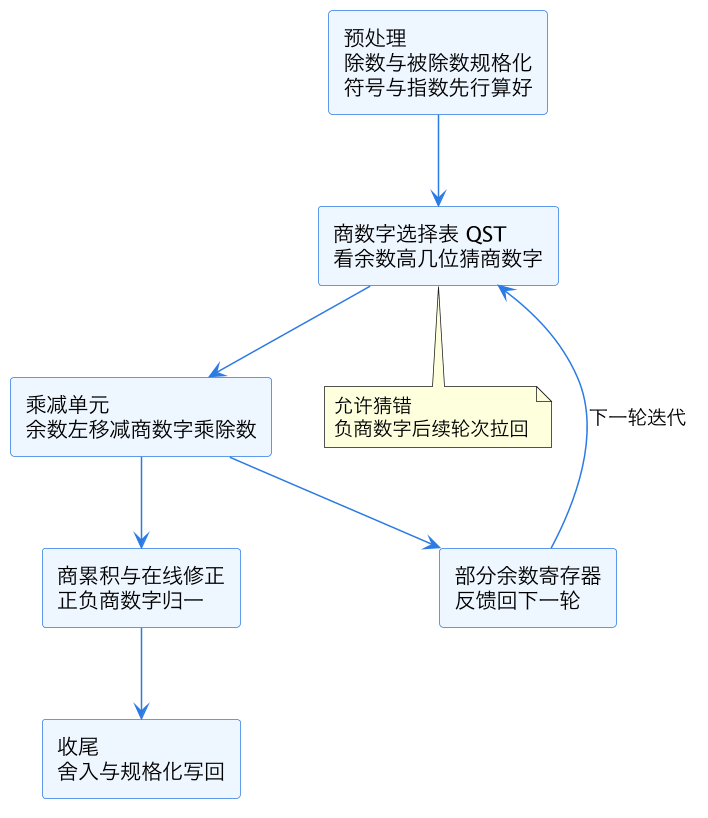
上图是 SRT 迭代盒子的内部结构。注意那条「下一轮迭代」的反馈箭头——它就是第一节说的串行环。每转一圈,商累积器里多两位(基数 4)或四位(基数 16)有效结果,直到位数凑满。除法器的面积大头在乘减单元和选择表,吞吐的枷锁在反馈环,两者都是「基数」这一个旋钮拧出来的。
三个结构的规模直觉:
| 方案 | 每轮商位数 | 双精度轮数 | 硬件代价 | 采用情况 |
|---|---|---|---|---|
| 基数 2 | 1 位 | 约 54 轮 | 最小 | 低功耗核、嵌入式 |
| 基数 4 | 2 位 | 约 27 轮 | 适中 | 曾经的主流 |
| 基数 16(两个基数 4 级联) | 4 位 | 约 14 轮 | 选择表和乘减明显变宽 | 当代高性能核主流 |
| 更高基数 | 6 位以上 | 更少 | 面积陡增 | 仅个别开方路径 |
三、可变延迟:提前退出让除法延迟变成一个分布
查硬件指令延迟表时会看到一个怪现象:很多核给除法标的不是单值,而是一个区间,比如「13 到 19 周期」。这不是文档偷懒,是真实的硬件行为——现代除法器有提前退出(early out)机制,当部分余数在某个中间轮次恰好变成零,或者商已经可以确定能在当前精度下正确舍入时,迭代提前终止,直接跳去收尾。被除数恰好是除数的整数倍、尾数低位全零这类「干净」操作数会显著缩短迭代;最狼狈的是某些非正规数(denormal)输入或输出,很多核根本不在除法器里处理,而是发射后很快 trap 进微码(microcode assist),用几十上百周期的微码序列慢慢算——这是延迟分布长长的尾巴。
这个特性对软件有可观测的后果。第一,基准测试里用固定操作数反复做除法,测到的可能是提前退出的短路延迟,换掉「干净」操作数延迟立刻跳涨,压测数据失真。第二,对调度器而言,除法的结果就绪时间不是编译期可知的常数:发射队列给除法的消费者安排唤醒时,如果按固定延迟拍醒(见 发射队列的唤醒选择 讲的确定性唤醒),除法这种可变延迟单元会破坏这个假设。实际做法是除法在接近完成时主动广播完成信号,消费者按信号唤醒而不是按倒计时唤醒——除法器是发射队列里「延迟不可预测户」的典型,和它同类的还有 L2 命中与否不确定的 load。
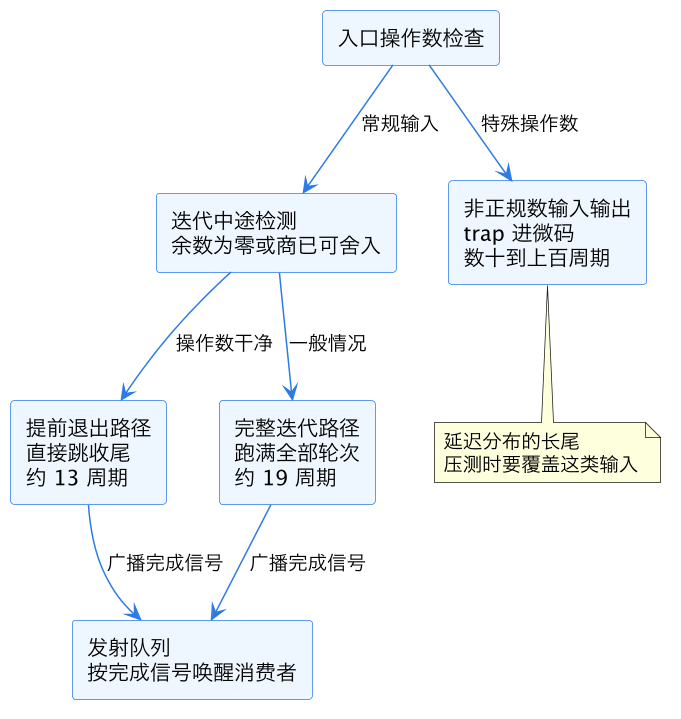
上图把三条延迟路径画在一起:提前退出、完整迭代、微码兜底。三条路最后殊途同归——完成信号到达发射队列,等结果的消费指令才被唤醒。这张图也解释了为什么除法延迟在微架构分析里要按分布建模,而不是按常数。
四、对调度与 IPC 的连锁影响
除法器被占用的那十几周期,整个后端都跟着买单,账分四笔。
第一笔是结果延迟链。依赖除法结果的那条指令要等满整个迭代,关键路径上平白多出十几周期——这一笔没法省,只能靠算法重写从源头减少除法。
第二笔是除法器独占。第二条除法(或开方,两者通常共享同一个迭代盒子)在前一条完成前根本进不了执行单元,只能在发射队列里干等。连续两条除法的最小间隔就是除法延迟本身,吞吐塌到十几周期一条。科学计算里做数组逐元素相除,瓶颈不是数据带宽,就是这个独占盒子。
第三笔是端口与写回冲突。除法器通常挂在某个浮点端口(x86 核里常见端口 0 或专门的除法端口)后面,迭代期间这条端口对其他短指令照常开放,但收尾写回那一拍要抢结果总线,和同端口的 FMA 写回可能撞车一拍。这种一拍级的冲突单独看无所谓,乘上 执行端口竞争 里讲的端口组合分布,在除法密集循环里会累积成可测的 IPC 下滑。
第四笔是投机窗口的占用。除法在 ROB 里躺十几周期,期间它占着 ROB 项、物理寄存器、发射队列项三样稀缺资源。如果它前面恰好有分支没揭晓,它还要以投机身份继续占着。ROB 大小与乱序窗口 讲的窗口资源经济学里,长延迟非流水指令是窗口利用率最差的一类住户。
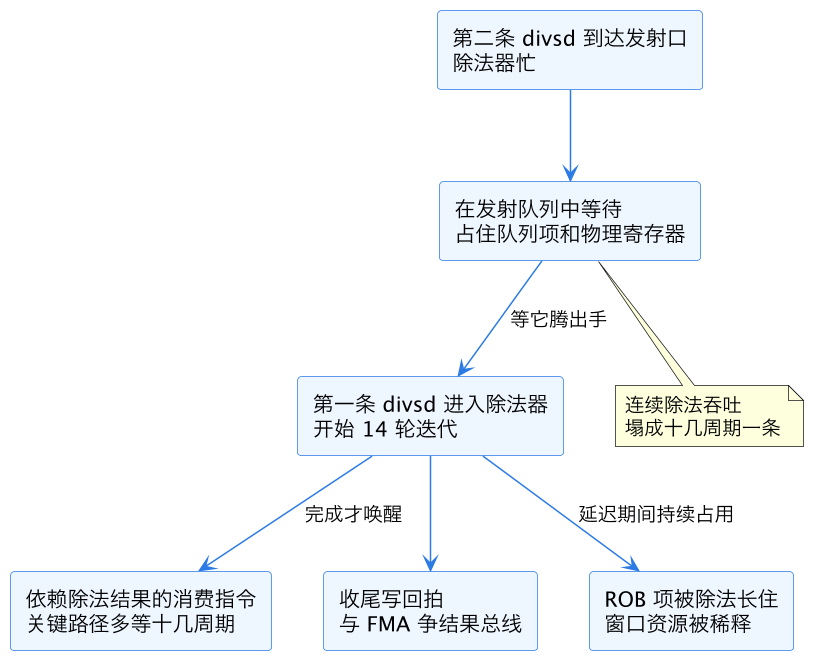
上图把四笔账画在同一场景里:一条除法进盒子,第二条堵在门外,消费者在睡,ROB 在陪住。四笔账合起来,就是为什么性能分析手册都把「热点代码里出现 divsd」列为红色信号——它伤的不只是自己那十几周期,还有周围一圈指令的资源供给。用 Top-down 分析方法 的语言说,除法密集代码往往同时点亮「后端绑定」里的多个格子,定位时要结合 IPC 瓶颈 的排查顺序逐项排除。
五、软件侧怎么绕:倒数乘法、编译器标志与算法重写
既然硬件帮不上忙,压力就传导到软件。三条主流绕行路线,各有代价。
路线一:除以常数改成乘以倒数。x / 3.0 写成 x * (1.0 / 3.0),编译器在常量折叠后自然这么做。代价是精度:两次舍入(倒数一次、乘法一次)对除不尽的有理数会引入最大约 1 到 2 个 ulp 的误差。IEEE 754 要求正确舍入的除法,乘倒数不满足,所以不开快速数学标志时,编译器只对「倒数恰好精确」的常数(2 的幂)做这个变换。
路线二:-ffast-math 一族标志(或 -freciprocal-math 单开)允许编译器对变量除数也生成「倒数近似加牛顿迭代修正」序列:先用硬件倒数近似指令(如 rcpss,精度约 12 位)拿初始值,再跑一到两轮牛顿-拉夫逊迭代把精度顶到接近正确舍入。整条序列 4 到 6 条指令,全走可流水的 FMA 单元,延迟链比除法长不了多少,吞吐却从「十几周期一条」变回「每周期一条」。SIMD 场景收益更夸张:向量除法本来要按通道排队过独占盒子,换成倒数乘序列后和其他向量算术一样全流水,配合 SIMD 向量执行单元 的宽度,除法密集循环常见 3 到 8 倍提速。代价依然是精度保证被打折。
路线三:算法级重写,把除法从热路径里彻底移走。归一化循环把「每个元素除以总和」改成「先算总倒数,再逐元素乘」;蒙特卡洛采样里把除法挪到预计算表;稀疏线性代数里把除以对角元改成预处理时存好逆对角元。这条路线不碰精度语义之外的风险,但需要重构代码结构。
| 路线 | 精度影响 | 吞吐收益 | 适用场景 |
|---|---|---|---|
| 常数改乘倒数 | 1 到 2 ulp 或无损(2 的幂) | 延迟链缩短数倍 | 除数为编译期常数 |
| 快速数学倒数序列 | 接近正确舍入但不保证 | 吞吐恢复全流水量级 | 向量除法密集、容忍微小误差 |
| 算法重写提倒数 | 语义等价或更优 | 除法彻底消失 | 归一化、预处理类热点 |
三条路线可以叠加:先把除法挪出内层循环,剩下的除法用倒数序列消化,常数部分交给编译器。做完以后回头看 执行端口竞争 的端口压力画像,除法器那一栏应该已经归零——这时热点才真正回到「可被乱序窗口和端口宽度喂饱」的常规优化轨道上。
这一篇在知识体系里的位置
本篇是微架构模块「执行单元专题」里非流水线单元的代表篇。上游框架文是 CPU 乱序执行 与 CPU 微架构总览,调度侧的近邻是 发射队列的唤醒选择(可变延迟单元的唤醒难题)、保留站(除法等待期间的栖身之所)、执行端口竞争(写回冲突与端口画像)。资源侧衔接 ROB 大小与乱序窗口 与 ROB 重排序缓冲。向量绕行方案见 SIMD 向量执行单元。性能诊断侧落点是 IPC 瓶颈 与 Top-down 分析方法。
总结
FPU 除法器延迟高且不可流水的根源,是除法与开方本质上是「部分余数反馈环」式的串行递归:SRT 迭代算法靠商数字选择表每轮只吐几位商(基数 16 每轮 4 位,双精度要跑约 14 轮),展开成流水面积不划算,于是被做成一次只服务一条指令的独占迭代盒子;它的延迟不是常数而是分布——干净操作数提前退出约 13 周期、一般情况 19 周期上下、非正规数直接掉进微码长尾——因此发射队列只能按完成信号唤醒消费者;被占用的十几周期里,第二条除法堵在门外、ROB 和物理寄存器被长住、收尾写回还和 FMA 抢总线,四笔账一起压低 IPC;软件侧的出路是把除法挪出热路径、常数除法改乘倒数、向量除法用快速数学的倒数加牛顿迭代序列恢复全流水吞吐——除法器是微架构里少有的「硬件救不了、只能靠算法和编译器绕着走」的单元。