LBR 分支记录:Last Branch Record 栈的用法与性能分析速查
更新时间:2026-10-05。性能分析里有一类问题特别难缠:采样告诉你在哪个函数里花了时间,却不告诉你「是从哪条路走进这个函数的」。LBR 分支记录(Last Branch Record,最近分支记录)就是为这个问题生的——CPU 内部维护的一个小栈,自动记录最近若干次分支跳转的源地址和目标地址,采样时随事件一起读出来,几乎不花额外开销。本篇是速查向的用法篇,背景原理可回看 分支预测 和 PMU 计数器编程,同门的精确采样见 PEBS 精确事件采样,更重的全量追踪见 Intel PT 指令追踪。
本文要回答的问题
- LBR 栈里到底存了什么?一条记录包含哪些字段?
- 深度从 8 对涨到 32 对,架构过滤位能筛掉哪些分支?
- perf 里
-b和-j怎么用,输出怎么读? - 性能分析与调试场景下,LBR 分支记录比调用栈采样强在哪、弱在哪?
一、栈结构:一个硬件环形缓冲区
LBR 的本质是一组「源地址、目标地址」寄存器对,按环形缓冲组织:CPU 每退休一条发生跳转的分支指令(含调用、返回、间接跳转,视配置而定),就把「这条分支指令的地址」和「跳到哪去」写进栈顶,写满一圈后最老的记录被覆盖。栈顶指针在 IA32_LBR_TOS(Top of Stack)寄存器里,记录体在 FromIp/ToIp 寄存器阵列中。
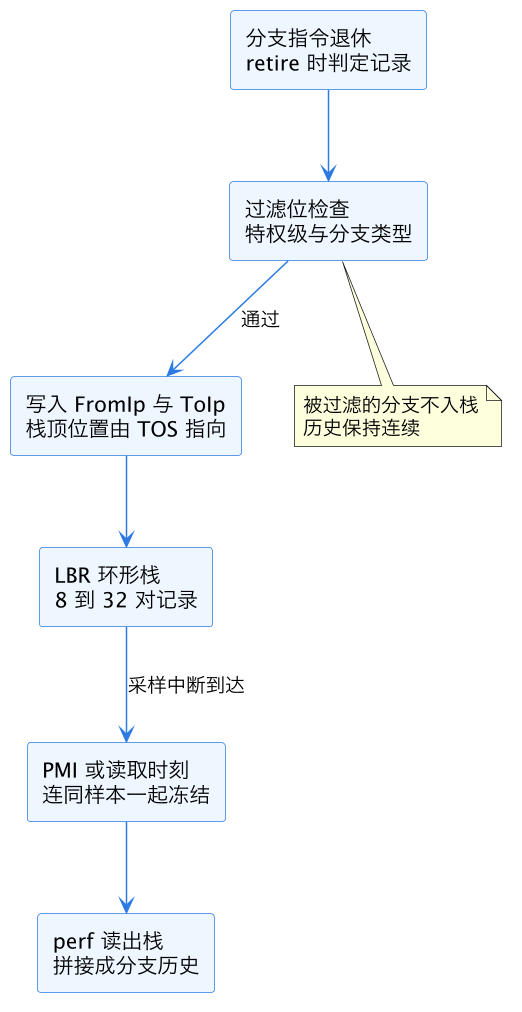
上图是 LBR 分支记录的写入与读出路径:分支在退休阶段被过滤位筛一遍,合格的进环形栈,等 PMU 采样中断(PMI)到达时整栈随样本冻结读出。注意栈是被「冻结」而不是「清空」——下一次采样读到的历史里可能还留着上一次的尾巴,perf 会按 TOS 指针正确解析。
每条记录除了 FromIp/ToIp 两个地址,近代实现还附带几个标志位:这条分支是否被误预测(mispredict)、是否处于 TSX 事务内、是否预测命中。其中「误预测位」价值最大——它让 LBR 不只是路径记录仪,还是一台误预测现场的照相机。
二、深度与过滤位:能看多远、能筛什么
LBR 深度随微架构代际演进:
| 微架构世代 | 栈深(记录对数) | 备注 |
|---|---|---|
| NetBurst / Core 2 | 4 / 8 | 早期实现,功能有限 |
| Nehalem 到 Haswell | 16 | 引入特权级与类型过滤 |
| Skylake 到 Icelake | 32 | 深度定型 |
| Goldmont(Atom) | 8 到 32 | 依型号不同 |
32 对听起来不少,但一次函数调用加返回就占两对,实际「视野」往往只有十几个有意义的跳转——够回溯一段热循环的迭代历史,不够回溯整条调用链。想要更深就得靠 Intel PT 那种全量追踪,代价是数据量爆炸。
过滤位在 IA32_LBR_SELECT(或新架构的 LBR_SELECT / ARCH_LBR_CTL)寄存器里,常用筛法包括:只记用户态分支(CPL_EQ_0)、只记内核态分支(CPL_NEQ_0)、不记条件分支(JCC 之外)、不记近调用、不记近返回、不记间接跳转。过滤的价值在于「省深度」——把不感兴趣的分支挡在栈外,有限深度的每一对都花在刀刃上。
三、perf 用法:-b 与 -j 两条命令
日常用到的就两条命令。一是 -b(等同 --branch-filter any),在采样时顺手套取 LBR 栈:
perf record -b -e cycles ./a.out
perf report --branch-history --no-children --percent-limit 2
报告视角会从「函数平铺」变成「分支历史片段」,每个样本下面挂一串最近的 from/to 对。二是 -j(--branch-filter 的完整形态),可以精细指定过滤组合:
perf record -j any_call,any_ret -e cycles:u ./a.out
perf record -j u,save_type -e cycles ./a.out
any_call 只记调用、any_ret 只记返回、u/k 限定特权级、save_type 保存分支类型字段。只记调用加返回时,LBR 分支记录就退化成一个「浅调用栈」——32 对深度大约对应 16 层调用,配合 perf report 的调用图模式,在没有帧指针、也没有 DWARF 展开信息的二进制上(比如 -fomit-frame-pointer 编译、 stripped 的库)也能给出可用的栈。这是 LBR 最经典的救场场景。
读输出时有个方向性细节:报告里历史是按「时间从新到旧」还是「从旧到新」排列,取决于 perf 版本与排序选项,看 from → to 链是否首尾相接即可判断,接不上说明顺序反了或中间有被过滤的分支。
四、分析场景:误预测归因与调用栈重建
LBR 分支记录在性能分析里的高光场景有三个。第一是误预测归因:配合记录里的 mispredict 标志,perf report --branch-history 能直接列出「哪条间接跳转 / 条件分支贡献了最多的误预测」,比在源码里盲猜 switch 还是虚函数调用省一轮 instrumentation。原理背景见 分支预测 与 TAGE 预测器——当你理解了预测器为什么猜错,再看 LBR 给的现场地址,改法(重排分支、用查找表消分支、PGO 反馈布局)就顺理成章。
第二是调用栈重建,上一节说过,不赘述。第三是调试疑难控制流:比如「这个函数明明有早退路径,谁在触发早退」「这个回调到底是从哪个事件循环进来的」。gdb 断点只能看到当前这一层,LBR 给出的是「怎么走到这一层」的最后几步,对时序敏感、一加断点就消失的 bug 尤其有效。新内核甚至支持 perf record -j any,save_type 后配合 perf script 逐样本还原分支序列,等于一段免插桩的迷你执行轨迹。
| 维度 | LBR 分支记录 | 调用栈采样(fp/dwarf) | Intel PT |
|---|---|---|---|
| 开销 | 近零 | 低到中 | 中到高 |
| 历史深度 | 8 到 32 对 | 完整栈 | 全量轨迹 |
| 需要二进制配合 | 否 | 需要帧指针或 DWARF | 否 |
| 含误预测信息 | 是 | 否 | 需后处理 |
| 适合场景 | 误预测归因、浅栈、路径回溯 | 常规热点分析 | 全量控制流还原 |
选择上,经验法则是:常规火焰图先用 dwarf/fp 栈;栈断了或怀疑误预测,换 LBR;要还原「崩溃前几毫秒里所有控制流」这种终极问题,才上 Intel PT 指令追踪。三者不是替代关系,是逐层加深的工具链。
五、坑位速查
用 LBR 分支记录容易踩的坑集中在四处,先说一处与硬件代际相关的:32 对深度只在 Skylake 之后的服务器与桌面核上成立,手里的机器到底多深,用 perf record -b true 抓一条再看 perf script -F brstack 输出数一下记录数最稳妥,别照抄文档里的数字。其馀四处如下。其一,虚拟机里 LBR 常被禁用或深度被削,云主机上 perf record -b 报「LBR not supported」先去查 hypervisor 的 PMU 透传配置。其二,与 PEBS 精确事件采样 同时开启时,LBR 数据随 PEBS 记录走,语义更好但部分老内核组合有 bug,出现异常栈先关掉一个试试。其三,过滤位配置不当会让历史「跳帧」——只看 u 态时一次系统调用前后的分支接不上,这是正常现象不是数据损坏。其四,上下文切换会清空 LBR 栈,所以采样频率低于进程切换频率时,栈里可能混着上一个进程的历史,解读时先看样本的 pid 归属再信分支链。
这一篇在知识体系里的位置
本篇属于 microarch 层 PMU 观测工具链的速查篇:上游概念是 分支预测、误预测恢复路径 和 PMU 计数器编程,同层的兄弟篇是 PEBS 精确事件采样(采样精度半边)与 Intel PT 指令追踪(全量追踪重器),顶层入口回 CPU 微架构总览。LBR 分支记录是这三件套里最轻的一件,也是日常 perf 工作流里最先该想到的一件。
总结
LBR 分支记录是 CPU 自带的最近分支历史栈:退休时把「从哪跳到哪」写进 8 到 32 对的环形缓冲,perf 一条 -b 或 -j 命令就近零开销读出,配合误预测标志位可做误预测现场归因、可在无帧指针二进制上重建浅调用栈,是介于普通采样与 Intel PT 全量追踪之间的轻量利器。