DRAM 子系统:channel、rank、bank、row buffer、refresh 与内存调度器协同全景
更新时间:2026-10-02。本站在 DRAM 方向已经攒下了一组长尾深文:DRAM row buffer 命中策略 讲行缓冲的开闭抉择,DRAM bank 并行与 rank 讲内部并发结构,DRAM refresh 管理 讲刷新开销,内存控制器 FR-FCFS 调度 讲请求重排算法,内存通道交织 讲多通道地址映射。每篇都深入一个零件,但读者最常问的问题其实是:这些零件装在一起长什么样?一次
mov指令的 cache miss 从 CPU 出发,到底经过了 DRAM 子系统的哪些层级,每一层做了什么决定,互相之间又怎么配合?本篇就是回答这个问题的枢纽文——把 channel、rank、bank、row buffer、refresh、调度器六个概念放进同一张地图,讲清它们各自的职责边界和协同时序。
本文要回答的问题
- DRAM 子系统从 CPU 到存储颗粒,完整层次是哪几级,每级解决什么问题?
- channel、rank、bank 三级并发有什么不同,为什么不能混为一谈?
- row buffer 命中、行缺失、bank 冲突这三种结局的延迟差多少,由什么决定?
- refresh 在什么时候偷带宽,它和正常读写请求怎么抢资源?
- 内存控制器调度器如何在「局部性、公平性、时序约束」三者之间做取舍?
一、全景:从一次 cache miss 到 DRAM 颗粒的完整路径
先把整件事的骨架立起来。一次 LLC(最后一级缓存)miss 之后,请求离开 CPU 核心,经过片上互连(环形总线或 mesh,见 Uncore 环形与 Mesh 互连)抵达内存控制器。从这一刻起,请求进入 DRAM 子系统的地盘,要依次穿越五层结构:
- channel(通道):一组独立的地址/命令/数据总线。一颗现代服务器 CPU 通常有 8-12 个 DDR5 通道,每个通道完全独立工作,带宽叠加。请求到达内存控制器后,第一件事就是根据物理地址的交织规则被路由到某个 channel 的队列里。
- DIMM 与 rank(插槽与秩):一个 channel 上插一到两条 DIMM,一条 DIMM 上有一到多个 rank。rank 是「共用同一条命令总线、同一时刻只能有一个在传数据」的一组芯片。同 channel 的多 rank 共享数据总线,所以 rank 之间不是真并行,是时分复用。
- bank group 与 bank(堆):每个 rank 内部切成若干 bank(DDR5 是 32 个,分 8 组)。bank 才是 DRAM 内部真正的并行单元——每个 bank 有自己独立的行译码器和 row buffer,可以各自激活不同的行。
- row 与 column(行与列):bank 内部是一个电容阵列,一次激活(ACTIVATE)把整行(典型 1-2KB)搬进 row buffer,之后的读写(READ/WRITE 按列寻址,一次 64B)都在 row buffer 上进行。
- cell(存储单元):最小单位,一个晶体管加一个电容存一个比特。电容会漏电,所以每隔几十毫秒必须全片刷新一遍——这就是 refresh 的由来。
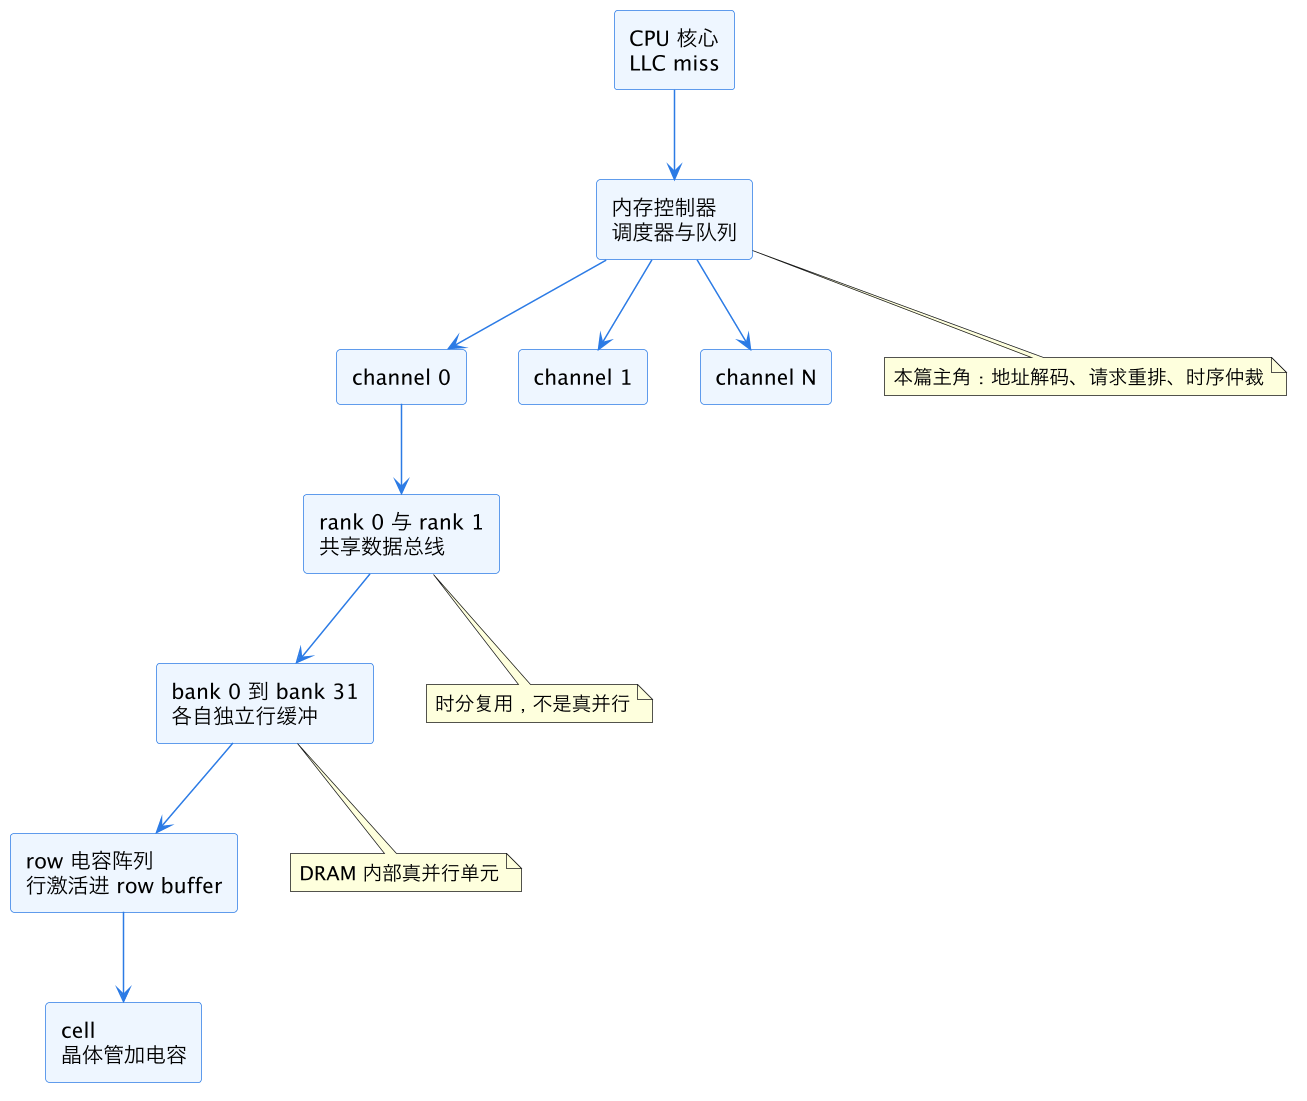
上图就是 DRAM 子系统的层次骨架。记住三个关键判断:channel 之间是完全并行(各自有独立总线);rank 之间是总线时分复用(共享 channel 的线,靠片选信号轮流用);bank 之间是内部真并行(各有各的 row buffer,可以同时处于不同的行激活状态)。这三句话是理解后续一切调度行为的地基。
物理地址到这五层结构的映射,是内存控制器上电时由地址解码逻辑定死的。典型映射把地址低位切成「列内偏移 → 列号 → bank 号 → rank 号 → channel 号 → 行号」,其中 channel 选择位刻意放在较低位(往往就在 cache line 粒度附近做哈希),让连续地址流均匀打散到所有 channel——这正是 内存通道交织 那篇的主题。bank 与 channel 的选择位通常还要经过一次 XOR 哈希,防止某些规则访问模式(比如大跨度 stride)把所有请求砸进同一个 bank。
在展开之前先回答「为什么 DRAM 要被设计成这么多层」。根本原因是成本与物理的妥协:单个 DRAM 单元便宜到离谱(每比特成本是 SRAM 的十分之一以下),但电容充放电就是快不起来,行激活那十几纳秒三十年只缩短了一倍多点,而同期 CPU 主频涨了几十倍。DRAM 厂商没法让单次访问变快,只能在「单位面积里塞更多可并行工作的结构」上做文章——于是有了 bank、bank group、rank、channel 这一层层把「慢」藏起来的结构。理解 DRAM 子系统的层次,本质上就是理解「这个行业为了掩盖电容的慢,叠了多少层甲」。
二、三级并发:channel、rank、bank 各自能给你多少并行度
「我的机器有 8 通道内存,为什么带宽跑不满标称值的八分之一?」这类问题的答案,几乎都在三级并发的区别里。
channel 级并发最值钱:每个 channel 有独立的数据总线,8 通道 DDR5-4800 的理论带宽就是单通道 38.4GB/s 乘 8,约 307GB/s。但要吃到它,访问流必须被交织规则均匀打散——如果程序按 256MB 的大步长跳着访问,很可能所有 cache line 都落在同一个 channel 上,其余七个 channel 全程看戏。
rank 级并发常被误解为并行,其实它是流水线式的重叠。同 channel 两个 rank 共享数据线,不能同时传数据,但可以在 rank 0 传数据的同时给 rank 1 发 ACTIVATE 做准备工作(这叫 rank interleaving 或 bank-group 间重叠)。数据总线是 DRAM 子系统里最稀缺、最贵的资源,所有调度技巧的终极目标都指向一句话:让数据总线的有效利用率尽量接近 100%,别让气泡出现在总线上。
bank 级并发是隐藏延迟的主力。DRAM 的时序参数(tRCD、tRP、tRAS、tFAW 等,下一节细说)规定了同一个 bank 两次操作之间的最小间隔,但不同 bank 之间这些约束宽松得多。所以只要调度器能把连续的请求散到不同 bank,前一个 bank 还在等 tRCD 的时候,后一个 bank 的数据已经能上总线了。DDR4 引入的 bank group 进一步把「同组 bank 间切换」和「跨组 bank 间切换」分开定价:跨组切换的间隔(tCCD_L)比同组(tCCD_S)更长,调度器排请求时得连这一层也算进去。
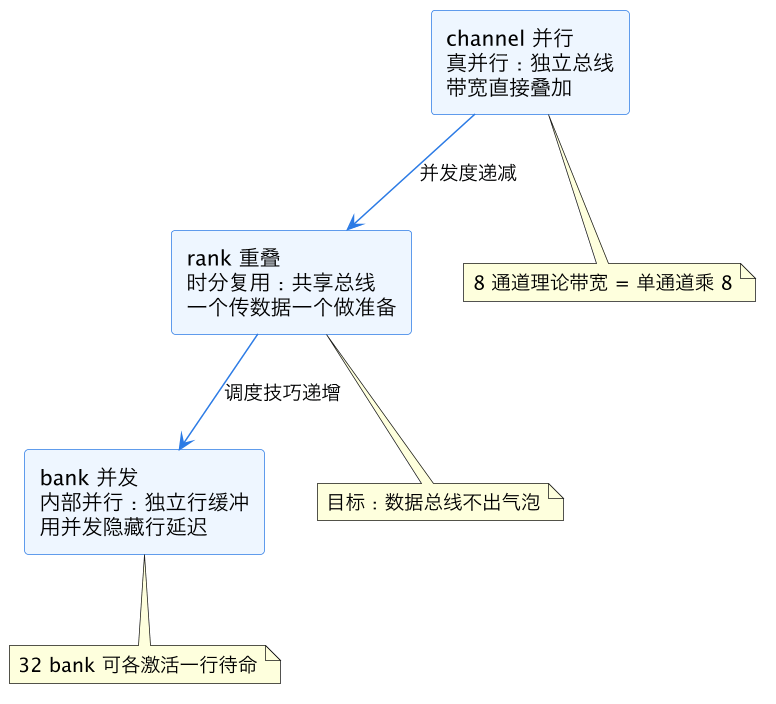
上图把三级并发按「并行真实性」排了个序。一个量化直觉:单 channel 内,靠 bank 级并发通常能把实际带宽推到标称值的 70-90%;而完全串行、每次都 bank 冲突加行缺失的最坏路径,只能拿到 10% 上下。中间这将近一个数量级的差距,就是 DRAM 子系统调度存在的意义,也是性能剖析时「内存带宽跑不满」首先要怀疑的地方。
还有一个常见的误解需要澄清:插满 DIMM 不等于带宽翻倍。把单 rank 的 DIMM 换成双 rank,带宽提升来自 rank 间重叠带来的总线气泡减少,典型收益是 5-15%,而不是天真的一倍——因为数据总线还是那一条。反过来,把单通道换成双通道是实打实的一倍,因为总线本身多了一份。买内存、配服务器时「通道数」永远是第一指标,「每通道 rank 数」只是锦上添花的调度裕量。这个区分在容量规划时尤其值钱:预算有限时,优先把通道插满、让每个通道挂一条单 rank DIMM,往往比少数通道挂满双 rank DIMM 收益更大。
三、row buffer:一次访问的三种结局
请求进了某个 bank,结局只有三种,延迟天差地别:
- row buffer 命中(page hit):要访问的行正好已经在这个 bank 的 row buffer 里,直接发 READ/WRITE 取列数据,延迟只有 tCL 量级(约 13-15ns)。
- 行缺失但 bank 空闲(page empty/miss):row buffer 是空的或已被预充,先发 ACTIVATE 把目标行搬进 row buffer(tRCD 约 13-15ns),再发 READ。总延迟翻倍。
- bank 冲突(page conflict):row buffer 里开着的是另一行,必须先发 PRECHARGE 把它写回电容阵列(tRP 约 13-15ns),再 ACTIVATE 新行,再 READ。总延迟三倍。
这个三档结构决定了 DRAM 访问的「延迟不是常数而是分布」:同一条 load 指令,命中 row buffer 时内存侧开销约 40ns,bank 冲突时能到 90ns 以上,再叠加上排队等待,尾部延迟可以冲到数百纳秒。性能剖析工具看到的「平均内存延迟」其实是这三种结局按访问模式加权的混合值。
row buffer 开多久、什么时候预充,又是一个策略问题:命中后立刻预充(closed page)对下一次随机访问友好;保持打开(open page)赌下一个请求还是同一行。现代内存控制器普遍用自适应策略:观察每个 bank 的命中率动态切换。这部分的完整展开见 DRAM row buffer 命中策略,这里只需要记住结论:row buffer 是 DRAM 子系统里唯一的「缓存」,它的命中率直接坐在内存延迟的分子上。
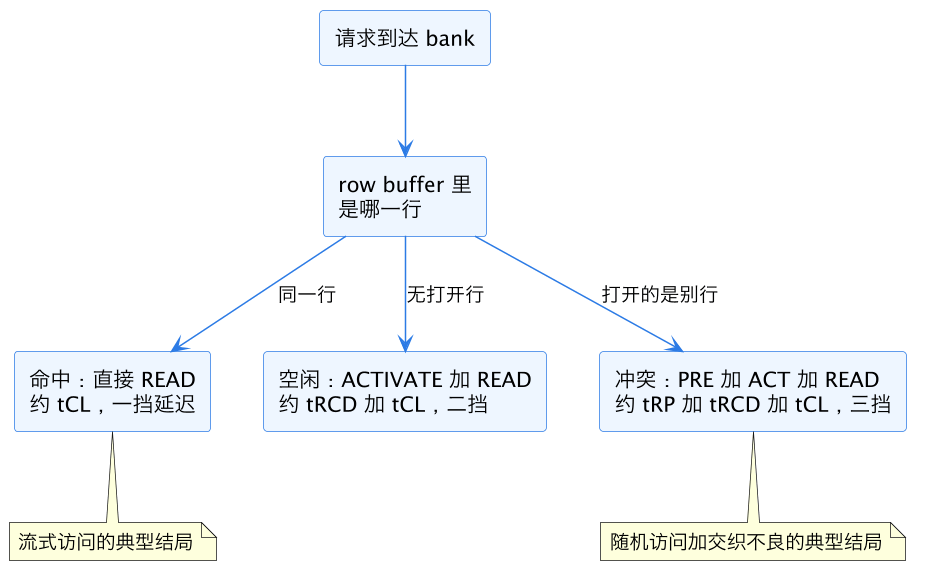
上图是单个 bank 内的裁决逻辑。注意一个容易忽视的点:行的大小(1-2KB)远大于 cache line(64B),所以哪怕程序只是「顺序读 2KB」,也会在同一个 row buffer 里连续命中 16-32 次——这就是为什么流式负载的内存延迟远低于随机负载,差距主要不在缓存而在 DRAM 这一层。
把三种结局和上一节的 bank 并发合起来看,还能推出一个反直觉的结论:对随机访问负载,「地址散得越开」越好,但散开的目标不是 cache 冲突域,而是 bank 域。两个相隔很远的地址如果哈希到同一个 bank 的不同行,照样排队互撞;两个相邻地址如果落在不同 bank,反而可以并发推进。DRAM 子系统眼里的「局部性好」和 cache 眼里的「局部性好」不是同一个概念——cache 喜欢空间紧凑,DRAM 调度器喜欢「同行内紧凑、跨行间散开」。地址交织哈希的设计正是按这个口味调出来的。
四、时序参数:调度器头上的紧箍咒
DRAM 调度器不是想怎么排就怎么排,它每发一条命令都要查一遍时序约束表。这些参数来自 DRAM 芯片的物理特性——电容充放电、信号建立时间——违反任何一条,读出来的就是错数据。最常打交道的有这么几个:
| 参数 | 含义 | DDR5-4800 典型值 | 约束的是 |
|---|---|---|---|
| tCL | 列读延迟,发 READ 到数据上总线 | 约 13.3ns | 每次读 |
| tRCD | ACTIVATE 到可发 READ | 约 13.3ns | 行激活 |
| tRP | PRECHARGE 到可再 ACTIVATE | 约 13.3ns | 行关闭 |
| tRAS | ACTIVATE 到允许 PRECHARGE | 约 32ns | 行最短打开时间 |
| tRC | 同 bank 两次 ACTIVATE 间隔(tRAS+tRP) | 约 45ns | bank 周转率 |
| tCCD_S / tCCD_L | 同组/跨组 bank 两次列访问间隔 | 不同 | 数据总线节奏 |
| tFAW | 滚动 32ns 窗口内最多 4 次 ACTIVATE | 约 21-32ns 窗口 | 供电电流峰值 |
| tRFC | 一次 refresh 占用 bank 的时间 | 数百 ns | refresh 开销 |
这张表里最值得展开的是 tFAW(Four Activate Window):它限制的不是单个 bank,而是整个 rank 的激活频率——任何 32ns 窗口里最多 4 次 ACTIVATE。原因是每次激活行都是一次大电流充放电,瞬时电流太猛会拉垮供电网络。这意味着即使 32 个 bank 全都有活干,激活命令也得按节拍来,bank 级并发是有天花板的。
时序参数之间还会互相咬。比如一个 bank 刚 ACTIVATE 完,调度器想给它发 READ,不但要满足 tRCD,还要看数据总线那时候是不是被别的 bank 占着(总线 turnaround 时间 tWTR、tRTW);读写方向切换本身也有惩罚——同一条总线上「读后面跟写」比「读后面跟读」贵好几个周期。这就是为什么调度器倾向把读和写分批(read/write grouping):攒一批读发完,翻转一次总线方向,再发一批写。
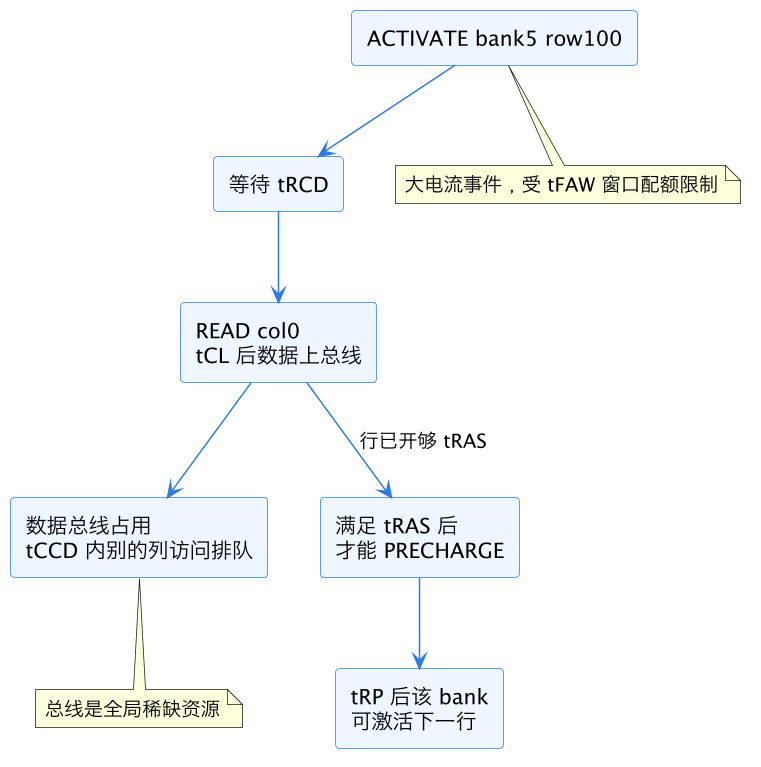
上图是一条「激活-读-关闭」完整序列上的时序约束标注。DRAM 子系统的所有性能问题,说到底都是这张时序网和「请求到达模式」之间的匹配问题:请求模式顺(连续、同 bank 同行、同方向),时序约束几乎不产生等待;请求模式逆(随机、跨行、读写交替),每一条约束都跳出来收一次税。
五、refresh:周期性的带宽税
DRAM 的存储原理是电容电荷,而电容漏电,所以每个 cell 的电荷最多保持几十毫秒(JEDEC 规范 64ms,高温下减半到 32ms)就必须重写一次。全片几十亿个 cell,刷一遍是 DRAM 子系统无法回避的固定税。
刷新的组织方式是按行分批:内存控制器每 7.8μs(tREFI,64ms 除以 8192 行批)向每个 rank 发一条 REF 命令,rank 内部一次性刷新若干行,期间该 rank 的所有 bank 停止服务,持续 tRFC(随容量增大,DDR5 大容量颗粒可到 400ns 以上)。粗算一下:tREFI 7.8μs 里被 tRFC 占掉 400ns,光刷新就吃掉了约 5% 的带宽;温度翻倍到 85°C 以上进入 3.9μs 刷新档,税率直奔 10%。
refresh 和正常请求抢资源时还有两个细节。第一,REF 命令不可推迟太久——规范允许最多推迟 8 拍(postponed refresh),调度器常利用这个弹性把 REF 攒到请求空窗期再补发,减少对延迟敏感请求的干扰。第二,现代颗粒支持 same-bank refresh(DDR5 的 refresh management),一次只刷一个 bank 而其余 bank 照常服务,把「全 rank 停摆」细化成「单 bank 停摆」,对银行级调度友好得多。刷新管理的完整讨论见 DRAM refresh 管理。
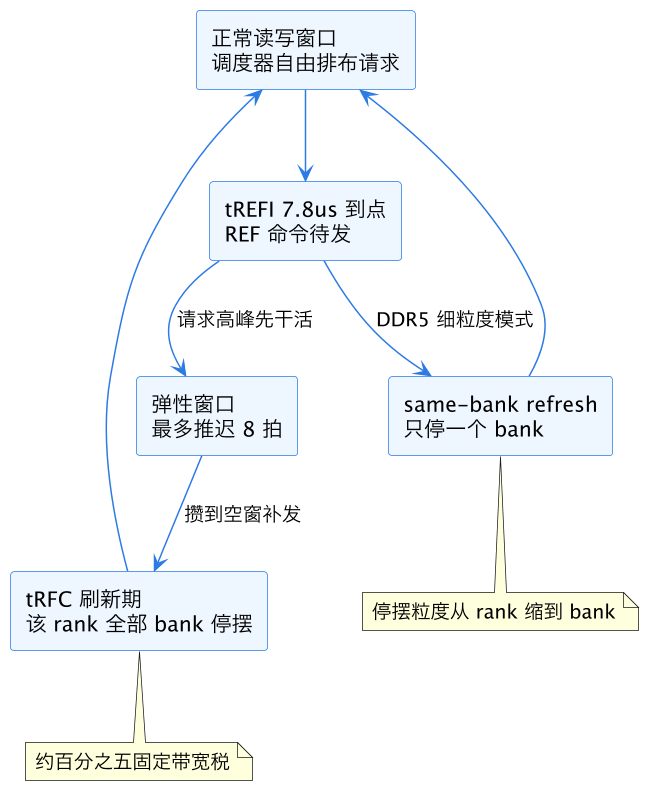
上图是刷新在调度时间线上的位置。对性能剖析的实践含义是:如果你用高精度工具观察内存延迟分布,会看到每隔约 7.8μs 出现一个小的延迟隆起——那不是程序的问题,是 refresh 在收税。做延迟敏感业务(如内存数据库、行情系统)的容量规划时,这 5-10% 的刷新税必须算进带宽预算,不能按标称带宽满打满算。
六、调度器:把所有约束编成一张时刻表
前五节讲的每一层——channel 路由、rank 复用、bank 并发、row buffer 三档结局、时序紧箍咒、refresh 弹性——最终都汇聚到内存控制器里的请求调度器。它是 DRAM 子系统的大脑,每周期从队列里挑一条「合法且划算」的命令发到总线上。
调度器面对的是一个多目标优化问题,目标之间互相打架:
- 行缓冲局部性:优先发能命中已打开行的请求(row-hit-first),延迟最低。
- bank 并行度:适当把请求散到不同 bank,避免所有压力挤在一个 bank 的 tRC 周转上。
- 读写分批:减少总线方向翻转次数。
- 公平性与饿死:一味优先行命中的请求,落在「冷门行」上的请求可能永远排不上——某个核的 load 被无限推迟,在全序敏感场景(持锁期间访存)会拖累整个系统。
- 刷新与掉电管理:REF 命令、自刷新进出也要插进时刻表。
其中公平性问题值得单独展开几句,因为它是教科书和真实系统差距最大的地方。纯 FR-FCFS 在多核共享内存控制器时有一个隐蔽的坑:访存模式「行缓冲友好」的线程(比如顺序扫描)会系统性插队到「行缓冲不友好」的线程(比如指针追踪)前面,后者的不公平程度可以差出数倍,而且它往往正是延迟敏感的那个。真实处理器为此加了多层补丁:aging 计数器让等待过久的请求无视行命中规则直接提权;按线程或按 QoS 等级的队列隔离让高优先级请求走快车道;有些实现还会检测「某个核的 ROB 头被这条 load 卡住」的信号做关键路径优先。这些机制的共同思想是把「谁等得起」的信息注入调度,而不只看「哪条命令最省 DRAM 时间」。
工业界的主流答案是 FR-FCFS(First-Ready First-Come-First-Serve):在所有「时序上已就绪」的请求里,优先选 row buffer 命中的;平手时按到达顺序(先来先服务兜底公平)。就绪(ready)这个词是关键——一条命令如果违反 tRCD/tFAW 等任何约束,连参选资格都没有,调度器只在合法集合里做优化。FR-FCFS 的算法细节、饿死防护(aging 机制,老请求逐步提优先级)、以及更现代的变体(如按线程分批的 BLISS、感知临界区的调度)在 内存控制器 FR-FCFS 调度 里有专篇,这里给出它在全局中的位置。
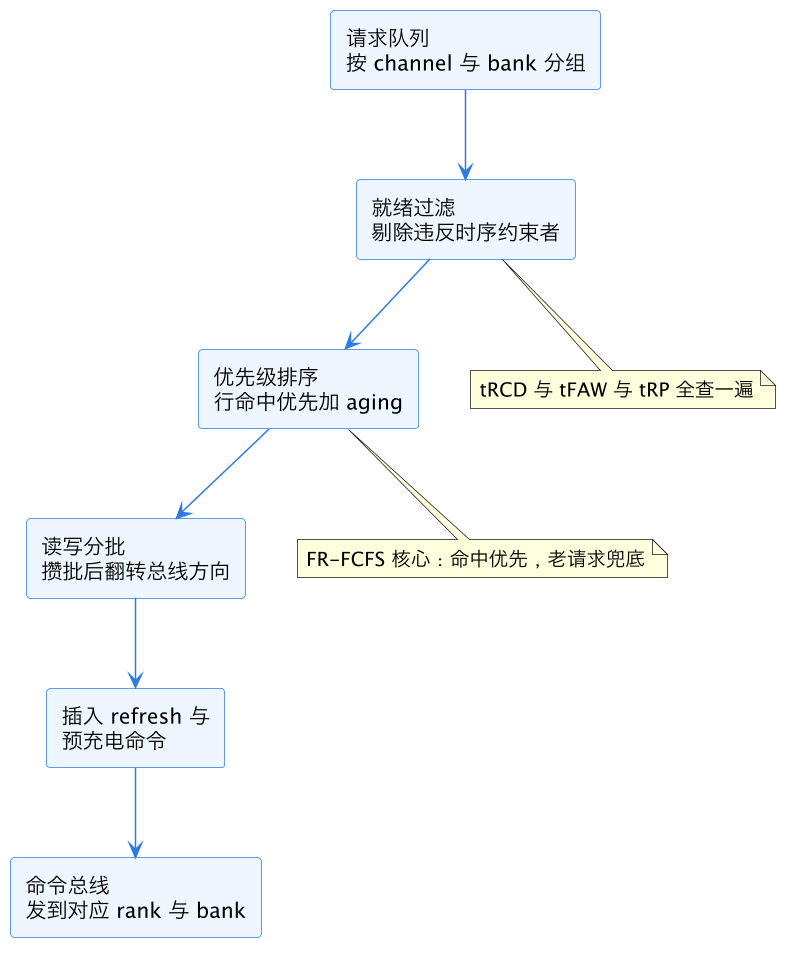
上图是调度器一个周期的决策流水线。可以用一句话概括 DRAM 子系统的设计哲学:DRAM 颗粒本身是慢且脾气古怪的,所有的聪明都花在「别让它的坏脾气暴露给 CPU」上——用 bank 并发藏 tRCD,用 row buffer 藏 ACTIVATE,用调度器藏总线翻转,用 refresh 弹性藏刷新停摆。理解了这一层,再回头看 DRAM bank 并行与 rank 里那些看似琐碎的结构细节,会发现每一条都是在为这张时刻表争取腾挪空间。
最后给一个排查视角的对照表,把「观察到的症状」映射回「子系统里哪一层在收税」,这是本篇作为枢纽文最实用的交付物:
| 症状 | 最可能的层级 | 验证手段 |
|---|---|---|
| 带宽远低于标称,访问有大步长 | channel 交织失效 | 数 per-channel 计数器,看是否偏斜 |
| 平均延迟高且分布宽 | bank 冲突或行缺失多 | perf c2c、IMC 的 row-hit 计数器 |
| 延迟每 7.8μs 周期性隆起 | refresh 税 | 高精度延迟直方图 |
| 随机访问延迟是流式的三倍 | row buffer 三档结局 | 对比顺序与随机指针追踪 |
| 多核下个别线程延迟暴涨 | 调度器公平性 | 绑定核对比单跑与混跑 |
| 高温环境下带宽再掉一截 | 刷新切 3.9μs 档 | 看温度与 tREFI 档位 |
这一篇在知识体系里的位置
本篇是微架构模块 DRAM 线的枢纽,向上承接 CPU 微架构总览 里「内存墙」的命题,向下分发到五篇零件级深文:行缓冲策略见 DRAM row buffer 命中策略、内部并发结构见 DRAM bank 并行与 rank、刷新开销见 DRAM refresh 管理、调度算法见 内存控制器 FR-FCFS 调度、多通道地址映射见 内存通道交织。横向相关的,是请求进入 DRAM 之前的两段路:片上互连见 Uncore 环形与 Mesh 互连,跨插槽访问的延迟放大见 NUMA 本地与远端访问延迟。读完本篇再读任何一篇零件文,都会多一份「这个零件在整机里替谁擦屁股」的全局感。
总结
DRAM 子系统是一台用调度对抗物理的机器:channel 提供真并行、rank 在共享总线上时分复用、bank 用内部并发隐藏行延迟、row buffer 把一次访问分成命中/缺失/冲突三档结局、tRCD/tFAW 等时序参数给每条命令划红线、refresh 每 7.8μs 收一次带宽税,而 FR-FCFS 调度器每周期在「合法命令集合」里按行命中优先加公平兜底的原则编排这一切——看懂这六层怎么咬合,就拿到了分析一切内存带宽与延迟问题的地图。