写无效与写更新:缓存一致性里"作废拷贝"和"同步新值"的带宽延迟之争
承 目录与监听一致性——那一篇回答的是"状态变更怎么送达其他核"(广播还是查花名册),但没有展开另一个同样根本的问题:送达的内容是什么?核 A 改了地址 X,其他核手里的旧拷贝有两条路:要么被作废(write invalidate,下次要用自己重新取),要么被同步更新成新值(write update,下次直接命中)。写无效与写更新的取舍是每一条一致性协议都要回答的设计题,它直接决定互连带宽花在哪儿、读延迟坏在哪儿。状态机本身的流转见 mesi-protocol 与 msi,本篇聚焦两种写策略的代价对比与混合方案的工程智慧。
本文要回答的问题
- 写无效和写更新在消息流上差在哪,一次写操作各发几条消息、多少字节?
- 为什么说写无效省带宽、写更新省延迟,这个 tradeoff 的拐点由什么决定?
- 连续写同一行 N 次时,两种策略的带宽消耗差多少倍?
- Dragon 和 Firefly 这两个经典混合协议是怎么"看情况选策略"的?
- 为什么今天所有商用 x86/ARM 处理器清一色用写无效,写更新死透了吗?
一、问题的起点:写完一个字,别人手里的旧值怎么办
场景钉死:核 A 和核 B 都缓存了地址 X(都是 S 状态,只读共享),现在核 A 往 X 写了一个新值。一致性要求很朴素——核 B 之后再读 X,绝不能读到旧值。实现这个要求,协议只有两种基本动作:
- 写无效(Write Invalidate):A 通知 B"把你那份 X 作废"。B 的行从 S 变 I,下次 B 读 X 触发 miss,从 A(或内存)重新取。MESI、MOESI、MESIF 全是这一路。
- 写更新(Write Update / Write Broadcast):A 直接把新值广播/推送给 B,B 的行保持有效、内容同步刷新。B 下次读 X 直接本地命中。经典代表是 Dragon 和 Firefly 协议。
一个"扔旧报纸",一个"送新报纸上门"。听起来只是分发方式不同,但带宽和延迟的账完全不同。
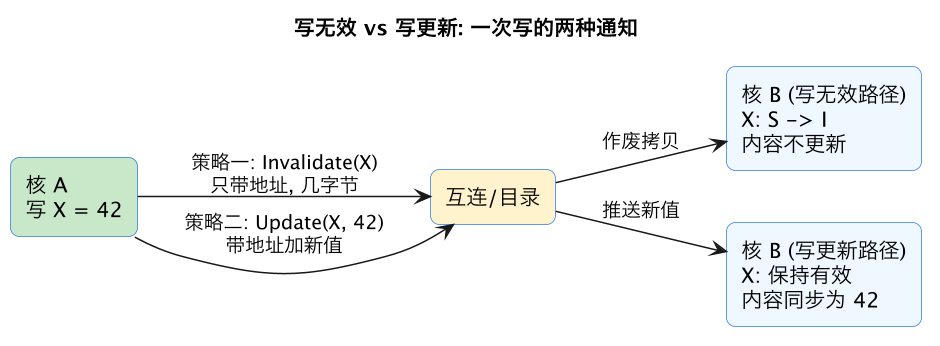
这张图的两个出边藏着全部差异:写无效的消息只带地址(一个失效请求几十比特),代价转嫁给了"未来读的人"——B 再读要 miss;写更新的消息带数据(每次至少 8 字节或整个缓存行 64 字节),把带宽花在当下,换来 B 未来读的直接命中。谁占便宜,取决于 B 到底还读不读、以及 A 还要写几次。
二、代价模型:带宽和延迟各花在哪
把两种策略拆开算账,先看消息成本的结构:
| 维度 | 写无效 | 写更新 |
|---|---|---|
| 写时消息大小 | 仅地址(~8B 级控制消息) | 地址 + 数据(8B~64B) |
| 连续写同一行 k 次 | 只第一次失效,后续本地静默写 | 每次都要广播新值,k 倍流量 |
| 其他核之后读该行 | 触发 miss,付完整取数延迟 | 本地命中,零额外延迟 |
| 写后无人再读 | 白付一次失效广播 | 白付 k 次更新流量 |
| 一行多字被不同核写(伪共享场景) | 整行在核间弹跳 | 每次写广播整行,流量更大 |
| 对互连的占用 | 低频小消息 | 高频大消息,带宽敏感 |
三条关键推论从表里直接长出来。
第一,写无效对"写写写"序列有碾压级带宽优势。 核 A 对一个私有变量连写 100 次(比如循环里的计数器),写无效只在第一次发失效,之后 99 次完全本地完成,一致性流量约等于零;写更新每次写都要把新值推给 B,哪怕 B 根本不关心这个变量——100 次写就是 100 条带数据的消息。这是写无效赢下的主战场:程序里绝大多数写是写私有数据或独占数据,为这些写付更新流量纯属浪费。
第二,写更新赢在"写一次、多人立刻读"的生产者-消费者场景。 A 写完标志位,B、C、D 马上轮询它:写无效下 B、C、D 各 miss 一次、各付一次取数延迟(跨核 HITM 几十到上百拍);写更新下新值已经躺在它们缓存里,读取零等待。如果这个模式是程序热点,写更新能把同步延迟砍掉一大截。
第三,失效风暴是写无效的软肋。 想象一行数据被 8 个核轮流读写:写无效下每次写都废掉其他 7 份拷贝,下一轮读又是 7 个 miss 补 7 份,缓存行像乒乓球一样在核间弹跳——这正是 cache-lock-contention-bouncing 描述的锁弹跳现象的协议层根源。写更新在这种模式下流量大但延迟平,乒乓被"热数据多副本共存"吸收掉了。
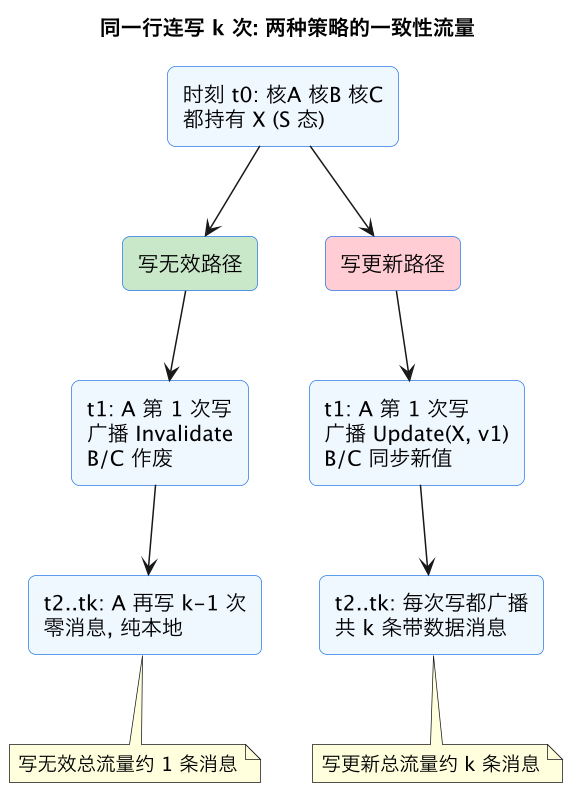
这张图把带宽差异画到了极限:k 越大,写无效优势越悬殊。而 k=1 且之后立刻有多人读的场景,胜负就反转——这正是混合协议要钻的空子。
三、混合策略:Dragon 和 Firefly 的"看人下菜碟"
既然两种策略各有甜区,能不能运行时判断、动态切换?1980 年代的两个经典协议给出了肯定答案。
Dragon 协议(Xerox Dragon 工作站,四状态:E/Sc/Sm/M)的核心规则是:写之前先看这行是不是共享的。
- 本地行是独占(E/M)状态:直接写,零消息——和写无效一样省。
- 本地行是共享(Sc/Sm)状态:写时把新值广播更新给所有共享者,更新后大家保持共享态,谁也别作废。
判断"是不是共享"只需要总线上一根共享线(shared line):A 发出更新时,其他核若持有该行就拉低/拉高这根线,A 据此决定下次还按共享处理还是转入独占。于是一个核独占的数据享受写无效的零流量,真正共享的数据享受写更新的低读延迟——两头甜区都占。
Firefly 协议(DEC Firefly 多处理器工作站)思路相近但更激进:写共享行时直接广播更新并且同时写回内存(write-through 到主存),靠总线上的共享线检测决定是否继续更新。它的特点是只要还有共享者就保持 write-through 更新,退化成独占后才切 write-back。
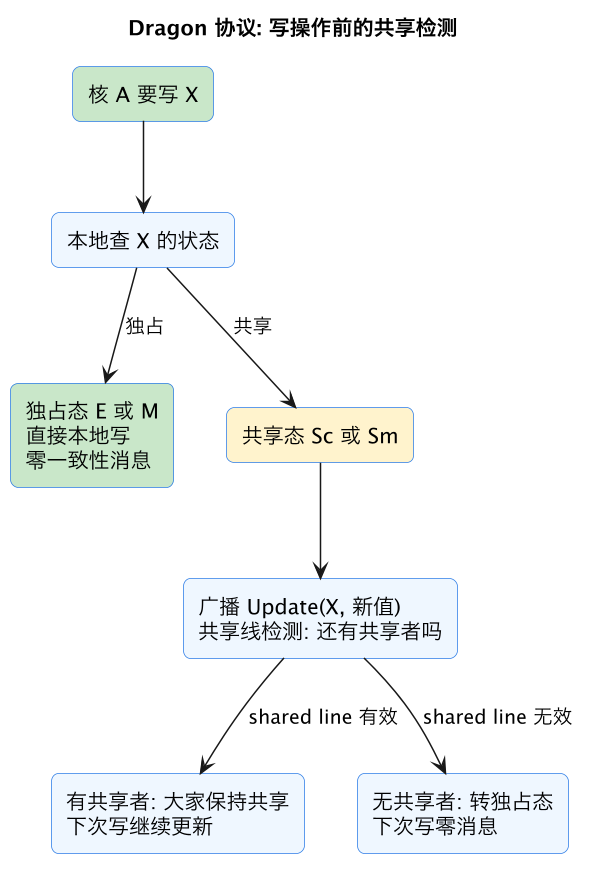
这张流程图的分叉点只有一个——"这行是不是共享的",但它让 Dragon 在理论上同时逼近两种纯策略的最优点。注意判定节点的语义写在出边标签上,这也符合本站的配图约定。Dragon 的软肋同样清晰:共享线检测依赖总线式互连,所有核必须能在一拍内对"有没有人持有"投票——这在监听总线上是一根线的事,在目录协议的点对点互连上却要变成"目录查表 + 收集确认"的多跳过程,更新路径的低延迟优势被吃掉大半。混合协议的黄金时代因此与监听总线时代重合,这不是巧合。
四、商用的真实取舍:为什么今天全是写无效
教科书把两种策略讲成平起平坐,打开现代处理器却发现是一边倒:x86 从 Pentium 到最新 Xeon/EPYC 是 MESI/MOESI/MESIF 家族的写无效,ARM 的 AMBA CHI 同样是写无效语义,RISC-V 世界也无一例外。写更新策略在现代商用 CPU 里基本绝迹,原因有三层,一层比一层硬。
第一层:带宽成为最稀缺资源。 核数从 4 涨到 64、128,互连流量随"核数 × 写频率"线性膨胀,而写更新把每次共享写都变成带数据的广播。写无效只发地址级小消息,且独占写完全免消息——在带宽预算紧张的多核时代,这是生死线而非优化项。目录与监听一致性 里算的目录存储账是为了省消息条数,写无效 vs 写更新省的是每条消息的字节数,方向一致:一切为带宽让路。
第二层:缓存行粒度放大了写更新的浪费。 真实协议按 64 字节行为单位工作,写一个字节也要按行行动。写更新若按行推送,每次写广播 64B;若按字推送,协议要为行内每个字维护有效位,复杂度爆炸。写无效则天然适配行粒度——失效一行和失效一个字的消息一样大。配合 store-buffer-write-combining 的写合并机制,连续写还能在 store buffer 里攒成整行再出手,写无效路径的效率进一步拉开。
第三层:失效风暴可以用软件手段治,带宽浪费治不好。 写无效的软肋(锁弹跳、伪共享)有成熟的应用层解法:锁分片、per-cpu 变量、缓存行对齐填充(见 mesi-false-sharing 与 memory-alignment)、读写锁降级。这些都是"改代码能救"的病;写更新的带宽浪费是协议层先天的,硬件烧掉的流量软件救不回来。工程取舍的天平因此彻底倒向写无效。
但写更新并没有死透,它在两个角落活着。一是 GPU 与加速器间一致性:NVIDIA Grace Hopper 的 NVLink-C2C、CXL 3.x 的设备一致性语义里能看到"推送数据"的影子,因为加速器间共享的数据集往往真的会被多方立刻消费;二是片内专用结构:某些网络处理器和 DSP 的紧耦合共享存储本质就是硬件自动写更新。规律很清楚:只有当"写后必被多方立刻读"成为负载常态时,写更新才配得上它的带宽账单。
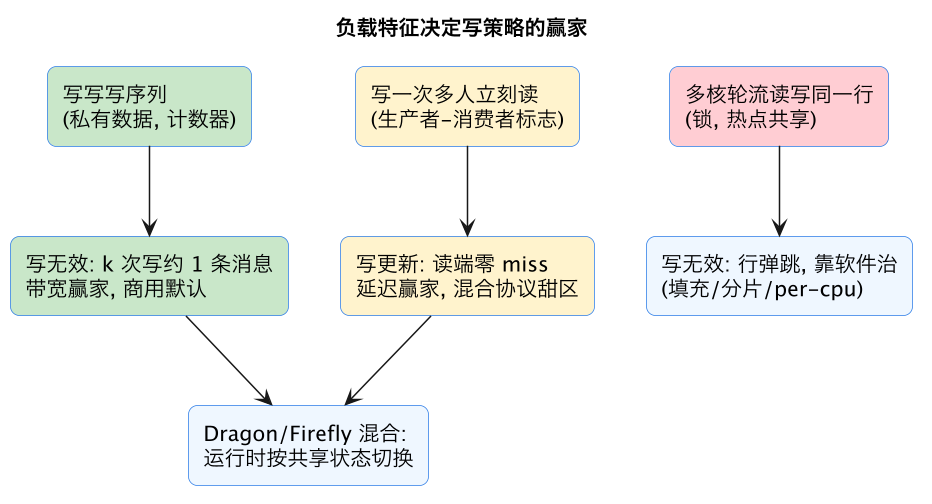
这张图是全篇的决策浓缩:三种典型负载各有最优策略,混合协议想通吃,而商用处理器的选择是——押注写无效,把它的软肋外包给软件工程实践去治。
五、对性能分析者的观测意义
先给一个实用的判断框架:拿到一个共享数据热点,先问三个问题——这行的写频率多高、写完有多少核立刻读、读者和写者是否在同一一致性域。写频率高而读者少,写无效的作废成本被摊薄,热点其实是假的,拆开数据布局就能消掉;写一次多人立刻读,写无效的作废-重取循环是真实成本,这时候要么改用读多写少的设计(版本号 + 不可变数据、RCU 风格的发布-订阅),要么接受 HITM 延迟并用批量发布降低频率。这个判断过程本质上是把协议层的策略之争,翻译成应用层的设计选型——你改不了 CPU 跑什么协议,但你能决定自己的数据落在哪种负载模式里。
落到 perf 和计数器层面,写无效协议的行为有两个直接可观测的指纹。其一,HITM(Hit Modified)事件是写无效独有的成本:因为拷贝被作废了,读的人必须从持有修改数据的核那里取行,perf c2c 报告的 HITM 占比就是"写无效作废-重取"循环的频率计。其二,伪共享和锁弹跳在写更新协议下会表现得更温和(流量大但延迟平),所以当你看到延迟曲线随核数陡增而非带宽先行饱和时,基本可以确认跑在写无效协议上——现代 x86/ARM 永远是这个答案,观测方法见 measuring-cache-perf-counters。理解协议策略,才能把计数器数字翻译回程序行为。
这一篇在知识体系里的位置
本篇是缓存一致性专题里"写策略"这一层,与同层文章互相咬合:
- 目录与监听一致性:回答"一致性消息怎么送达",本篇回答"送达什么内容",两篇合起来是协议设计的两个正交维度。
- mesi-protocol / msi / mesi-variants:写无效阵营的状态机实现细节,Dragon 这类写更新状态机正是它们的对照组。
- mesi-false-sharing 与 cache-lock-contention-bouncing:写无效软肋在应用层的两种典型病症及药方。
- store-buffer-write-combining:写无效路径上写带宽的硬件级放大器。
- cache-numa-locality:写无效作废后跨节点重取数据的延迟构成。
- 上游导读:cpu-microarch-overview。
总结
写无效与写更新是缓存一致性的两种写策略:写无效作废其他核的旧拷贝,消息只带地址、独占写零流量,省带宽但把取数延迟转嫁给后来的读者;写更新把新值直接推给所有共享者,读端零 miss 但每次共享写都烧互连带宽——Dragon 和 Firefly 用"共享则更新、独占则静默"的运行时切换想通吃两头,却受困于共享检测对总线互连的依赖;现代商用处理器一边倒选择写无效,因为带宽是多核时代最稀缺的资源,而写无效的软肋(锁弹跳、伪共享)有成熟的软件药方——性能分析者的功课,就是通过 HITM 类计数器认出"作废-重取"循环,并用行填充和数据分片把真共享压到最短。