DVFS 切换延迟:一次 P-state 跃迁为什么不是"免费的",微秒级开销藏在哪
承 microarch-clock-power-gating——那一篇讲了时钟门控和电源门控怎么在"不用的时候省电",但 CPU 省电还有更激进的一招:连频率本身都动态升降。这就是 DVFS(Dynamic Voltage and Frequency Scaling,动态电压频率调整)。听起来很美:闲时降频省电,忙时升频追性能。可频率不是说变就变的——一次 P-state 切换从决策到生效要穿越操作系统 governor、硬件寄存器、电压调节、PLL 重锁定一整条链路,每一环都有微秒级的代价。DVFS 切换延迟就是这条链路的总耗时,它直接决定了调频策略能不能跟上负载的瞬时起落。调度器上下文见 scheduling。
本文要回答的问题
- 一次 DVFS 频率切换从决策到生效,完整路径上有哪几段延迟,各占多少微秒?
- PLL 重锁定是什么,为什么它是频率切换里最"硬"的一段物理延迟?
- 电压和频率为什么要分两步走,升频先升压、降频先降频的顺序约束从哪来?
- cpufreq governor(performance / powersave / schedutil)与 intel_pstate 怎么和调度器交互,决策延迟有多长?
- 真实负载下怎么观测 DVFS 切换行为,什么时候该把 governor 锁成 performance?
一、P-state 与一次切换的完整路径
ACPI 规范把 CPU 的运行档位抽象成 P-state(Performance-state,性能状态):P0 是最高频,数字越大频率越低。每个 P-state 背后是一对"频率 + 电压"的出厂标定组合——频率和电压必须成对调整,因为更高的频率需要更高的电压才能保证晶体管开关稳定,而功耗大致随电压平方增长,这正是 DVFS 省电的物理来源。
现代 x86 上,P-state 的切换通过写 MSR(Model-Specific Register,型号专用寄存器)触发:软件往 IA32_PERF_CTL 写入目标档位的编号,硬件接管后续动作。但"软件写寄存器"只是漫长链路的第一棒。一次完整的切换延迟由四段组成:

这张图的读法是:前两段是软件世界,后两段是物理世界,物理世界的两段才是硬延迟。governor 决策延迟取决于采样周期和策略,可以短到 10 微秒(intel_pstate 主动模式),也可以长到几十毫秒(老 ondemand 的轮询周期);MSR 写入本身纳秒到微秒级,忽略不计。真正的重头在第 3、4 段:电压调节要等主板上 VRM(Voltage Regulator Module,电压调节模块)把 Vcore 一点点抬到位,PLL 重锁定要等锁相环在新频率上重新稳定。这两段期间核心不能全速跑——要么完全停摆,要么锁在低频等待。一次 P-state 跃迁的端到端延迟,典型值在 20 微秒到 100 微秒之间,比一次 context-switch-cost 还高一个数量级。
二、PLL 重锁定:频率切换里最硬的一段物理延迟
**PLL(Phase-Locked Loop,锁相环)**是把低速参考时钟倍频成核心高频时钟的模拟电路。它本质上是一个反馈控制系统:把输出时钟分频后与参考时钟比相,根据相位差微调振荡器,直到两者严格同相——这个"追上并锁住"的过程就叫锁定。
问题在于,PLL 不是数字开关,它的锁定需要时间。目标频率一变,反馈回路要从头收敛:相位差先拉大,再逐步缩小,直到输出时钟的抖动收敛到规格之内。这段重锁定时间典型 10~30 微秒,期间输出时钟是不可用的——频率在飘,占空比不保证,数字逻辑拿去用就是亚稳态灾难。
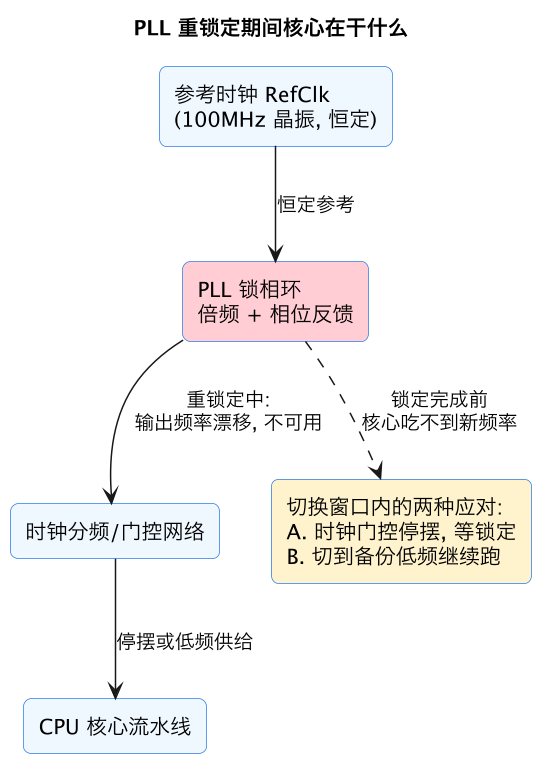
图里标出了两种工程应对。做法 A 最直接:切换瞬间把核心时钟门控掉,全核停摆等 PLL 锁定,锁定完成再唤醒。停摆窗口就是一次"微型休眠",代价是切换期间 IPC 为零。做法 B 更聪明:核心先切到一路备份的固定低频时钟(比如直接用参考时钟或其低倍频),继续以龟速执行,PLL 在后台锁定新频率,锁定完成后无缝切回。做法 B 把"全停"换成了"慢速前进",体感延迟还在,但至少指令流没断。无论哪种,PLL 重锁定期间核心都吃不到目标频率,这是物理定律给的底价,软件再优化也压不下去。
现代 SoC 为每个核心(或每个频率域)配独立 PLL,让单核切换不拖累邻居;有些设计还预锁两个 PLL 分别停在相邻档位,切换时只做 mux 选择,把 30 微秒压到个位数微秒——但代价是多一路 PLL 的静态功耗和面积。这又是典型的"硬件花钱换延迟"。
三、电压阶梯:为什么升频先升压、降频先降频
DVFS 的"DV"排在"FS"前面不是巧合——电压调整必须走在频率调整的正确一侧。约束来自晶体管开关速度:频率越高,留给每级逻辑的传播时间越短,电压不够时信号来不及翻转,电路就出错。所以:
- 升频:先把电压抬到能支撑新频率的水平,等电压到位(VRM 调节完成),再切 PLL 升频。顺序反了就是低压跑高频,立刻出错。
- 降频:先把频率降下来,再慢慢降压。顺序反了虽然功能上没错(高压跑低频只是浪费电),但错过了省电窗口。
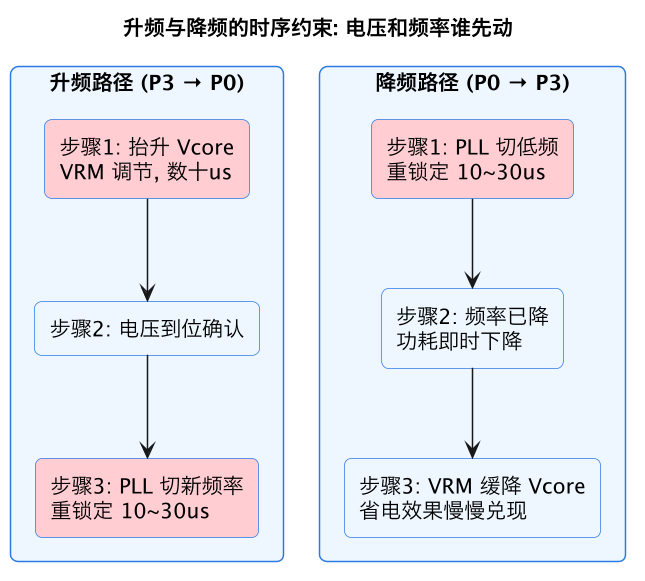
这张图揭示了一个不对称性:升频的总延迟比降频长。升频要串行经过"电压爬升 + PLL 锁定"两段,电压爬升往往比 PLL 锁定还慢——板级 VRM 的摆率(slew rate)有限,每微秒只能抬几毫伏到几十毫伏,跨几个档位就是几十微秒。降频则先拿到频率收益,电压慢慢降不阻塞执行。这个不对称直接影响了 governor 的设计哲学:升频要快(宁可预测性超调),降频可以从容。
还有一层硬件演进值得知道。早期的电压调节走板级 VRM,通过 I2C/SVID 总线下发电压命令,一个来回几十微秒;Intel 从 Haswell 起把 FIVR(Fully Integrated Voltage Regulator,全集成电压调节器)做进 CPU 封装内部,调节速度提到微秒级以内,电压这段延迟才不再是短板——这也是现代 CPU 敢做"每核独立 DVFS"的前提。
四、与调度器和 governor 的交互:决策延迟的另一半
硬件链路之外,DVFS 切换延迟的另一半是决策延迟——谁来决定"现在该升频了",多久决定一次。这是 cpufreq 子系统和调度器的交界处。
Linux 的 governor 谱系可以浓缩成一张对比表:
| Governor | 决策依据 | 决策周期 | 决策延迟画像 | 适用场景 |
|---|---|---|---|---|
| performance | 恒定 P0 | 不决策 | 零,但功耗拉满 | 延迟敏感、压测 |
| powersave | 恒定最低档 | 不决策 | 零,性能也拉胯 | 极端省电 |
| ondemand(旧) | 定时采样 CPU 利用率 | 10~100ms 轮询 | 毫秒级,跟不上突发 | 已被淘汰 |
| schedutil | 调度器利用率信号(PELT) | 调度事件驱动,约 1ms 粒度 | 亚毫秒~毫秒 | 通用默认 |
| intel_pstate active | CPU 内部硬件控制器 + 软件提示 | 微秒级持续跟踪 | 10~20us | Intel 平台主流 |
关键转折是 intel_pstate 的 HWP(Hardware P-state,硬件自主调频):决策权从内核 governor 下放给 CPU 内部的微控制器。软件只写三个 MSR 提示——最低档、最高档、能耗性能偏好 EPP(Energy Performance Preference)——硬件以微秒级粒度持续跟踪每个核的利用率,自己决定瞬时档位。这一下把决策延迟从毫秒压到十几微秒,突发负载到来时第一个时钟周期就开始爬坡。
schedutil 则是纯软件路线的最佳实践:它不走独立定时器,而是挂在调度器的利用率更新路径上,每次 PELT(Per-Entity Load Tracking)信号更新时顺带算一次目标频率。负载一涨,下一个调度 tick 就提频,理论延迟一个 tick(1~4ms)。
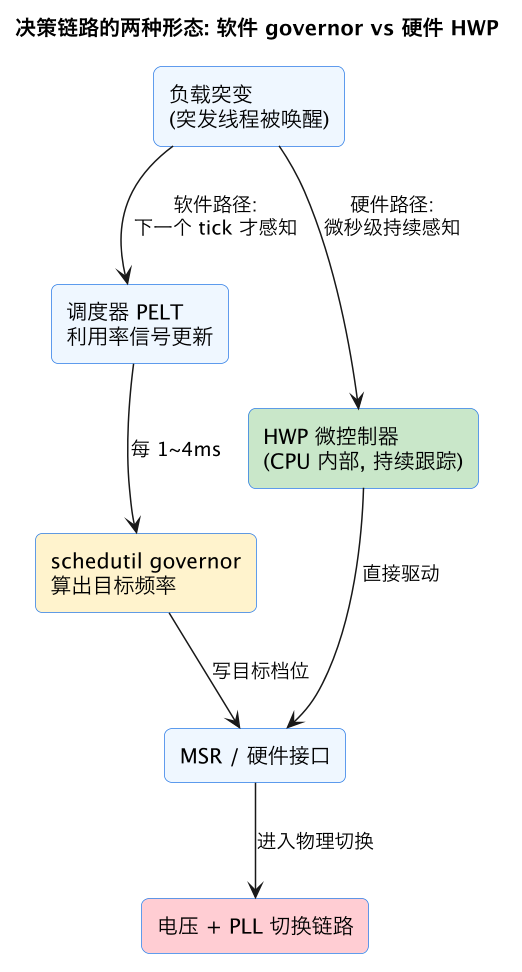
读这张图的重点是两条路径的"感知延迟"差:软件 governor 再勤快也要等调度事件,而 HWP 的感知是连续的。但注意,决策再快也消不掉第三节讲的物理链路——HWP 省掉的只是 governor 那一段,PLL 重锁定的 10~30 微秒一分不少。这就是为什么即使开了 HWP,频率从谷底爬到峰值的完整 ramp 时间仍在几十微秒量级。
一个容易被忽略的交互细节:频率切换期间调度器的容量感知。Linux 的 capacity awareness 会把当前频率折算进 CPU 算力(freq invariance),一个跑在半频的核在负载均衡眼里只有半个核。如果 DVFS ramp 慢,调度器刚把重任务迁过来,核还没爬到高频,任务就按"满血算力"被超额分配——决策延迟和切换延迟在这里叠加放大。
还有一个常被忽略的系统级放大效应:频率域的粒度。不是所有核都能独立变频——很多平台按"频率域"分组,同组核共用一路 PLL 和电压轨,组内任何一个核请求升频,整组都得跟着升。这意味着同组里一个突发线程会把邻居核的功耗一起抬高;反过来,组内一个核想降频省电,只要还有一个核忙,降频请求就会被压住。调度器如果不知道频率域边界,把两个突发型线程摆进同一个域,就会反复触发"升-降-升"的乒乓切换,每次切换都付一遍物理链路的钱。查看域边界的方法:
# 同一频率域的核集合
cat /sys/devices/system/cpu/cpu0/cpufreq/related_cpus
把相关核错开摆、或者干脆用 cpuset 把突发负载和稳态负载隔离到不同域,是这一类乒乓问题的标准解法。
五、观测与调优:什么时候该锁 performance
DVFS 切换行为在系统里留下的痕迹是可观测的:
# 当前各核频率与 governor
cat /sys/devices/system/cpu/cpu0/cpufreq/scaling_cur_freq
cat /sys/devices/system/cpu/cpu0/cpufreq/scaling_governor

# 实时盯频率变化(intel_pstate 下单位 KHz)
watch -n0.2 'grep MHz /proc/cpuinfo'

# perf 记录频率切换事件
perf record -e power:cpu_frequency -a sleep 10
perf script | head

# 锁定 governor
echo performance | tee /sys/devices/system/cpu/cpu*/cpufreq/scaling_governor
更系统的延迟测量方法见 latency-measurement;power:cpu_frequency tracepoint 能把每一次切换的时间戳和目标档位拉出来,配合负载曲线就能看出 governor 的反应速度。
什么时候该一刀切锁 performance?三条经验判据:
- 微秒级延迟敏感负载(高频交易、内存数据库热路径):一次几十微秒的频率爬坡就足以打爆 P99 延迟预算,锁频比任何调优都直接。这类场景还要同时关掉 C-state 深度休眠(见 microarch-clock-power-gating 里唤醒延迟的讨论),两者是同一种"省电 vs 延迟"的权衡。
- 突发密集型负载(编译、CI、交互式服务):负载起落的周期和 governor 采样周期同量级,调度器刚提频负载就走了,永远在追。HWP + 激进 EPP 通常够用,不必锁死。
- 吞吐量导向的长稳负载(批处理、渲染):负载平稳,ramp 延迟被长时间摊薄,schedutil 默认策略即可,锁 performance 纯粹浪费电。
内核参数层的更多开关(如 intel_pstate=disable、cpufreq.default_governor)在 kernel-tuning 有完整清单。对延迟敏感系统,另一个常被忽视的做法是用 EPP 而不是锁频来表达偏好:energy_performance_preference 写 performance 保留硬件微秒级响应,同时不放弃闲时省电,比 governor 一刀切更精细。
这一篇在知识体系里的位置
本篇是微架构"功耗与频率管理"方向的专题,把 microarch-clock-power-gating 里"门控省电"之外的另一半——"调频省电"——展开成完整的延迟分析。上下游关联:
- 同域背景:cpu-microarch-overview 的微架构全景;smt-simultaneous-multithreading 中频率域与 SMT 资源共享的相互影响。
- 调度器一侧:scheduling 的调度框架,scheduling-timing 的 tick 与调度时机,real-time-scheduling 对确定性延迟的要求(实时系统几乎必锁频)。
- 观测方法:latency-measurement 的延迟测量工具箱,kernel-tuning 的内核参数清单。
- 相邻延迟分析:context-switch-cost 是另一个"微秒级系统开销"的对照样本——一次 DVFS 切换的代价比一次上下文切换还高。
总结
DVFS 切换延迟由四段串联而成:governor 决策(软件,微秒到毫秒)、MSR 写入(可忽略)、电压调节(VRM 爬升,数到数十微秒)、PLL 重锁定(10~30 微秒物理底价)——后两段硬件延迟决定了频率切换不可能"免费",升频还得先升压再等锁定,比降频更慢;HWP 把决策延迟压进微秒级,但物理链路谁也省不掉,所以微秒级延迟敏感负载的答案永远是锁 performance,而突发型负载交给硬件自主调频加激进 EPP 才是正解。