victim cache 与 victim buffer 组织:冲突未命中的最后避难所
更新时间:2026-10-06。本篇属于微架构缓存组织的零件级深文。站内相关阅读:缓存替换策略 LRU 家族 讲主缓存踢人的算法,缓存 bank 冲突 讲另一种「同一周期抢同一资源」的冲突,伪 LRU 树 讲真实硬件怎么近似 LRU,victim cache 与写缓冲 侧重写路径的缓冲。本篇聚焦一个更窄的问题:被逐出的缓存行去了哪、怎么找回来、这笔买卖什么时候划算。
本文要回答的问题
- 什么是冲突未命中(conflict miss),为什么组相联再高也消灭不完?
- victim cache 和 victim buffer 的组织方式有何不同,查找发生在哪个时刻?
- 「交换」与「直接丢弃」两种回收策略对命中率的差异有多大?
- victim 结构对能效和面积意味着什么,为什么现代大缓存时代它少见?
- 怎么用步长扫描微基准在自己的机器上复现冲突抖动?
一、冲突未命中:组相联的结构性伤疤
缓存三种未命中里,冷未命中(首次访问)和容量未命中(工作集超过缓存总量)都容易理解,第三种——冲突未命中——是组相联组织的结构性伤疤:缓存总容量明明够用,但因为太多热行映射到同一组,该组的 way 被挤爆,热行互相踢来踢去。极端例子:一个 8 路组相联的 32KB L1,如果程序恰好循环访问 9 个落在同一组的行,就会陷入「每轮访问都 miss、miss 进来的行又把别的热行踢走」的抖动(thrashing),此时等效缓存容量从 32KB 塌缩到不足一行。
给一个具体的量级感。32KB、8 路组相联、64 字节行的 L1D,共 64 组;若程序以 4KB 为步长顺序扫一个数组,每次访问的地址在索引位上完全相同(4KB 正好是「组数乘行长」的整数倍),所有访问挤进同一组。8 个 way 装满后,第 9 次访问踢掉最早一行,第 10 次再踢——循环扫 64 个元素时命中率是零,等效容量塌缩成 8 行共 512 字节,剩下 31.5KB 全部闲置。这不是教科书构造的病态例子:以页为粒度的表遍历、二维数组按行主序访问但行长恰为 2 的幂、哈希表桶间距为缓存路数倍数,都能在日常代码里复现同款抖动。
这类问题在现实中并不罕见。2 的幂次步长访问(遍历按 4KB 对齐的页表、处理按 64 字节对齐的数组且步长为缓存大小的约数)是经典触发器;缓存 VIPT 与别名问题 讲的索引位选择方式,会让某些虚拟地址模式天然扎堆到少数组里。增大相联度可以缓解,但 way 数翻倍意味着面积、功耗、命中延迟三重上涨,收益却快速递减——从 8 路到 16 路,典型负载的冲突 miss 下降往往不到一半。
victim cache 的思路是换一个角度补这个伤疤:不增大主缓存的相联度,而是给被踢出的受害者行一个小型全相连收容所。全相连意味着任何地址都能住进去,天然免疫「映射扎堆」问题——被同一组挤出来的 9 个热行,在 victim cache 里和平共处。
上图是 victim cache 的基本拓扑:它与主缓存并联而非串联,每一轮未命中处理时同时被查。容量通常极小(经典论文里 4-16 项,只有主缓存的几十分之一),但因为吸收的是「刚被踢走、很可能马上又被要回来」的行,投入产出比惊人——Jouppi 在 1990 年的原始研究里,一个 4 项的 victim cache 就能吸收部分负载 20-40% 的冲突 miss。
二、查找时机与命中路径:藏在 miss 处理里的一次并行查询
victim cache 的工程要点全在时序上。一次 L1 访问的流程变成:
- 查主缓存(按组索引、比标签),命中则正常返回;
- 不命中的同一拍,用完整地址查 victim cache(全相连意味着没有索引概念,所有项的标签并行比较);
- victim cache 命中,进入「交换」路径;不命中,才是真的要去 L2。
第三步的「交换」是 victim cache 区别于普通缓存层级的关键设计:victim cache 命中的行不能简单地「读出来用」,而要和主缓存里刚被选中要淘汰的那一行互换位置——受害者住进主缓存的组里,组里原本的牺牲者搬进 victim cache。为什么要交换而不是只读?因为只有让热行回到主缓存,它后续才能享受主缓存的低延迟命中;victim cache 只是收容所,不是久居之地。这个交换动作也使 victim cache 里的内容始终保持「最近被淘汰」的语义,天然实现了 LRU 排序。
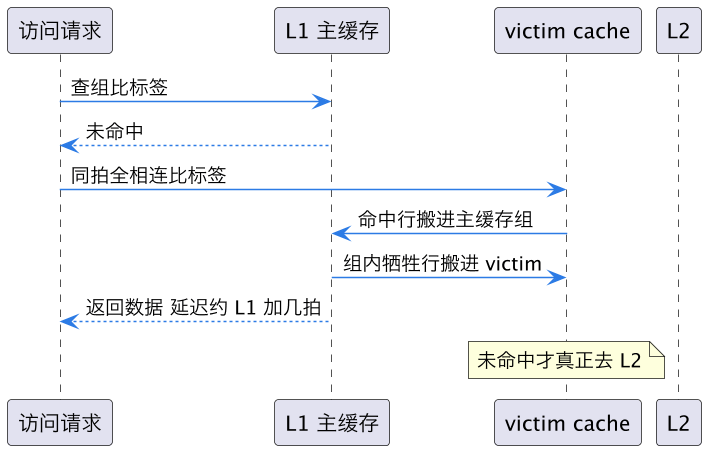
上图里要注意两点。其一,victim 命中比主缓存命中慢几拍——交换本身要搬两个行,典型实现多花 2-5 个周期,但仍远快于 L2 的十几拍。其二,victim cache 未命中时才触发 L2 访问,这意味着 victim 结构还顺手做了一个过滤:那些「很快会被重新访问」的行根本不去打扰 L2,省下了 L2 的查找功耗和端口占用。
三、victim buffer:同族但更简陋的变体
名字相近的 victim buffer(受害者缓冲)常和 victim cache 混为一谈,两者目标相同(收容被逐行),但组织和用法有差异:
| 维度 | victim cache | victim buffer |
|---|---|---|
| 典型容量 | 4-16 项 | 4-8 项 |
| 映射 | 全相连、带标签 | 全相连或小队列 |
| 命中动作 | 与主缓存交换 | 只提供数据,行不回主缓存 |
| 行状态 | 完整缓存行状态机 | 常简化为只读数据暂存 |
| 常见位置 | L1 与 L2 之间 | 写回路径、目录协议节点 |
| 主要收益 | 吸收冲突 miss | 平滑逐出流量、吸收写回突发 |
victim buffer 的哲学更「用完即弃」:命中时把数据递给请求方,行本身不搬回主缓存,直接失效。省掉了交换的复杂度和功耗,代价是热行永远回不到主缓存的快车道,重复冲突的负载吸收率会打折扣。写路径上的变体可参见 victim cache 与写缓冲,那里的缓冲更多是为了把「脏行写回下级」这件事异步化。
两种结构的选择本质是「命中率」与「实现成本」的权衡:交换式 victim cache 吸收率高但控制复杂,一次性 victim buffer 简单但治标。学术界还提过选择性方案——只对「历史上经常反复冲突」的组启用交换,用少量预测位换取大部分收益。还有一个工程细节常被忽略:全相连比较器的功耗随项数线性增长,项数从 8 加到 16,吸收率的边际提升通常不到 5%,比较器阵列的功耗却直接翻倍——这就是为什么所有实际设计都把 victim 结构压在 16 项以内,再大的投入产出比就彻底翻转了。
四、吸收率与能效:这笔买卖什么时候划算
victim cache 的价值要用两个指标衡量:冲突 miss 吸收率(victim 命中数除以原冲突 miss 数)和能效比(每吸收一个 miss 省下多少访问下级的能耗,对比 victim 结构自身的静态与动态功耗)。
吸收率的规律是「越小越有效,但有效区间很窄」。经典数据:对直接映射或低相联度缓存,4-8 项 victim cache 可吸收 20-50% 的冲突 miss;但主缓存相联度到了 8-16 路,剩余冲突 miss 大多是「真容量问题」假扮的,victim 结构的吸收率掉到个位数。能效账类似:victim cache 全相连比较器每个访问都要点火,容量虽小、单次功耗不低;只有 miss 率足够高的负载,省下的 L2 访问能耗才盖得住这笔开销。
上图是这笔买卖的决策图。这解释了 victim cache 的历史命运:它在直接映射和 2-4 路组相联当道的年代(1990 年代)红极一时;随着工艺进步让 8-16 路组相联成为 L1/L2 标配,主流商用核逐渐放弃了独立 victim cache——同样的晶体管预算,直接加大相联度或容量收益更稳。今天仍能看到它身影的地方,一是对面积极度敏感的嵌入式核,二是换了马甲的类似机制:某些 L2 的「回写暂存」、目录协议里的 transient 项,骨子里都是 victim 思想。
对软件工程师,victim cache 的启示不在配置(你通常改不了它),而在诊断:当 perf 显示 L1 miss 率异常高、但工作集远小于缓存容量时,先怀疑冲突 miss——检查访问步长是否为 2 的幂、数据结构是否按缓存大小对齐扎堆。对策是给数组加 padding 错开对齐、用 缓存着色页分配 之类的技术打散映射,而不是盲目增大容量。
五、与层级策略的交互:inclusiveness 的边角问题
再看替换策略的协同。主缓存用 伪 LRU 树 选牺牲者时,victim cache 的存在会轻微扭曲「最近使用」的统计:一个行被踢进 victim 后立刻又命中换回,它在主缓存里的「资历」从零开始计算,可能在下一轮替换里又成了牺牲品,形成「主缓存与 victim 之间来回搬运」的乒乓效应。缓解办法是在交换时为换回的行打上较高的优先级标记(相当于「赦免一轮」),工程实现里就是给替换状态机多留一个保护位——细节虽小,高冲突负载下能把 victim 的有效吸收率再抬高几个百分点。
victim 结构还会和多级缓存的包含策略(inclusive/exclusive,见 缓存包含性 L2 与 L3)产生微妙的化学反应。如果 L2 是 inclusive 的,L1 逐出的行在 L2 必有副本,victim cache 命中的行「搬回 L1」时不需要通知 L2;但如果 L2 是 exclusive(如 AMD 早期 Opteron 的 L1/L2 关系),victim cache 里的行可能是全系统唯一副本,此时 victim cache 本身就成了一级真正的存储层,替换和一致性协议都得为它多写几条规则。这也是 exclusive 层级里 victim 思想更容易复活的原因——exclusive L2 对 L1 的逐出行本来就要找地方安置,一个全相连 victim 结构恰好是天然的落点。
一致性协议视角下,victim cache 里的行和主缓存行一样要响应监听(snoop)或目录查询——它不在「缓存」的名义层级里,却在一致性的管辖范围里,协议状态机的项数、查询端口都要算上它。这部分的协议开销是 victim 结构在众核时代进一步失宠的隐性原因之一。
六、动手测一测:用微基准逼出冲突 miss
victim 结构对软件不可见,但它要解决的问题完全可测。一个二十行的微基准就能复现冲突抖动:分配一个大数组,以固定步长跨步访问,把步长从 64 字节一路扫到 16KB,记录每步的访问耗时。在 8 路组相联的 L1 上,你会看到步长为 4KB(以及其倍数)处出现一个尖锐的延迟尖峰——所有访问挤进同一组、路数被挤爆;相邻的非 2 幂步长则风平浪静。这个「步长扫描」曲线是诊断映射冲突的标准手法,perf-counter 与 PMU 编程 里的 L1 miss 事件可以给尖峰定量。
把同一个微基准搬到不同代际的机器上对比,还能读出厂商的取舍:老一代低相联度机器尖峰又高又宽,新一代 12-16 路 L1 上尖峰明显变矮(要 17 个以上同组热行才开始抖),这正是「把面积给主缓存而不是 victim cache」路线在硅片上的证词。反过来,如果你在某款嵌入式核上测到「尖峰虽然存在但比理论预测浅」,很可能就是一颗带 victim 结构的核在默默收容受害者——微基准是少数能让这种隐藏机制显形的手段。
对真实应用的排查流程可以收敛成三步:perf stat 看 L1 miss 率与工作集大小是否匹配;不匹配则跑步长扫描确认冲突特征;确认后给数据结构加 padding 或重排字段错开映射。整个过程不需要知道机器有没有 victim cache——无论有没有,冲突 miss 的成因和解药是同一套。
这一篇在知识体系里的位置
本篇是缓存组织系列的一员:上游是 缓存替换策略 LRU 家族 与 伪 LRU 树(谁被踢),本篇讲被踢之后的去处;横向关联 缓存 bank 冲突(另一种冲突)、sectored cache 行组织(行的内部切分)、victim cache 与写缓冲(写路径变体);下游连到 缓存层次延迟带宽全景(各级延迟预算)。
总结
victim cache 是给被逐出缓存行准备的全相连小型收容所:主缓存 miss 的同一拍并行查询,命中则与组内牺牲行交换归队,能用几十分之一的面积吸收 20-50% 的冲突 miss;但在 8-16 路组相联已成标配的现代核里,剩余冲突 miss 多为容量问题,victim 结构逐渐让位给「直接把主缓存做大」,只在嵌入式和 exclusive 层级的变体里延续香火。