HTM 容量中止调优:诱因分类、观测口径与回退路径设计
承 TSX 与 HTM 锁省略 对硬件事务内存(Hardware Transactional Memory,HTM)基本原理的介绍,以及 原子锁的缓存行实现 对传统自旋锁开销的分析。HTM 让临界区以「投机执行」的方式并行跑,但投机是有预算的——事务读集/写集一旦撑爆 LLC 的跟踪容量,CPU 就会触发容量中止(capacity abort)。HTM 容量中止调优要解决的,就是「为什么我的事务一上大数据量就疯狂回退、性能比拿锁还差」这个问题。
本文要回答的问题
- HTM 中止分哪几类?容量中止和冲突中止怎么区分?
- 容量中止的物理根源是什么?为什么工作集稍大一点中止率就爆炸?
- 用 perf 的哪些事件把中止原因量化到具体类别?
- 工作集收缩、事务切分、回退路径三条调优路线各自怎么落地?
- 什么情况下应该放弃 HTM、直接回到细粒度锁?
一、HTM 中止的三分类:先分清敌人是谁
Intel TSX 的 RTM(Restricted Transactional Memory)接口下,xbegin 开启一个事务,xend 提交;其间任何让事务无法提交的事件都会触发中止,控制流跳到 xbegin 时指定的回退地址,EAX 寄存器里带回中止原因码。原因很多,但工程上只需记住三大类。
冲突中止(conflict abort):另一个逻辑核读写了你读集/写集中的缓存行,且至少一方是写。这是 HTM「正确性」的代价,和数据竞争强度正相关——线程越多、热点行越集中,冲突越多。
容量中止(capacity abort):事务的读集或写集超出了硬件能跟踪的范围。Intel 实现里写集主要用 L1D(48KB 级,12 路组相联)跟踪、读集主要用 LLC(按 slice 分配,组相联度有限)跟踪;即使字节总量没超,地址在组相联上的分布不均(同一组里挤进超过路数的行)也会提前撑爆。EAX 的第 2 位(bit 2)置位即容量中止。
指令/其他中止(explicit/其他):xabort 主动中止、事务内执行了不允许的指令(cpuid、syscall、部分 XSAVE 类操作)、中断导致上下文切换等。这类通常稳定复现,容易修。
| 维度 | 冲突中止 | 容量中止 | 指令/其他中止 |
|---|---|---|---|
| 触发条件 | 他核碰同一行 | 读/写集超硬件容量 | xabort/非法指令/中断 |
| EAX 标志 | bit 6(重试可能成功) | bit 2 | bit 0 等 |
| 与负载规模关系 | 随线程数/热点升 | 随临界区数据量升 | 基本恒定 |
| 可重试性 | 重试可能成功 | 重试几乎必败 | 视原因 |
| 调优方向 | 降竞争/错峰 | 缩工作集/切事务 | 去掉非法操作 |
工程上最关键的一条经验:容量中止重试是无效的。冲突中止重试几次有概率成功,容量中止是结构性的——工作集不变,重试一万次也提交不了。这就是为什么回退路径设计必须区分中止原因。
二、容量中止的物理根源:预算比你想的小得多
很多人对容量的直觉是「L1 有 48KB,我临界区就改几百字节,怎么会爆」。问题在于硬件跟踪粒度是缓存行且按组相联组织。
写集:Skylake 之后的核用 L1D 跟踪写集。L1D 是 48KB、12 路组相联、64 字节行,共 64 组。也就是说写集不是「总字节数 ≤ 48KB」,而是「落在任意一组里的行数 ≤ 12」。一个 64 字节的结构体数组,顺序访问没事;但如果你的哈希表指针恰好都落在同一组,12 行就爆——字节数只有 768。
读集:读集跟踪溢出到 LLC,但 LLC 也是组相联的(11-16 路依代次),而且事务状态以「行挂在 LLC 某 slice 上且不被逐出」为前提。后台负载一产生 LLC 压力(别的线程在流式扫数据),你的读集行被逐出,同样触发容量中止。EAX bit 2 置位的中止里,相当一部分其实是「被挤出去的」,和你自己读了多少关系不大。
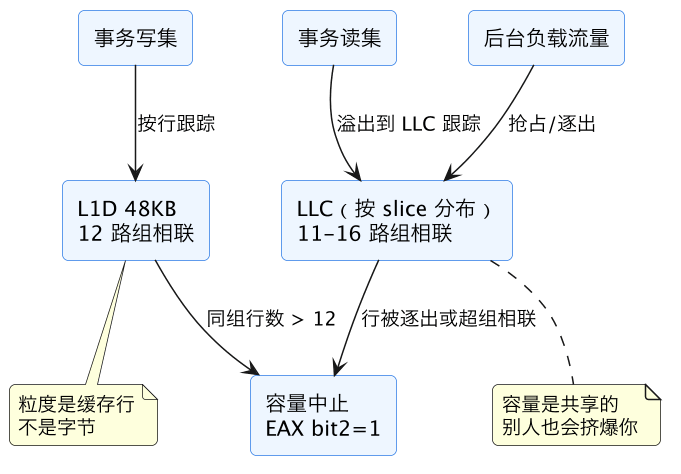
这张图的核心信息有两个:一是「字节数小 ≠ 安全」,组相联的分布不均让有效容量远小于标称容量;二是读集容量是共享资源——HTM 容量中止调优不能只看自己临界区,还要看同机其他负载对 LLC 的挤压。
三、观测:用 PMU 把中止率拆到类别
拍脑袋调 HTM 没有意义,先把「中止率多少、哪类中止占大头」量化出来。perf 暴露的 RTM 相关事件主要有这几组。
# 事务总量与提交量
perf stat -e rtm_retired.start,rtm_retired.commit -a -- ./your_app

# 中止分类:容量/冲突
perf stat -e 'rtm_retired.aborted,rtm_retired.aborted_events' -a -- ./your_app
rtm_retired.start 是事务启动次数,rtm_retired.commit 是成功提交次数,两者相除得到提交率;rtm_retired.aborted 是中止总数。中止率超过 20% 时 HTM 通常已经不划算——每次中止要丢弃投机状态、清空流水线,成本在 100-200 周期量级,比拿一次无争用锁贵一个数量级。
进一步拆类别,EAX 原因码可以采样:perf record -e rtm_retired.aborted_memtype/capability/... 各代次名字略有差异,通用做法是用 perf mem 或直接在回退路径里读 EAX 打日志。工程上更实用的是自己埋点:回退函数里读 EAX,按 bit 2(容量)、bit 6(冲突类)分桶计数,累计到原子计数器里,每 10 秒打一行。
| 观测项 | 事件/手段 | 健康基线 | 危险信号 |
|---|---|---|---|
| 提交率 | start vs commit | > 90% | < 80% |
| 容量中止占比 | EAX bit2 分桶 | < 5% | 持续增长 |
| 冲突中止占比 | EAX bit6 重试成功计数 | 随负载缓升 | 线程数一上就爆 |
| 回退锁拿取频率 | 埋点计数 | 偶发 | 成为主路径 |
| 临界区工作集 | perf mem / PEBS | 读集 < 数百行 | 哈希表全表扫 |
基线数据给一个参考:某生产 KV 服务用 HTM 包裹 16 槽位哈希桶的更新临界区,16 线程下提交率 96%、容量中止占比 2.1%,HTM 比细粒度锁快 1.8 倍;临界区改成「先扫全表统计再更新」后读集涨到数千行,容量中止占比跳到 61%,性能直接倒挂,比拿锁慢 40%。同样的代码结构,工作集从百行到千行,结论完全反转。这提醒我们:HTM 的收益对临界区改动极其敏感,任何「顺手在临界区里加个统计/日志/校验」的提交,都可能把精心调好的工作集预算一夜击穿,代码评审时临界区内的每一行新增访问都值得单独问一句「这会不会把事务撑爆」。
把中止分诊的完整路径收成一张漏斗卡——从「中止发生」到「该走哪条药」,每一层只做一件事:
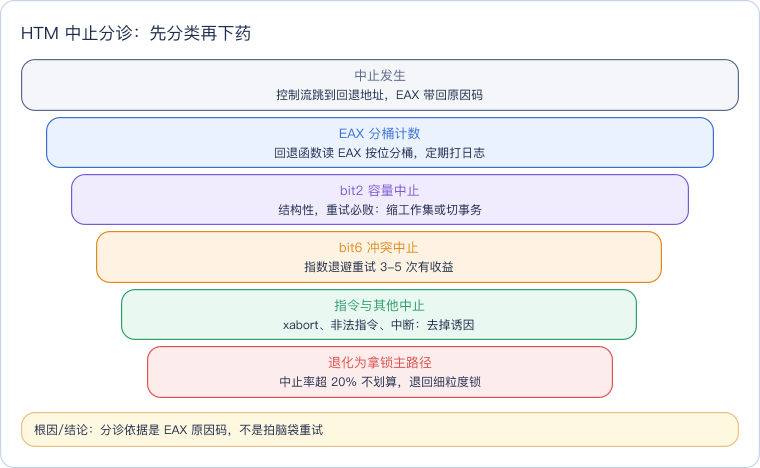
这张漏斗卡把前三节的内容串成了一条线:观测口径(EAX 分桶)是分诊的唯一入口,三类中止各有互不相同的药——容量中止走第四节的工作集收缩,冲突中止走第五节的退避重试,指令类中止靠代码审查剔除;漏斗最后一层是撤退判据,提醒调优有边界。
四、调优路径一:收缩工作集
容量中止的第一解法永远是让事务变得更小。三个常用手段,按实施成本从低到高排。
1. 把只读检查挪出事务。临界区里经常混着「查一下条件再决定改不改」的逻辑——条件检查产生读集,修改产生写集。把纯读的前置检查挪到事务外(结果在事务内用一次校验性的重读来兜底),读集可以缩掉一大半。
2. 把内存分配/释放挪出事务。malloc/free 碰的是分配器的全局元数据,动辄涉及几十个缓存行,还可能在事务里触发 mmap 系统调用直接中止。预分配好对象再进事务,是 HTM 代码的基本功。
3. 重排数据布局,缓解组相联冲突。如果中止集中在某几个结构体上,检查它们的地址分布:多个热对象对齐到 4KB 边界(恰好同组)是经典坑。给对象加 64-256 字节的随机偏移、或调整结构体大小错开对齐,能让同组行数从「超路数」降回安全区。这个手段成本最低,但对「字节总量真的超了」无效。
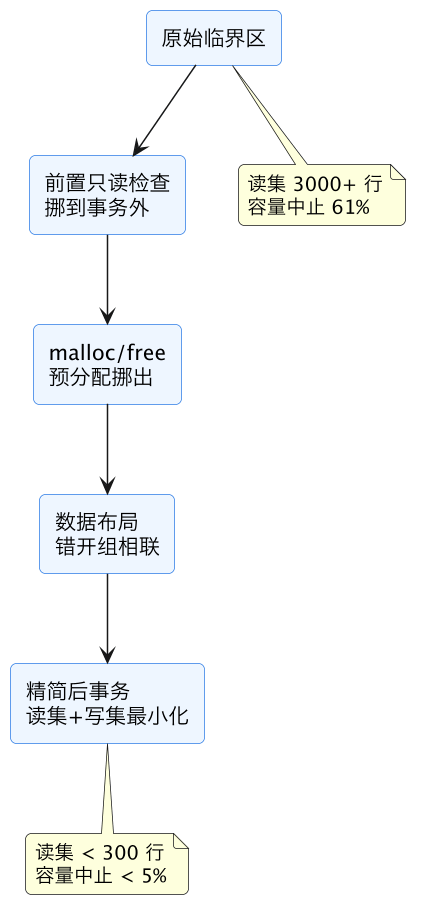
上图就是上面 KV 案例的修复路径:三步做完,提交率从 39% 回到 93%。注意顺序——先挪逻辑(收益最大),再挪分配器(消除系统调用类中止),最后才是布局微调(解决长尾)。反过来做会陷入「调了布局还是爆」的迷茫。
五、调优路径二:事务切分与回退路径设计
工作集实在缩不进硬件预算时,剩下的路是把一个大事务切成多个小事务,以及设计一条区分中止原因的回退路径。
事务切分的正确姿势是按「数据分片」切,不是按「时间」切。比如要批量更新 1024 个桶,不要一个事务包全部,而是每 16 个桶一个事务、循环提交。每个小事务的工作集控制在安全预算内,容量中止自然消失。代价是失去了跨桶的原子性——业务上要么能接受,要么需要应用层的补偿逻辑。这是 HTM 最本质的 trade-off:硬件给你的原子性有容量上限,超出的部分原子性让位给吞吐。
回退路径是 HTM 代码里最容易写错的部分。反面教材是「不管什么中止都重试 N 次再拿锁」——容量中止重试纯浪费周期。正确的回退逻辑:
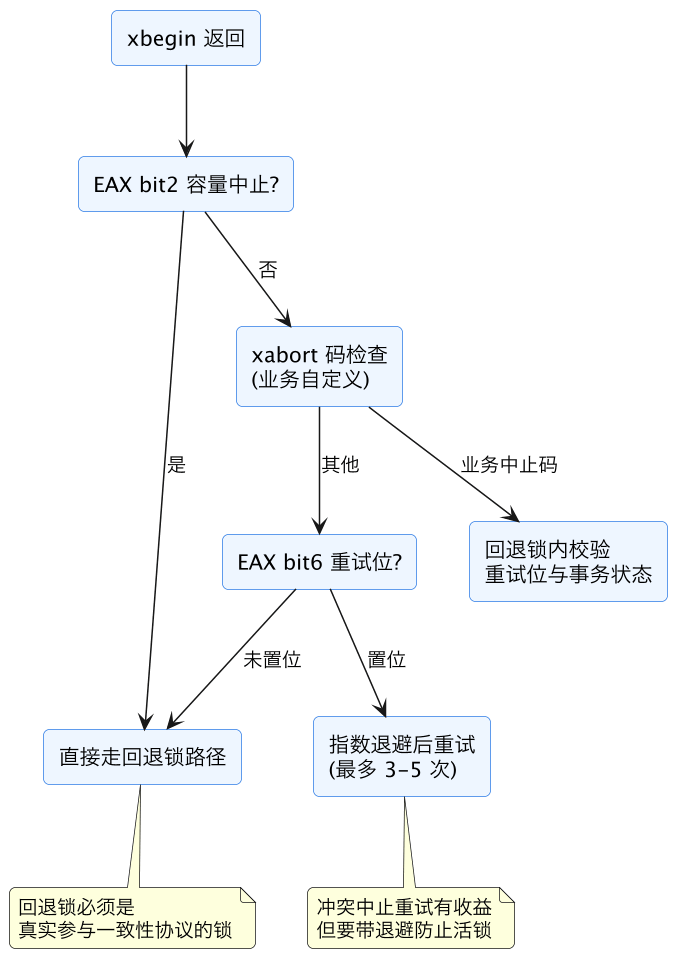
两个要点必须强调。第一,回退锁要「参与事务的一致性」:回退路径拿的那把锁本身必须被事务的读集订阅(典型做法:事务里先读一次锁变量),否则回退线程拿锁改数据时,其他还在事务里的线程感知不到冲突,正确性直接崩盘。这是 TSX 与 HTM 锁省略 里讲过的 subscription 机制,也是线上事故的高发区。第二,重试要带指数退避:16 线程同时冲突同时重试,没有退避就是互相踩踏的活锁;实测 3-5 次重试 + 每次倍增几十纳秒的随机退避,能把冲突中止的转化率提到最高。
回退锁本身的开销也别忽视:如果中止率已经高到「回退路径成为主路径」,等于所有线程退化成串行拿一把全局锁,还白付投机启动/回滚的成本——这正是 split lock 与总线锁的性能惩罚 讨论的「锁一集中,一致性流量就爆炸」的同一物理。
六、什么时候该放弃 HTM
HTM 不是免费午餐,识别「该撤退」的信号和调优同样重要。三个明确的撤退信号。
容量中止结构性无解:临界区的语义就要求「原子地扫一个大结构」(比如全量校验、跨分片迁移),工作集怎么也缩不进 LLC 预算。此时硬上 HTM 只是给每次操作附加几百周期的投机浪费。
中止率随负载恶化且无上限:冲突中止可以用错峰、分片缓解,但如果业务本身就是「所有线程抢同一行」(计数器、全局队列头),HTM 的高并发提交率趋近于零,不如直接用 lock xadd 这类窄原子指令——参考 原子 fetch-add 竞争 的量化数据,单行原子操作在高度竞争下的吞吐反而稳定。
虚拟化/云环境不可控:部分 hypervisor 默认关 TSX 或打了微码补丁禁用(TSX 历史上因安全漏洞被微码禁用过的代次不少),你的调优结论换个宿主机就失效。云上依赖 HTM 的优化要先确认 cpuid 的 RTM 位和微码版本。
撤退的替代方案优先级:细粒度锁(每分片一把)> 无锁算法(CAS 循环)> 全局锁 + 降低临界区成本。HTM 的合理定位是「中等竞争、中小临界区、可控部署环境」下的加速器,不是银弹。
补一条工程落地的时间线建议:上 HTM 改造之前,先花一天把 rtm_retired 系列事件接进现有监控,拿真实流量的基线;改造上线后盯两周的提交率与回退锁拿取频率,而不是只看上线当天。容量中止有个阴险的特性——它随数据规模增长而增长,上线时数据量小一切正常,三个月后表涨了十倍中止率悄悄爬过临界点,性能回退被误报成「业务变慢」。把提交率做成告警指标(比如低于 85% 报警),是这类改造不被反噬的关键。
这一篇在知识体系里的位置
本篇是 TSX 与 HTM 锁省略 的工程调优篇,锁实现的底层机制见 原子锁的缓存行实现,锁竞争的宏观代价见 split lock 与总线锁的性能惩罚 与 原子 fetch-add 竞争;观测方法复用 perf 计数器与 PMU 编程 的事件编程套路。
总结
HTM 容量中止调优的核心是「先分类、再下药」:用 EAX 原因码把中止拆成容量/冲突/指令三类,容量中止靠收缩工作集(挪只读、挪分配、错开组相联)和按数据分片切事务解决,冲突中止靠带退避的有限重试缓解,回退路径必须让锁参与事务订阅;当工作集结构性超预算或竞争集中到单行时,果断退回细粒度锁——HTM 是中等竞争场景下的加速器,不是无预算的原子性。