访存层级延迟带宽全景图:从寄存器到 CXL 的七个量级与微架构成因
更新时间:2026-10-04。本站在存储层级方向已经攒下了一批零件级深文:缓存一致性协议 MESI 与 MOESIF 讲多核之间缓存行怎么流转,DRAM 子系统组织 讲 channel/rank/bank 的物理结构,NUMA 本地与远端访问延迟 讲跨插槽的代价,CXL 内存扩展延迟 讲新型扩展内存的开销,TLB 两级设计与 STLB 讲地址翻译这一隐藏关卡。零件都齐了,缺的是一张把它们钉在一起的地图:一次 load 指令从发出到拿到数据,到底可能花多少时间?为什么差出四个数量级?miss 落在哪一级决定了你的程序是「计算受限」还是「内存受限」?这篇枢纽文就是这张地图。
本文要回答的问题
- 访存层级延迟带宽的完整梯队是哪几级,各级差多少?
- 为什么 L1 只要 4 个周期而 DRAM 要 200 多个周期,物理上差在哪?
- 带宽和延迟为什么是两回事,流水线如何掩盖延迟却掩盖不了带宽?
- LLC miss 之后请求走了哪条路,NUMA 和 CXL 在这条路上各加了多少钱?
- TLB miss 为什么是「隐藏的第零级」,它怎么放大每一级的延迟?
- 拿到一个慢程序,如何用这张地图三步定位到具体的层级?
一、全景表:七个量级,四个数量级
先把全篇最重要的一张表立起来。以下数字是 2024-2026 年主流服务器平台(Intel Sapphire Rapids / AMD Genoa 级别,DDR5)的典型量级,具体值随平台浮动,但数量级关系十年没变过:
| 层级 | 典型容量 | 命中延迟(周期,约 3GHz) | 命中延迟(纳秒) | 单核可用带宽 | 相对寄存器 |
|---|---|---|---|---|---|
| 寄存器堆 | 几百字节 × 约 200 物理寄存器 | 0-1 | ~0.3 | 每周期多次读写 | 1× |
| L1 D-Cache | 32-48 KB / 核 | 4-5 | ~1.5 | ~100+ GB/s | ~5× |
| L2 Cache | 1-2 MB / 核 | 12-16 | ~5 | ~60 GB/s | ~15× |
| LLC(L3,本地 slice) | 每核摊 1.5-3 MB,总计 30-100+ MB | 33-50 | ~15 | ~30 GB/s | ~40× |
| LLC(远端 slice,跨 mesh) | 同上 | 60-90 | ~25 | ~25 GB/s | ~80× |
| 本地 DRAM | 每插槽数百 GB | 200-300 | 70-100 | 单核 12-20 GB/s,整插槽 300-500 GB/s | ~250× |
| NUMA 远端 DRAM | 另一插槽 | 400-600 | 140-200 | 受互连限制 | ~500× |
| CXL 扩展内存 | 可再扩数百 GB | 600-1000 | 200-350 | 受 x8/x16 链路限制 | ~800× |
这张表要读出三个感觉。第一,延迟是阶梯,不是斜坡——每一级之间是 3-5 倍的跳变,从 L1 到本地 DRAM 累计差出 60 倍以上。第二,容量和速度严格互斥,大的一定慢,快的一定小,这是 SRAM 单元面积、走线距离、bank 并行度共同决定的物理现实,不是工程师不努力。第三,带宽的衰减比延迟慢得多——L1 到 DRAM 延迟差 60 倍,单核带宽只差 5-8 倍,这正是流水线能救场的地方,第二节细说。
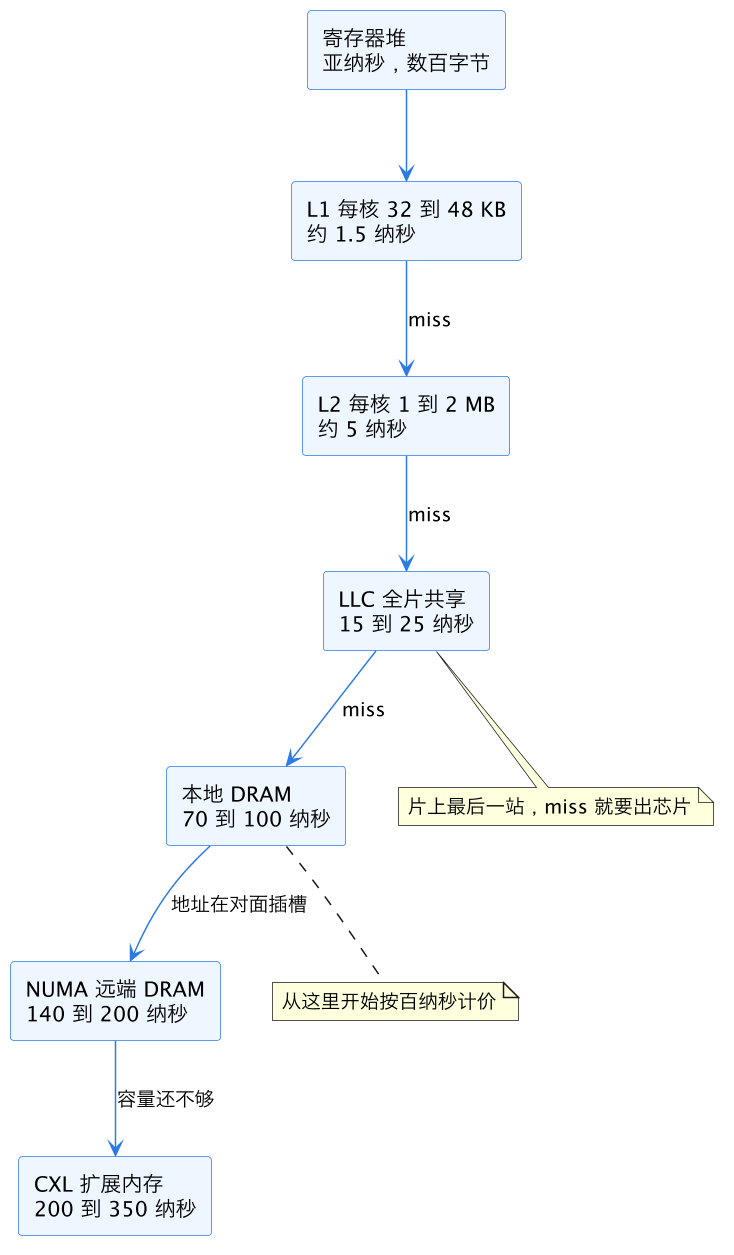
上图是请求逐级下钻的路径。注意一个关键事实:这条链不是必走全程的,每一级都是一次赌博——命中就停,miss 才往下走。所以程序的真实平均访存延迟是「各级命中率 × 各级延迟」的加权和,一个 95% 命中 L1 的程序和一个 50% 命中 L1 的程序,即使跑同一份代码,平均延迟能差出 3 倍以上。这就是「访存层级延迟带宽」作为分析地图的核心用法:先看 miss 率落在哪一级,再对着那一级的延迟档位估算代价。
再给一个直觉锚点,把纳秒换算成人类尺度:假如一次寄存器访问是 1 秒,那么 L1 命中约 5 秒,L2 约 15 秒,LLC 约 1 分钟,本地 DRAM 约 4 分钟,NUMA 远端约 8 分钟,CXL 约 12 分钟,NVMe 则是几天。程序员随手写的一次「无关紧要」的指针解引用,如果落到了 DRAM,相当于流水线停下来喝了 4 分钟茶——而这段等待在 top 里完全看不见,CPU 利用率照样显示 100%,因为核在忙等。这就是访存问题最隐蔽的地方:它不表现为「CPU 空闲」,而表现为「CPU 很忙但不出活」,不看计数器永远发现不了。
还有一个平台演进趋势值得知道:近十年各级的相对格局没变,但绝对差距在缓慢拉大。核心频率、缓存容量年年涨,DRAM 的 tRCD 和 tCL 却几乎不动——因为 DRAM 单元的物理是电容充放电,不随工艺等比缩小。结果就是以周期计的 DRAM 延迟一代比一代高(DDR3 时代约 150 周期,DDR5 时代已到 250-300 周期),「内存墙」三个字不是比喻,是财报级的产业现实,也是 HBM、CXL、3D 堆叠缓存这些技术相继出现的根本原因。
二、为什么是这些数字:微架构成因逐层拆解
表上的每个数字背后都有一段物理。知其然更要知其所以然,否则换一代平台你就不会估了。
寄存器堆快是因为它就在执行单元旁边,用触发器阵列实现,读写口多(一个乱序核每周期要读 6-10 个、写 3-4 个寄存器),容量被多端口成本死死压住,物理寄存器也就一两百个。它不是缓存,是流水线的一部分。
L1 的 4-5 周期是「能在一个流水线节拍里完成 load 的极限」。这 4 个周期里要塞下:TLB 查虚拟地址、用索引位选 set、读出所有 way 的 tag、比较命中、选通数据、送回寄存器——这也是为什么 L1 容量被钉在 32-48 KB:再大,tag 比较和选通的走线延迟就塞不进 4 个周期了。L1 普遍采用 VIPT(虚索引实 tag),让 TLB 查询和缓存读并行,省掉串行等待;由此引出的别名问题见 缓存 VIPT 与 synonym 别名。
L2 慢到 12-16 周期,不是电路慢,是距离远。L1 紧贴 load/store 单元,L2 在核的边缘,信号往返就要几个周期;加上 L2 容量大到必须分 bank、需要更复杂的 tag 阵列,10 个周期起步。从 L2 开始,缓存行统一为 64 字节,这是全层级的通用货币。
LLC 的 33-50 周期里藏着一个很多人不知道的变量:slice 距离。现代服务器 CPU 的 LLC 不是一整块,而是按 mesh 总线切成二三十个 slice,每个核「本地」的 slice 近,对角线上的 slice 远——同一次 LLC 命中,延迟可以差 2 倍以上,这就是上表把 LLC 拆成两行的原因。地址到 slice 的映射由一个未公开的哈希函数决定,细节见 LLC slice 哈希寻址。
本地 DRAM 的 200-300 周期是一次完整的「出片之旅」:LLC miss 后,请求经 mesh 到内存控制器,控制器按 FR-FCFS 策略排队调度(见 DRAM 控制器调度),发出激活命令打开 row,等 tRCD(行到列延迟,约 15ns),再发读命令,等 tCL(CAS 延迟,约 14ns),数据经总线传回,再穿 mesh 回到核。最好的情况(row buffer 命中、队列空)约 70ns,队列一挤、row 一冲突就上 100ns——DRAM 的延迟不是常数,是排队论问题。
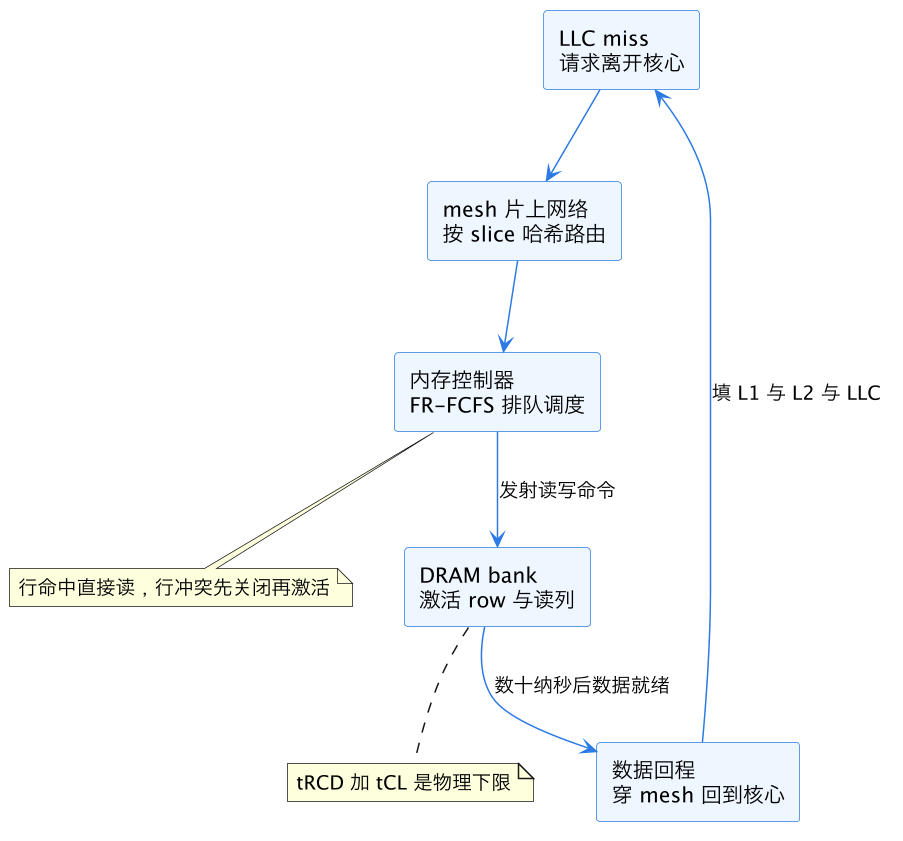
上图是一次 DRAM 访问的五段旅程。每一段的耗时都不是固定的:mesh 有竞争、控制器有队列、bank 有 row 冲突。所以「内存延迟 80ns」只是空载均值,满载时尾延迟可以翻两三倍——这也是为什么内存带宽打满的机器上,所有服务的 P99 都会一起恶化。
三、延迟与带宽:流水线能掩盖一个,掩盖不了另一个
访存层级延迟带宽这组词里,延迟和带宽必须分开理解,因为它们对性能的作用机制完全不同。
延迟是串行税。一次 load 的延迟只有在「后继指令依赖这个数据」时才真正咬人。乱序执行 + 非阻塞缓存(miss 时流水线不停,继续执行不依赖的指令)就是为掩盖延迟而生的:一个核同时挂起 10-20 个未完成的 L1 miss(受 Line Fill Buffer 数量限制,见 Line Fill Buffer),200 周期的 DRAM 延迟被摊成每个 miss 平均 10-20 周期。指针追逐型代码(链表遍历、哈希表探测)是掩盖的敌人——下一次访问的地址要等这一次的数据回来才算得出来,乱序窗口再深也无计可施,只能硬吃全档延迟。这就是为什么链表比数组慢一个数量级。
带宽是并行税,没人能豁免。当所有缓存层级都 miss、所有核都在要数据时,DRAM 的 300-500 GB/s 就是物理天花板。流水线能藏延迟,藏不了「每秒就只能来这么多字节」。内存带宽打满的典型症状:加核不加吞吐、IPC 集体跳水、perf stat 里所有核的 stalled cycles 一起飙升。STREAM 类拷贝、大规模 join、AI 推理的权重搬运都是带宽敏感型负载。
判断自己的程序卡在哪一边,看一个指标组合:IPC 低 + LLC miss 率高 + 但内存带宽占用率不高 → 延迟受限(多半是依赖链);带宽占用率逼近 70-80% → 带宽受限。两者的优化手段完全不同:延迟受限要改数据结构(拆链表、做预取、压缩对象),带宽受限要减流量(压缩、分块复用、减少拷贝)。方向搞反了,越优化越慢。
还有一个介于两者之间的第三态常被漏掉:延迟带宽双受限的转换点。随着并发度上升(更多核、更多线程、更深的乱序窗口同时在要数据),程序会从延迟受限逐渐滑向带宽受限——单线程跑是依赖链问题,64 线程一起跑就成了带宽问题。Little 定律在这里给出了精确的连接:系统需要的带宽 = 并发未完成的访存数 ÷ 平均访存延迟。一个核靠 10 个未决 miss、250 周期延迟,只能拉动约 20 GB/s;要喂饱 300 GB/s 的插槽带宽,必须几十个核同时挂起 miss。这也解释了为什么内存压测工具必须多线程跑满才有意义,单线程永远测不出插槽的真实带宽上限。硬件预取器(见 硬件预取器步长与流式检测)是带宽一侧的盟友:它把可预测的访问提前搬上来,既砍了有效延迟,又更均匀地吃掉了带宽空窗;对无规律的随机访问它不但帮不上忙,有时还因误取浪费带宽,perf 里可以用 uncore 事件观察预取流量占比。
| 特征 | 延迟受限(latency-bound) | 带宽受限(bandwidth-bound) |
|---|---|---|
| 典型代码形态 | 指针追逐、随机探测 | 流式扫描、批量拷贝 |
| LLC miss 率 | 高 | 高 |
| DRAM 带宽占用 | 中低(<40%) | 高(>70%) |
| 加核效果 | 近似线性 | 提前饱和 |
| 预取器帮助 | 有限(访问无规律) | 显著(流式可预测) |
| 优化抓手 | 数据结构、数据局部性 | 减流量、压缩、NUMA 绑核 |
四、多核变量:MESI 让「命中 L1」也分贵贱
到目前为止的讨论都假设单核独享缓存。多核一上来,地图要加一层:同一级缓存,命中的代价还取决于这行数据现在「在谁手里、是什么状态」。这就是 缓存一致性协议 MESI 与 MOESIF 那篇的主场,这里只取它对延迟地图的影响。
读一个 M(Modified)状态但躺在别的核 L1 里的缓存行,比读 LLC 还贵:请求要先经 mesh 找到那个核,让它把脏数据写出来(snoop 命中后转发),延迟 60-100 周期起步。写共享行更惨——要先发 invalidate 让其他核的副本作废,拿到独占权才能写,这个「读-使无效-独占」的往返就是著名的 RFO(Read For Ownership)。多个核对同一个缓存行反复写,就退化成「缓存行打乒乓」,每次写都是一次跨核 RFO,有效延迟直逼 NUMA 远端访问。
这引出性能分析里最经典的坑之一:false sharing(伪共享)。两个核写的是两个不相干的变量,但不幸落在同一个 64 字节缓存行里,硬件只认行不认变量,照样乒乓。症状极其反直觉:逻辑上零共享的代码,扩展性差得像有全局锁。排查工具是 perf c2c,修复手段是结构体字段按 64 字节对齐隔离。
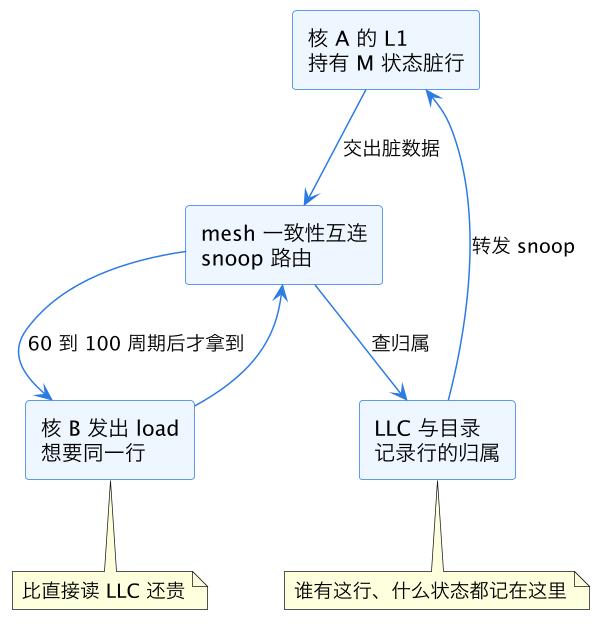
上图是一次跨核 snoop 命中的完整路径。要点:数据没有走 DRAM,却比 LLC miss 还慢——一致性流量和容量流量是两套账,分析多核程序时这张地图要叠着看。优化多核扩展性的第一原则不是「让缓存命中」,而是「让缓存行不要跨核流动」。
五、出片之后:NUMA 与 CXL 各加一档延迟
LLC miss 之后请求走出芯片,地图进入「地理篇」:数据在哪个内存条上,决定了要付多少路费。
NUMA(Non-Uniform Memory Access,非统一内存访问) 的双插槽服务器里,每个插槽挂自己的内存控制器和内存条,两个插槽之间用 UPI(Intel)或 xGMI(AMD)互连。访问本地插槽内存就是上一节说的 70-100ns;地址落在对面插槽,请求要再过一次插槽间互连,延迟涨到 140-200ns,带宽还被互连链路(单向几十 GB/s,远低于本地内存的数百 GB/s)掐住喉咙。完整拆解见 NUMA 本地与远端访问延迟。
NUMA 对性能地图的修正很直接:同一个「DRAM 级」延迟档位,实际是两档。更阴险的是它常常不声不响地生效——内存分配默认走 first-touch 策略(哪个核先碰这页,页就落在哪个插槽),如果初始化数据的线程和后来用数据的线程不在一个插槽,所有访问都变成远端。numastat 看 miss 分布、numactl --interleave 或绑核绑内存是标准解法。
CXL(Compute Express Link) 是 2024 年后开始落地的新一层:通过 PCIe 物理层外挂内存扩展设备,容量可以几乎无限加,代价是协议栈往返再加 100-200ns,落在 200-350ns 一档。详见 CXL 内存扩展延迟。它的定位不是「替代 DRAM」,而是在 DRAM 和 NVMe 之间插入一个容量便宜、延迟可控的中间档:热数据留本地 DRAM,温数据(大模型 KV cache、冷缓存页、内存数据库的旧分片)放 CXL,用 tiered memory 策略按页迁移。
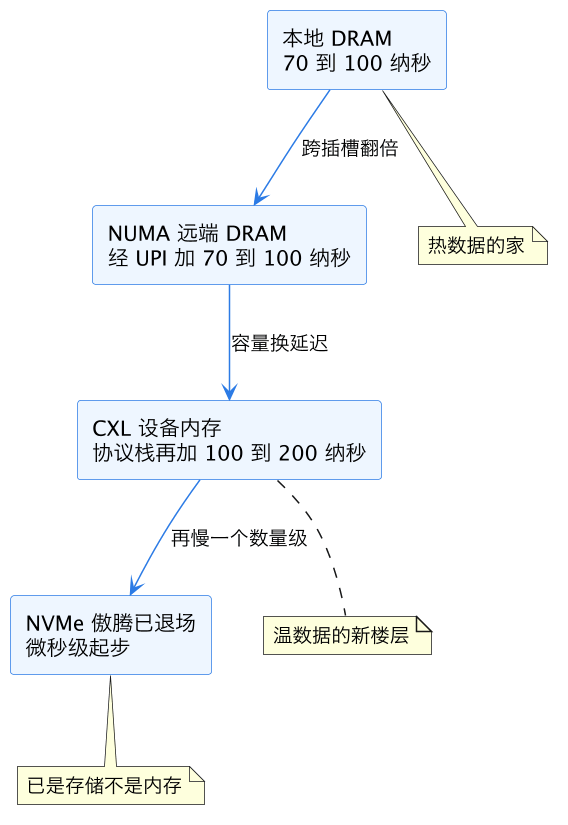
上图是「出片之后」的延迟阶梯。读法:从 NUMA 远端到 CXL 再到 NVMe,每一档比上一档贵约一倍起步、容量大一个量级。分层的意义不是让所有数据都快,而是让每份数据待在「配得上它的访问频率」的那一层——这就是现代内存分层的全部哲学。
六、隐藏的第零级:TLB 在每一级前面都收一次税
上面所有延迟数字都隐含一个前提:地址翻译已经完成。实际上每次访存的第一步是把虚拟地址翻成物理地址,这个查表动作走 TLB(Translation Lookaside Buffer,地址翻译后备缓冲),它就是贴在所有层级前面的「第零级」。
TLB 自己是两级结构(见 TLB 两级设计与 STLB):L1 DTLB 只有几十项,随 load 流水并行查询,命中不额外花钱;miss 了查 STLB(约 1500-2500 项),多花 7-10 个周期;STLB 也 miss,就要硬件页表遍历器走 4 级页表,每一级页表本身又是一次内存访问(可能命中缓存、可能落 DRAM),一次 page walk 最坏要 4 次访存,数百个周期。TLB miss 的代价会乘在每一级缓存延迟上:你以为 LLC 命中是 40 周期,如果前面叠一次 page walk,就是 40 加几百。
缓解手段是增大页尺寸:4KB 页下 1500 项 STLB 只覆盖 6MB 内存,2MB 大页下同样项数覆盖 3GB——大页把 TLB 的「射程」扩大 512 倍,对几十 GB 堆内存的 Java/数据库负载,光是切透明大页就能把 STLB miss 率砍掉一个数量级。细节见 大页与 TLB 压力。判断自己有没有这个税:perf stat -e dTLB-load-misses,stlb-miss 看占比,dTLB miss 占 load 总数超过 1% 就值得动手了。
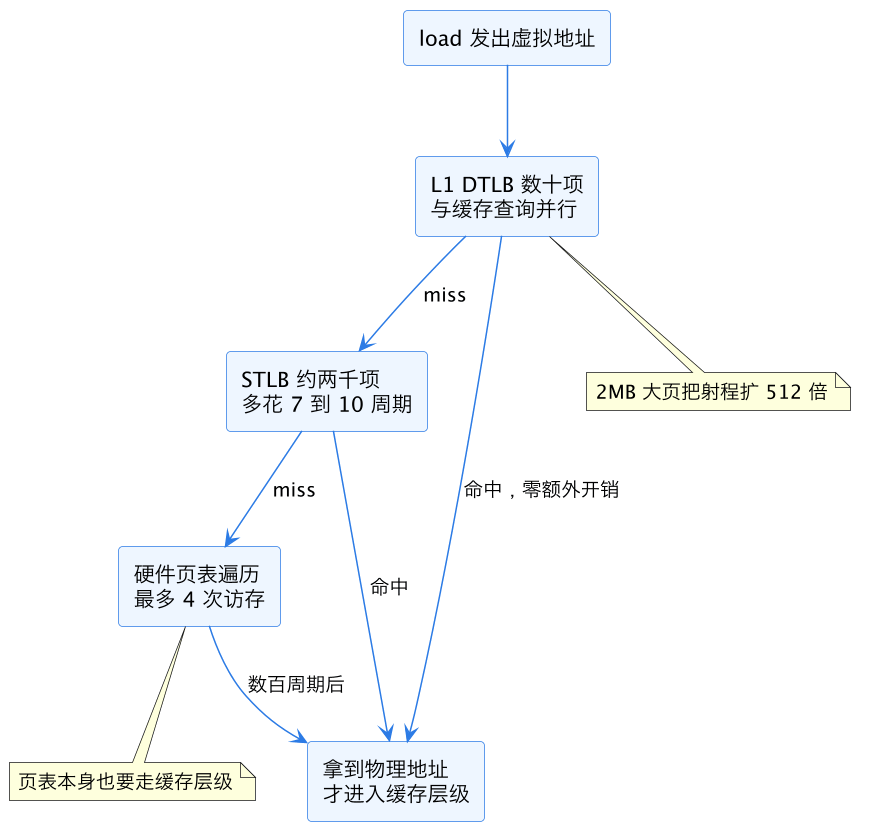
上图是地址翻译的三级漏斗。把这张图叠在前面所有层级图上,才是完整的访存地图:每一次访存的实际延迟 = TLB 税 + 对应层级的数据延迟。两者独立优化,缺一不可。
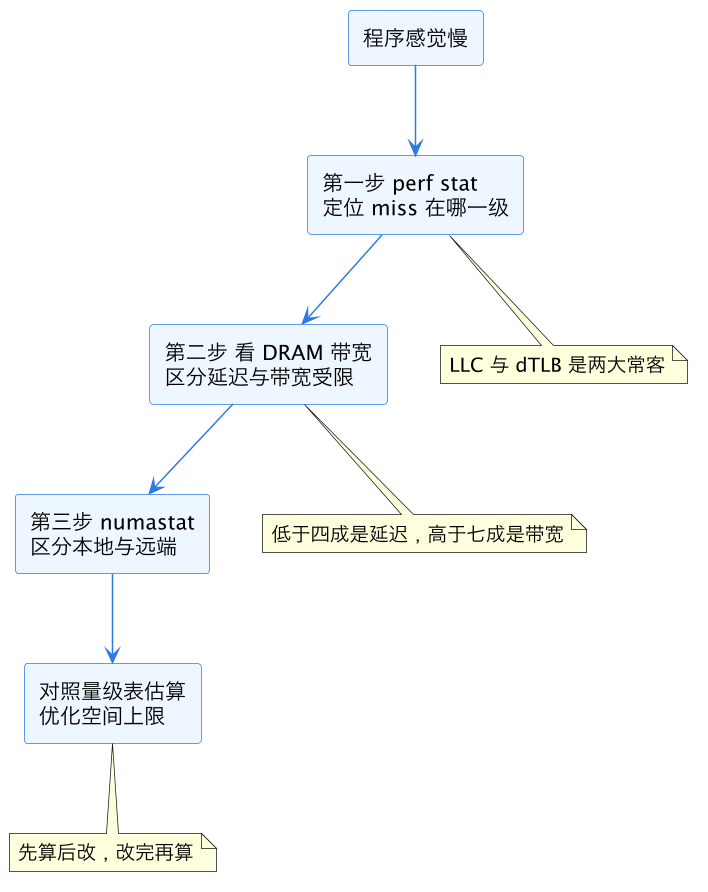
七、用这张地图做定位:三步法
地图的价值在导航。拿到一个「感觉慢」的程序,按三步走:
第一步,定性:miss 落在哪一级。 perf stat -e cycles,instructions,L1-dcache-load-misses,l2_rqsts.miss,LLC-load-misses,dTLB-load-misses 一把梭。L1 miss 率 <5% 且 IPC 正常,访存不是瓶颈,去看计算;LLC miss 率高但 LLC 之后的延迟占比高,进入第二步;dTLB miss 率异常先上大页,这是最便宜的胜利。
第二步,定量:延迟对带宽。 看 DRAM 带宽占用率(perf 的 uncore 事件或 pcm-memory)。低于 40% 是延迟受限——回去查依赖链和数据结构局部性;逼近 70% 以上是带宽受限——想减流量。多核程序加一步 perf c2c 排除伪共享。
第三步,定界:本地还是远端。 双插槽机器上 numastat -p <pid> 看 miss 分布,远端访问占比高就用 numactl 绑核绑内存,或检查是否初始化线程和消费线程分离。有 CXL 分层的环境里,再看冷热页的迁移策略是否把热页错放到了慢层。
三步走完,你手里就有了「瓶颈层级 + 受限类型 + 数据位置」的三元组,对照第一节的量级表直接估出优化空间的上限——比如 LLC miss 占 30% 平均延迟、而你把命中率降到 10%,整体就能快约 15%。先算后改,改完再算,这是地图式分析和盲人摸象式调优的分水岭。
最后给两个真实场景的完整推演,把三步法走一遍。场景一:一个 Java 缓存服务,P99 毛刺,perf stat 显示 LLC miss 率 12%(不高),但 dTLB miss 占 load 的 4%——问题不在数据层级而在第零级,堆内存 64GB 全走 4KB 页,STLB 射程只有几 MB,开启透明大页后 dTLB miss 掉到 0.3%,P99 直接减半,一行代码没改。场景二:一个 48 线程的 OLAP 扫描作业,加线程不加吞吐,pcm-memory 显示读带宽 280 GB/s 已逼近插槽上限——带宽受限,改代码没用,要么上压缩列存减少扫描字节数,要么把热分区用 numactl 钉在本地插槽避免远端带宽减半,两个手段都属于「减流量」而非「提速度」。两个案例的共同点:症状都是「慢」,根因一个在第零级、一个在最后一级,没有地图只会在中间的代码层瞎找。
这一篇在知识体系里的位置
本篇是 concepts/microarch 目录下访存主题的枢纽,往上承接 CPU 微架构总览 的流水线视角,往下分发到五篇零件深文:一致性看 缓存一致性协议 MESI 与 MOESIF,DRAM 内部结构看 DRAM 子系统组织,跨插槽看 NUMA 本地与远端访问延迟,扩展内存看 CXL 内存扩展延迟,地址翻译看 TLB 两级设计与 STLB。工具侧落地配合 perf 使用指南 的计数器实操。遇到「程序慢但 CPU 没跑满」的经典症状,先回这篇拿地图,再决定钻哪一篇零件深文。后续如果这一层继续长出新的零件深文(比如 HBM 与 GDDR 控制器、缓存划分 CAT 的容量侧视角),本篇的量级表和内链清单也要跟着更新,保持地图始终是完整的一张。
总结
访存层级延迟带宽的全部要点就是一张量级表加一条心法:寄存器、L1、L2、LLC、本地 DRAM、NUMA 远端、CXL 七个层级延迟从亚纳秒跨到数百纳秒、容量与速度严格互斥,流水线能掩盖延迟却掩盖不了带宽,TLB 在每一级前还要收一次税——拿到慢程序先用 perf 三步法定出「瓶颈层级、受限类型、数据位置」,再对照量级表估算优化上限,先算后改。