RAS poison 消费流程:数据中毒标记的传播、消费与分级恢复
更新时间:2026-10-06。内存出不可纠正错误(UCE)之后会发生什么?教科书答案是「机器检查异常,系统崩溃」——但现代服务器 CPU 比这精细得多:错误数据可以先被打上一个「毒标」(poison)继续在缓存层级里流动,只有当某条指令真正消费了这份毒数据、且体系结构状态要被污染的那一刻,硬件才拉响警报。更妙的是警报还分等级:有的只要杀一个进程,有的必须整机复位。这套机制叫 RAS poison 消费流程,是把「内存坏了」从整机灾难降级为进程级事故的关键技术。本篇把毒标的生成、传播、消费触发、分级恢复一路讲到 Linux 的内存失败处理,上游背景见 Machine Check 与 RAS,相邻话题见 内存 RAS:ECC 与巡检擦洗。
本文要回答的问题
- poison 毒标是什么,在哪里生成、怎么在缓存层级间传播?
- 为什么「消费才报错」比「发现即报错」更好?
- UCNA、SRAO、SRAR 三个等级各对应什么场景和恢复路径?
- Linux 拿到 poison 事件后具体做什么,应用能感知吗?
一、为什么需要 poison:从「见错就崩」到「用错才报」
传统机器检查(MCA)哲学是保守的:硬件发现不可纠正错误,立即广播 machine check,所有核一起进异常处理,多数情况下内核只能 panic。理由是错误数据一旦流入体系结构状态,谁也算不清污染扩散到了哪里,与其带病运行不如当场去世。这个逻辑在大型机上成立,但在今天的通用服务器上代价太高——一次单 bit 不可纠错误就重启一台 128 核的宿主机,上面几十个 VM 陪葬。
poison 机制换了个思路:错误数据本身不可怕,可怕的是它被「消费」——被当作操作数参与计算、被当作地址参与寻址、被写回内存或发送到网络。如果数据只是静静地躺在某条缓存行里,甚至从头到尾没人读它(这在真实负载里比例惊人:很多被写入的缓存行在被驱逐前根本没被读过),那就完全没有理由惊动系统。于是硬件给错误数据打上 poison 标记,让它继续流动,只在消费点才按污染程度分级响应。这样「内存坏了」的后果从「必然整机复位」变成「大概率无人察觉,小概率杀一个进程,极小概率才复位」。
这个哲学转变有一个更深的前提:错误检测比错误定位便宜。ECC 能告诉你「这份数据错了」,但定位「这份错误影响了哪些计算」代价极高;poison 机制干脆不做污染源追踪,而是把判断推迟到消费点——消费点天然知道是谁在用这份数据。这是「把决策推到信息最丰富的时刻」的又一个系统设计范例,和乱序执行把冲突判断推到调度器、事务内存把冲突检测推到提交点,是同一种思路。
二、毒标的生成与传播
毒标的生成点通常在内存控制器。ECC 解码发现不可纠正的多 bit 错误时,内存控制器有两个选择:直接报 UCE,或者把这份数据连同 poison 标记一起交给请求方。选择后者的前提是下游能理解毒标——现代 Intel/AMD 服务器的缓存一致性协议里,数据在总线上传输时可以附带 poison 指示位,L3/L2/L1 收到后把标记存在缓存行的元数据里(实现上可以是一个单独的 poison bit,也可以借 ECC 编码里的特殊码字表示)。
传播规则很关键:poison 随数据走。带毒缓存行被读到上级缓存,上级缓存行也带毒;被另一核 snoop 走,对方的缓存行同样带毒;被写回内存,内存控制器知道这个写回的数据是毒的(视平台可能记录或丢弃)。标记的语义是「这份数据不可信」,而不是「这份数据是某个特定值」——所以 poison 不因数据被复制而稀释,也不因缓存行被移动而丢失。
有一个工程细节值得展开:毒标在缓存层级里的存储成本不是免费的。一种实现是给每条缓存行加一个 poison bit,这增加元数据面积;更常见的做法是复用缓存行自带的 ECC/奇偶校验编码——把错误数据写进缓存时故意把校验位写成「永远不匹配」的特殊组合,这样任何后续读取都会自然触发校验失败,等于用现成的校验通路当毒标载体。后一种方案零额外面积,但意味着毒数据在缓存里的每一次被读(包括预取、包括窥探)都可能触发检测逻辑,所以硬件要仔细区分「探测性读取」(不算消费,UCNA 级别记录)和「体系结构消费」(数据进了寄存器要被指令用掉)。预取器读到毒行不会报错——这是「消费才报」哲学的必然推论,也是为什么 poison 机制对真实负载如此宽容:大量毒行在被驱逐出缓存前根本没被任何指令真正用过。

上图只画了读路径。还有一条隐蔽的生成路径是巡逻擦洗(patrol scrub,见 内存 RAS:ECC 与巡检擦洗):scrub 引擎后台扫内存时发现 UCE,此时没有任何请求方在等这份数据,控制器可以把该地址标记为 poison 并上报一个「延迟型」错误——这就是 SRAO 等级的来源,后面细讲。
三、消费触发:三个等级的语义
毒数据被消费时,硬件看两件事决定响应等级:消费发生在哪里(体系结构状态污染了没有)、能不能精确定位到指令(recoverable 与否)。Intel 的分级是:
| 等级 | 全称 | 语义 | 恢复路径 |
|---|---|---|---|
| UCNA | Uncorrected No Action required | 不可纠正但无需动作(毒数据被探测到但未消费) | 记录日志,内核可离线该页 |
| SRAO | Software Recoverable Action Optional | 毒数据在缓存/内存中被发现(如 scrub),尚未消费 | 内核可选地把页面 offline,几乎无感 |
| SRAR | Software Recoverable Action Required | 毒数据已被消费,但硬件精确定位到消费指令与地址 | 必须行动:杀进程或恢复页,可免复位 |
SRAR 是最体现工程价值的等级。它要求硬件做到三件事:消费毒数据的 load 被精确标记(IP 有效)、被污染的体系结构状态被圈定在最小的范围内(通常就是一个进程的地址空间)、硬件状态本身未被污染。满足这三条,内核收到的就不是「天塌了」而是一个可执行的恢复任务:找到这个物理页属于哪个进程,给那个进程发 SIGBUS(或按配置 kill),把物理页从系统里摘除。其他进程、其他 VM 完全无感。
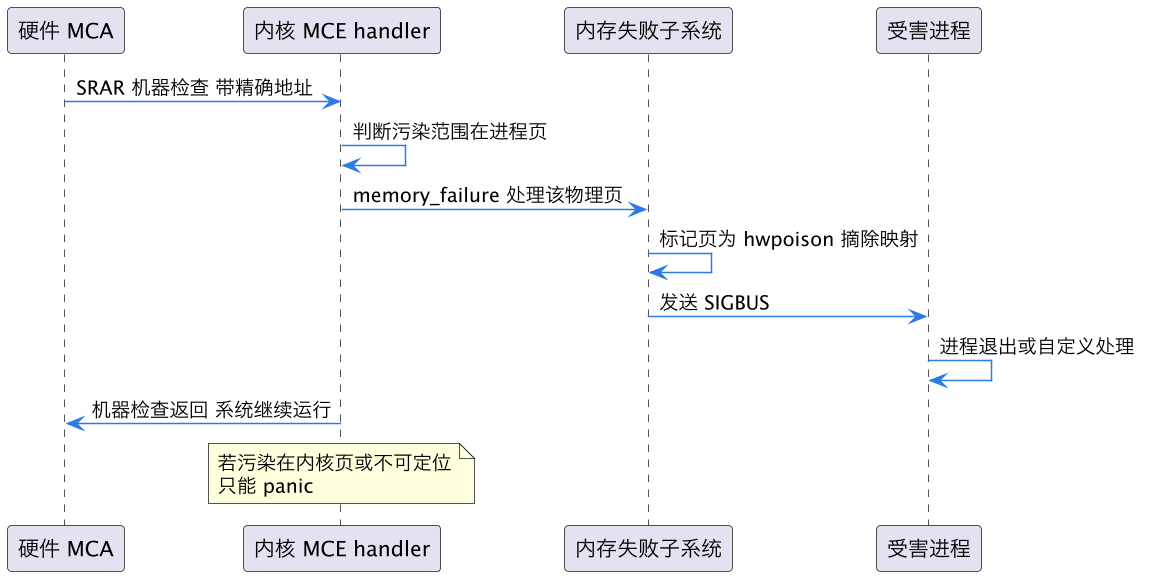
上图里最值得注意的是那条旁注:恢复能成功的前提是污染被限制在「用户态一个页」的尺度。如果毒数据消费发生在内核上下文、或者硬件无法精确定位(比如错误在传播链中被进一步扩散),SRAR 的优雅退场就不成立,机器检查还是只能 panic——poison 机制降低的是灾难概率,不是消灭灾难。
分级的边界条件再补几条实际经验。其一,毒数据被当作指针解引用,和被当作普通数值参与计算,恢复难度相同——都是 SRAR;但如果毒数据被写进了页表、被当作中断向量索引用掉,体系结构状态已经扩散,基本告别恢复。其二,SRAO 的「action optional」给了内核策略空间:发现的毒页如果是空闲页,直接摘掉即可;如果是热点数据页,摘除会迫使下次访问走存储重读,内核要权衡时机。其三,UCNA 很多时候连日志都不进内核主线(取决于固件 APEI 配置),只有通过 rasdaemon 这类守护进程才能完整收集,不配就等于瞎了——很多人以为「机器从来没出过内存错误」,其实只是没人收事件。
四、Linux 的内存失败处理
Linux 侧的承接者是 mm/memory-failure.c。内核收到可恢复的 poison 事件后,核心动作是按物理页走恢复流程:先查这个页是干净页还是脏页、有没有被换出、属于哪个文件或匿名映射。干净页(比如 page cache 里可从磁盘重读的页)最幸运——直接丢弃,下次访问时重新从存储读,进程甚至不需要死。脏页和被消费的匿名页才需要 SIGBUS。
几个可观测接口值得记住:/proc/sys/vm/memory_failure_early_kill 控制是在摘除映射时就杀进程(激进,防扩散)还是等进程真正访问到毒页才杀(保守);rasdaemon 用户态守护进程把 MCE 事件持久化成结构化记录,配合 mcelog(老平台)可以做坏页趋势分析——同一 DIMM 上 poison 事件频率上升是内存条临终的典型征兆,数据中心据此做预测性更换。虚机场景里,KVM 会把 poison 事件注入 guest(通过 MCE 注入机制),让 guest 自己走 memory_failure 流程,宿主机只负责摘除物理页。
还有一个容易混淆的点:poison 页面被 offline 后,那个物理页框就被永久拉黑了(存在 bad page 列表里),但同一条 DIMM 的其他页照常用。这和「整列/整 rank 拉黑」的内存镜像、备用 rank(spare rank)等更重的 RAS 手段是两个层级——poison 处理是外科手术,镜像和备用是器官移植,成本天差地别,选型见 Machine Check 与 RAS 里的分级讨论。
把整条流程在 Linux 里走一遍时序:MCE 中断或 APEI 通知到达 → do_machine_check 解析 MCi_STATUS 寄存器确认是 SRAR/SRAO → 提取出错的物理地址 → 调用 memory_failure() → 该函数查页的归属与状态,走 hwpoison 摘除路径 → 对映射了该页的进程发信号或设置 PG_hwpoison 标记 → 返回后机器检查正常返回,系统继续运行。整个过程中其他核最多被 IPI 打断一次做 TLB 同步,没有全局停顿——对比一下传统 UCE panic 路径上「所有核进 NMI 风暴、打印寄存器、复位」的场面,就能理解为什么 RAS 社区把 poison recovery 称为过去十年服务器可用性最重要的进步之一。
五、对应用与运维的实际意义
把机制落成几条规定动作。第一,应用侧:处理大内存数据的服务(数据库、缓存、科学计算)应当给 SIGBUS 安装处理器或至少接受它——poison 消费是 SIGBUS 在健康硬件上为数不多的合法来源之一,默认行为是进程死亡并产生 core,对数据库来说这意味着「某页数据物理损坏」,合适的响应是终止受影响的事务并用副本重建,而不是盲目重试同一地址。
第二,运维侧:把 UCNA/SRAO 事件接进监控。这两类事件本身不造成任何业务影响,但它们是「未来会发生 SRAR」的先行指标——scrub 发现的毒地址越来越多,说明这条 DIMM 的物理缺陷在扩大。理想动作链是:rasdaemon 采集 → 阈值告警 → 计划性停机更换 DIMM,整个过程不经历任何一次真实的 SRAR 进程死亡。
第三,虚拟化/容器侧:确认你的内核与固件组合真的支持 SRAR 路径(部分老平台只支持到「报 UCE 就 panic」),并验证 KVM 的 poison 注入链路。云厂商的「内存错误自动摘除」能力底层就是这套流程;自建 KVM 集群如果没配 rasdaemon 和 early_kill 策略,第一次真实 UCE 很可能还是以宿主机 panic 收场——机制在硬件里,价值要配置才兑现。
第四,容量与采购侧:poison recovery 能力应当写进服务器的选型 checklist。同样支持 ECC 的两款平台,一个支持到 SRAR、一个只支持到 UCE panic,五年生命周期内的可用性差异是实打实的——内存故障是数据中心硬件故障的大头之一,每避免一次整机 panic 就避免一次几十台 VM 的集体迁移。这个差异在规格书上的关键词是「MCA recovery」「enhanced MCA logging」「poison consumption」,采购谈判时值得逐条确认。

这一篇在知识体系里的位置
本篇属于 microarch 层「可靠性与 RAS」专题的流程主线:机制总览见 Machine Check 与 RAS;错误来源侧衔接 内存 RAS:ECC 与巡检擦洗(poison 的上游生产者);子系统组织见 DRAM 子系统组织。向上回到 CPU 微架构总览;功耗烧机验证的可靠性交叉点见 功耗病毒与 AVX offset。
总结
RAS poison 消费流程把内存不可纠正错误从「发现即崩」改造为「消费才报」:内存控制器给错误数据打毒标,毒标随数据在缓存层级传播,只在被指令消费时按 UCNA/SRAO/SRAR 分级响应——scrub 发现的毒页可静默摘除,精确消费的用户态毒页由 Linux memory_failure 子系统发 SIGBUS 杀进程了事,只有污染进内核或无法定位时才退回 panic,整条链路把 UCE 的爆炸半径从整机压缩到一页。