内存屏障:fence 指令在流水线里到底干了什么、一次屏障要花多少个时钟周期
承 memory-consistency-models-tso——那一篇讲清了 x86 的 TSO(Total Store Order)内存模型允许哪些访存乱序、不允许哪些,结论是:硬件默认只保证单线程语义的正确,多线程间的可见顺序要程序员自己管。管用的工具就是内存屏障。屏障不是一根「魔法红线」,它落地到流水线里就是一套对 store buffer、load queue 的约束动作。store buffer 本身的工作原理见 store-buffer-write-combining 和 store-to-load-forwarding,本篇聚焦三件事:三条 fence 指令各自的语义边界、一次屏障在硬件上花了多少个周期、以及无锁代码里怎么把屏障用到最少。
本文要回答的问题
- LFENCE、SFENCE、MFENCE 三条指令各自约束什么,为什么 x86 上普通数据竞争只需要 LOCK 前缀?
- 一次 MFENCE 在流水线里到底做了什么动作,为什么贵?
- 屏障的代价是固定的还是和数据状态有关?能不能给出量化的周期数?
- 无锁队列、引用计数、发布-订阅这些经典模式里,屏障的最小集合长什么样?
- C++ 的
memory_order_*是怎么映射到 x86 指令的,选错了会多花多少?
一、为什么需要屏障:store buffer 带来的「自己看得见、别人看不见」
先回到硬件动机。乱序核心里,写(store)执行完并不代表数据进了缓存——它先落在 store buffer 里排队,等拿到缓存行的独占权(M 状态)才真正写进 L1。这样做是为了让 store 不阻塞流水线:写一个不拥有的行要等一致性协议往返,几十到上百个周期,没人想让流水线干等。store buffer 把这个延迟藏起来了。
代价是:核 A 写的值,在 store buffer 里躺着的时候,核 A 自己 load 能经 store-to-load forwarding 读到(见 store-to-load-forwarding),但核 B 读到的还是缓存里的旧值。这就是经典的 store→load 乱序窗口,也是 Peterson 锁、Dekker 算法在现代 x86 上不加屏障必挂的原因。
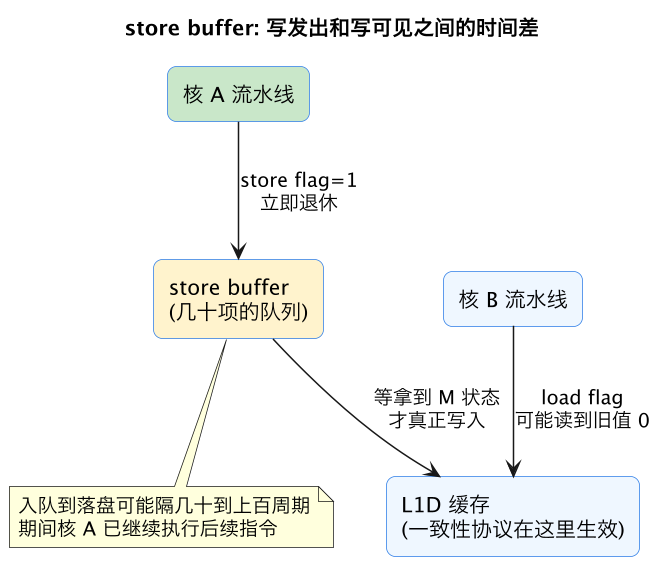
看一个具体的失败案例,双核各跑一段:
// 初始: x = y = 0
// 核 A                // 核 B
x = 1;                 y = 1;
r1 = y;                r2 = x;
直觉上 r1 == 0 && r2 == 0 不可能发生:如果 A 看到了 y == 0,说明 B 的 y = 1 还没执行,那 B 之后读 x 应该看到 A 已写的 1。但有了 store buffer,两个核的 x = 1 / y = 1 都可能压在各自的 buffer 里没落盘,两个 load 都读到旧值 0——两个零的结局真实存在,这就是 store→load 乱序在多线程下的可观测后果。Intel SDM 把这叫做「store buffer forwarding 对跨核可见性的延迟」,也是 TSO 模型唯一放行的那种乱序。
内存屏障的全部作用就是在这个「写了但还没被别人看见」的窗口上强加一个约束:屏障之前的访存,必须先对全系统可见,屏障之后的访存才允许开始。语义一句话,硬件实现却要动真格——这就是它贵的原因。
二、三条指令的语义边界:LFENCE / SFENCE / MFENCE
x86 提供了三条 fence 指令,约束强度递增:
| 指令 | 约束的乱序 | 形象说法 | 典型代价 |
|---|---|---|---|
| LFENCE | load 不能越过它提前执行 | 「读之前先等等」 | ~2-4 周期(纯流水约束) |
| SFENCE | store 不能越过它延迟落盘 | 「写必须先走完」 | ~6-10 周期(排空 store buffer) |
| MFENCE | load 和 store 都受约束 | 「读写都给我排好队」 | ~20-40 周期以上,随 store buffer 积压程度波动 |
三条指令的存在意义是「按需付费」:绝大多数场景你不需要 MFENCE 的全套约束。但 x86 的 TSO 模型有个反直觉的特性——普通对齐的 load 和 store 本身自带 acquire/release 语义(load 不允许越过前面的 load,store 不允许越过前面的 store),所以:
- 只用 LFENCE 防「读后乱序」的场景,x86 硬件本来就没这种乱序,LFENCE 编译成 nop 语义(实际仍占几个周期的前端槽位);
- 只用 SFENCE 防「写后乱序」的场景,同理硬件保证 store 按序落盘,SFENCE 在普通 WB 内存上近似空操作;
- 真正需要硬件干活的只有 store→load 这一种乱序,也就是 MFENCE(或等价强度的 LOCK 前缀指令)。
所以现实里 x86 上写的屏障,90% 以上是为了 MFENCE 的语义。ARM 上完全不同——弱内存模型允许几乎所有乱序,dmb ish 是真开销,四条 memory_order 全都有真实代价,这是另一个话题。
SFENCE 有一个真正的用武之地值得单独说:非时序写(non-temporal store,如 movntdq)和 WC(Write Combining)类型内存。这两类写绕开普通缓存路径,进的是 write-combining buffer,硬件不保证它们按程序顺序对全系统可见。用 SIMD 非时序写做大块内存清零、或写显存映射的 MMIO 区域时,写完必须跟一个 SFENCE,否则后续「通知对端数据好了」的那个标志位可能先于数据被别人看到——数据还在 WC buffer 里攒着没冲刷。内核 memcpy_toio、用户态 DPDK 的 MMIO 写入路径里都能见到这个组合。
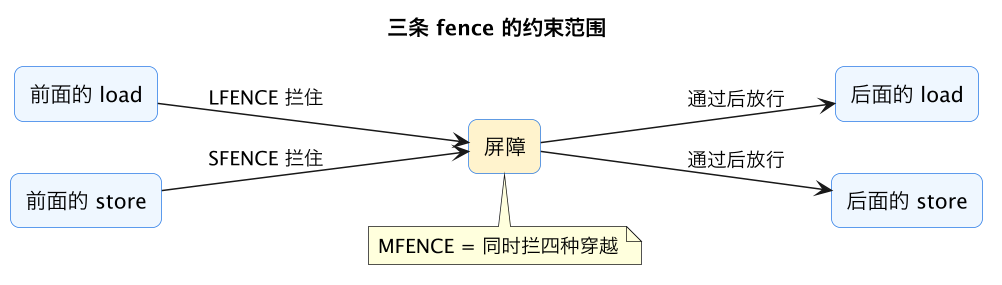
这张图里四条穿越路径对应四种乱序:load→load、load→store、store→store、store→load。x86 TSO 默认放行前三种里的「不危险者」,只留下 store→load 这一个口子,MFENCE 就是堵这个口子的。
三、MFENCE 在流水线里做了什么:store buffer 排空
LFENCE 在硬件上很简单:给乱序引擎加一个「分数板标记」,标记之后的 load 不允许发射,等标记退休就解除——几个周期的前端开销。MFENCE 则重得多,它要等两件事:
- store buffer 中所有早于屏障的项都完成落盘——每一项都要等到对应缓存行拿到 M 状态、数据写入 L1;
- 屏障之后的 load 在条件 1 满足前不允许发射(严格说不允许对全系统可见地执行)。
关键点在条件 1 的「完成」是动态的。如果屏障执行时 store buffer 是空的,MFENCE 几乎免费(<10 周期);如果里面压着 20 项等远端缓存行的 store,MFENCE 要陪它们一项一项耗完——这就是「MFENCE 代价 20~200 周期浮动」说法的来源。
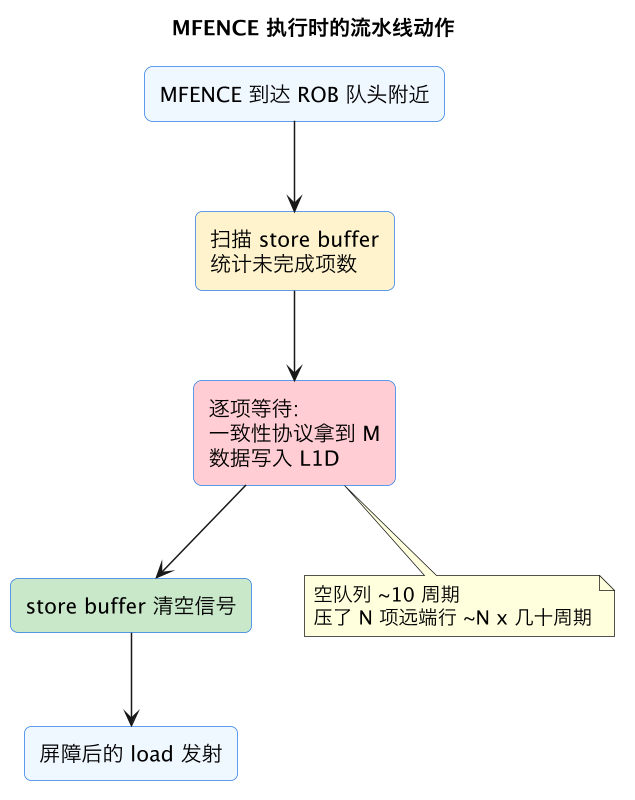
这里有个常被忽略的细节:MFENCE 的代价和程序前面的写密度强相关。一个刚写完一大块数据的线程撞上 MFENCE,和一个纯读线程撞上 MFENCE,是两种完全不同量级的停顿。做基准测试时如果不控制这个变量,同一条指令能测出相差 20 倍的数字,两者都对。
再往下钻一层,「逐项等待」到底在等什么。store buffer 里每一项要变成「对全系统可见」,需要该行在本核 L1 里处于 M(Modified)或 E(Exclusive)状态。如果行本来就在本核 M 状态,这项落盘就是几个周期的本地写;如果行在别的核手里(甚至刚被别的核改过,处于 M 状态),本核要发起一次 RFO(Read For Ownership)请求,走一致性协议把行抢过来——片上 mesh 一跳几十周期,跨插槽 UPI 往返 150 周期起步。store buffer 里压的 N 项如果指向 N 个不同的远端争抢行,MFENCE 就要串行陪跑 N 次协议往返。这也是为什么「写后立即屏障」是最坏的组合:写的协议延迟一点没被 store buffer 藏住,全部算在屏障头上。
还有一个实现层面的好消息:屏障之后被挡住的 load 不是完全躺平。现代微架构允许这些 load 做推测性预取(把行先拉进缓存、只是不提交结果),等屏障解除时命中缓存直接返回——实际的惩罚比「干等 + 重新发 load」的理论值要小一些。这也解释了为什么实测里 MFENCE 后紧跟 load 的开销经常低于纯加法预期。
四、LOCK 前缀:x86 上更常见的「隐形屏障」
x86 程序员很少手写 MFENCE,但几乎天天在用它的等价物——LOCK 前缀指令(lock xadd、lock cmpxchg、原子变量的 RMW 操作)。LOCK 前缀在语义上自带 full fence:它既执行原子读改写,又把访存顺序约束做到位。
工程上一个广为人知的优化是:C++ 的 std::atomic::store(v, memory_order_seq_cst) 在 x86 上编译成 xchg(自带 LOCK 语义)而不是 mov + mfence。GCC/Clang 的实测对比里,xchg 版本通常比 mov+mfence 快 10~30%,原因有二:指令数少一条(前端压力小),且 lock xadd/xchg 的硬件实现路径比独立的 MFENCE 更优化(现代微架构对 LOCK RMW 有专门流水)。
| 写法 | x86 汇编 | 约束强度 | 相对开销 |
|---|---|---|---|
store(relaxed) | mov | 无 | 1x |
store(release) | mov | 编译器屏障 + TSO 自带 | 1x |
store(seq_cst) | xchg | 全屏障 | ~5-10x |
mov + mfence | 两条指令 | 全屏障 | ~8-15x |
lock cmpxchg | LOCK RMW | 全屏障 + 原子性 | ~10-20x(含缓存行争抢) |
注意「release 免费的、seq_cst 要付费」这个不对称:写无锁代码时把默认的 seq_cst 降到 release/acquire,常常就是零成本——因为 x86 TSO 本来就给你这两个语义。
五、经典模式里的最小屏障集合
把上面几条结论落到三个无锁编程的高频场景:
场景 1:发布-订阅(message passing)。生产者写数据再置 flag,消费者读 flag 再读数据。最小需求:生产者的 store→store 顺序 + 消费者的 load→load 顺序。x86 上两者硬件都保证,所以:
// 生产者
data.store(v, std::memory_order_relaxed);
ready.store(true, std::memory_order_release);   // 编译器屏障即可
// 消费者
if (ready.load(std::memory_order_acquire)) {    // 编译器屏障即可
    auto v = data.load(std::memory_order_relaxed);
}
x86 汇编层面 acquire/release 都是普通 mov,屏障成本为零。这是无锁编程里最大的「免费午餐」,不吃白不吃。
场景 2:Dekker 式互斥 / Peterson 锁。双方各写自己的 flag 再读对方的——正是 store→load 乱序窗口,必须上 seq_cst(编译成 xchg),没有其他选择。这是 x86 上真正要付屏障钱的地方。
场景 3:引用计数 / RCU 式读取。读侧热路径上完全无屏障(memory_order_relaxed),写侧在销毁前用一个 release fence。Linux 内核的 RCU 就是这条路线的极致:读者零开销,写者等待一个宽限期。
场景 4:SPSC(单生产者单消费者)无锁队列。这是最常被过度加屏障的结构。核心观察:head 只有一个写者(消费者)、tail 只有一个写者(生产者),两个索引各自单写者,不存在 Dekker 式的互相等待。最小集合是:生产者写完数据后 tail.store(release),消费者 tail.load(acquire) 后读数据;反向对称。x86 上全部编译成普通 mov,一个硬件屏障都不用——如果在这种队列的热路径里看到 seq_cst 或 mfence,基本可以断定是白花的钱。
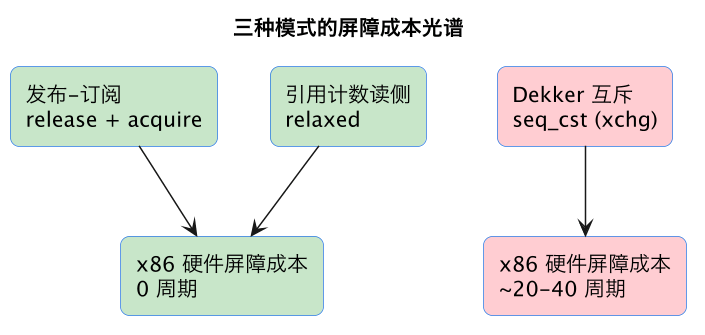
这张图的结论简单粗暴:三类模式里只有 Dekker 式要在硬件上掏钱,另外两类的屏障都被 x86 TSO 白送了。写无锁代码前先想清楚自己落在哪一类,往往能把「看起来必须有的屏障」整个消掉。
六、量化代价:实测数据与观测手法
给一组典型数字建立量级感(Ice Lake / Zen3 级微架构,单核环境,排除缓存争抢):
- 空 store buffer 下
mfence:~10-15 周期; - store buffer 压 10 项普通写后
mfence:~40-80 周期; - store buffer 压 10 项跨核争抢行的写后
mfence:~150-400 周期(一致性协议往返主导); lock xadd无争抢:~20 周期;有 4 核争抢同一行:~100+ 周期且随核数线性恶化。
第三条值得单独强调:屏障本身不贵,贵的是屏障前的写还没落盘。观测上,perf stat -e cycles,instructions 配合对比实验(屏障前后各加 N 个 store)可以分离出这两项。更精细地看,可以用 perf c2c 观察 HITM 事件——跨核争抢的屏障开销本质是缓存行在核间弹跳,弹跳细节见 cache-mesi-moesif-protocols。
一个自己动手的测量骨架(单核先建立基线,再多核加压):
// 基线: 空 store buffer 下的 mfence
for (int i = 0; i < N; i++) {
    asm volatile("mfence" ::: "memory");
}
// 加压: 屏障前压 k 个不同行的 store
for (int i = 0; i < N; i++) {
    for (int j = 0; j < K; j++) buf[j * 64] = i;  // 64 字节错开避免伪同行
    asm volatile("mfence" ::: "memory");
}
两轮测出的每迭代周期差除以 K,大致就是「每项未落盘 store 给屏障加价」的边际成本。把 buf 换成另一个核正在写的共享数组再跑一轮,就能看到跨核争抢如何把这条曲线斜率抬高一个数量级。
对生产代码的建议收敛成三条:
- 先把
seq_cst降到acquire/release:编译器屏障零成本,能消掉 80% 的「以为必须有」的硬件屏障; - 共享数据结构按缓存行对齐,消除伪共享:屏障代价和争抢行数成正比,行不弹跳屏障就便宜;
- 热路径上避免「写后立即屏障」:能批量做就批量做,让 store buffer 的排空被自然分摊。无锁队列的批出队(一次拿 8 个元素而不是一个个拿)就是这个思路——8 次操作摊一次屏障,单位开销降一个量级。
最后再提醒一遍平台差异:本篇所有「免费」结论只在 x86/TSO 上成立,同一份 C++ 代码编到 ARM 上,acquire/release 都会变成真实的 lda/stl 或 dmb 指令开销。跨平台的无锁库(如 Folly、Boost.Lockfree)之所以大量手写条件编译,根源就在这里。
这一篇在知识体系里的位置
本篇是「乱序执行 × 内存序」交叉点上的一篇,向上承接内存模型、向下落地无锁实践:
- memory-consistency-models-tso:x86 TSO 内存模型的语义基础,本篇的「哪些乱序被允许」直接引用那里的结论。
- store-buffer-write-combining:store buffer 本身的结构和合并优化,本篇把它作为屏障要排空的对象。
- store-to-load-forwarding:转发机制解释了为什么核 A 自己能读到 store buffer 里的值,这是屏障要管的「别人看不见」的另一半。
- cache-mesi-moesif-protocols:屏障排空的物理过程就是触发 MESI/MOESIF 的一致性消息,跨核争抢的开销在那篇有协议级拆解。
- cpu-out-of-order:乱序引擎全景,本篇聚焦其中访存顺序这一个维度。
- spectre-meltdown-transient-execution:LFENCE 作为推测执行缓解手段的另一面用途,与本篇的顺序语义互补。
总结
内存屏障是多线程程序对硬件乱序的「手工约束」:x86 上 LFENCE/SFENCE 在普通 WB 内存上近似免费,真正花钱的是 MFENCE 和 LOCK 前缀——它们要等 store buffer 里所有未落盘的写完成一致性协议,代价从空队列的十几周期到压满跨核争抢行的几百周期浮动;工程上的最小化手段就三条:能降到 acquire/release 就别用 seq_cst(x86 TSO 白送这两个语义)、消除伪共享让缓存行不弹跳、以及把「写后立即屏障」批量化分摊排空开销——理解了「屏障贵在前面的写还没落盘」,无锁代码的性能账就豁然开朗。