DRAM 写排空策略:读优先调度下写队列水位触发的 drain 机制速查
更新时间:2026-10-06。内存控制器(MC)的请求队列里同时躺着读和写,但 DRAM 总线是半双工的——同一时刻要么读要么写,切换方向要付一笔不便宜的总线周转(bus turnaround)开销。于是控制器普遍采用「读优先」策略:能调度读就先调度读,写请求在写队列里攒着;攒到水位(watermark)超限,才触发一次写排空(write drain),切换到写模式把积攒的写批量泄掉。这个机制对平均吞吐是划算的,但它给内存延迟引入了一种周期性的、与负载写强度相关的抖动模式——本篇速查 drain 的触发逻辑、切换成本、抖动特征和观测手段。背景见 DRAM 控制器 FRFCFS 调度 和 DRAM 子系统组织。
本文要回答的问题
- 内存控制器为什么读优先,写请求为什么要攒着?
- drain 怎么触发,一次 drain 排空多少、读写切换各花多少?
- drain 在延迟分布上长什么样,怎么观测、能调什么?
一、为什么读优先:两类请求的不对称
读和写在控制器眼里地位天然不平等。读是「有人在等」的请求——某个核的 load 卡在流水线里,整个乱序窗口都可能被它堵住,读延迟直接变成核心停顿;写则基本是「消防通道」——核里的写早就从 store buffer 退休了(store 提交即完成,不等内存),写延迟拉长一两个数量级也没人立刻喊疼。这个不对称决定了调度原则:读优先,写排队。
但写不能无限排队,原因有两个。其一,写队列(write queue)容量有限,典型几十到上百项,塞满之后新的写会反压 L3/互连,最终把「写的债」转成读的 stall。其二,DRAM 的刷新和一致性语义要求写最终落到颗粒,攒太久丢失风险窗口变大(对带掉电保护的控制器这点缓和)。所以控制器给写队列设两个水位:低水位(low watermark)和高水位(high watermark)。队列占用涨过高水位,触发 drain:暂停调度新读,切到写模式,一口气把队列写到低水位以下,再切回读模式。滞后区间(高低水位之间的差)就是滞回设计,防止在读写在边界上高频震荡。
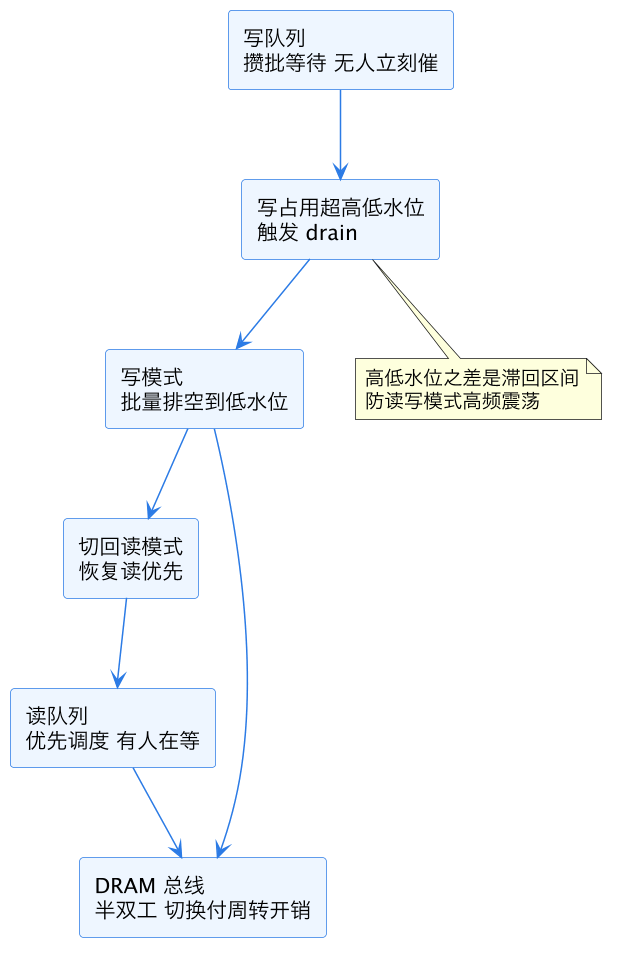
上图的核心是那条「攒批」逻辑:总线切换成本高,所以写必须攒成批才值得切过去——一次切换泄掉几十笔写,周转开销被摊薄到每笔写只剩几纳秒。
二、切换成本的构成与排空粒度
读写方向切换的成本来自 DRAM 协议时序。读转写要付 tWTR(write to read 的对偶,读完成到写命令的最小间隔),写转读要付 tRTW 加上把列选通(CAS)方向反过来的若干周期——量级都是几个到十几个总线周期,折合十几到几十纳秒,不同代际(DDR4/DDR5)数值有别,但「切换比连续同向传输贵一个量级」这个事实稳定不变。DDR5 把通道拆成两个独立子通道后,切换可以按子通道错开,全局停顿感有所缓和,但机制本质没变。
drain 的排空粒度由控制器策略决定,常见参数有三类:触发水位(多满开始排)、目标水位(排到多空收工)、以及最长写模式驻留时间(防止读被饿死)。有些平台允许在读队列完全空了的时候提前做「机会性 drain」——反正总线闲着,顺便泄掉一部分写,降低下一次被迫 drain 时的批量。这个优化对延迟分布尾部帮助明显。
| 参数 | 作用 | 调大/调高的后果 |
|---|---|---|
| 高水位 | drain 触发点 | 触发更晚:读延迟更平稳,但反压风险上升 |
| 低水位 | drain 收工点 | 排得更空:下次 drain 更远,但单次排空更久 |
| 写驻留上限 | 保护读 | 更护读:写吞吐在写密集负载下下降 |
| 机会性 drain | 闲时预泄 | 更平滑:空闲带宽被用来换延迟稳定 |
三、延迟抖动特征与观测
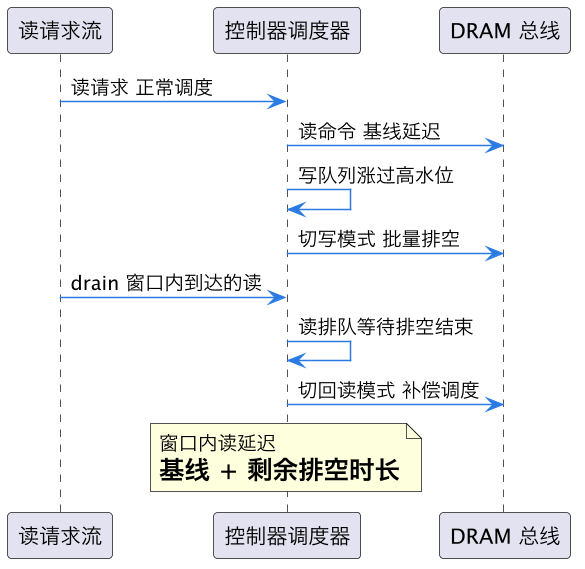
drain 对延迟分布的影响有鲜明指纹:读延迟平时稳定在基线(比如本地 DRAM 约 80-100ns),drain 窗口内到达的读要排队等写排空,延迟跳到基线加「排空时长」(几百纳秒到微秒级,取决于批量)。在延迟直方图上表现为 P99 附近一个小台阶或肩峰;在时间序列上表现为与写强度相关的周期性毛刺——写流量越大,drain 越频繁,毛刺越密。纯读负载(只读缓存、分析扫描)几乎看不到这个模式,写密集负载(日志刷盘前的内存写、大对象分配清零)上台阶明显。
观测路径分三层。硬件层:Intel 的 uncore IMC PMU 有读写命令计数(unc_imc/cas_count_read/、cas_count_write/ 类事件),单位时间写命令占比配合读延迟分布,可以反推 drain 频率;pcm.x(Intel PCM 工具)直接给出每通道读写带宽与延迟读数。系统层:Linux 下 perf stat 挂 uncore 事件需要 root 且事件名随代际变,先用 perf list | grep unc_imc 确认。负载层:用 mlc(Intel Memory Latency Checker)或自写指针追逐程序测纯读基线,再叠加受控写流(另一线程做大块 memset),观察读延迟 P99 随写强度的台阶移动——这是最直接的 drain 效应复现。
四、调优与规避
可调旋钮分三档,按可及性排序。固件/BIOS 档:部分服务器 BIOS 暴露 IMC 调度参数(关键词如「write drain threshold」「MC scheduling」),写密集负载把高水位调低能让 drain 更频繁但单次更短,P99 台阶变矮变密——对延迟敏感优于对吞吐敏感。系统配置档:CXL 或分层内存场景下,把写密集工作集放在本地 DRAM、读密集放远端,避免远端慢速介质的 drain 窗口被拉长(远端 drain 的排空时长按介质延迟等比放大,见 CXL 内存扩展延迟)。应用档:降低瞬时写强度——大块 memset/清零操作用 clwb 加 fence 的节奏化写回(见 clflushopt 与 clwb 持久内存冲刷)、写缓冲分批落地,本质都是把「写洪峰」削平成「写细流」,让机会性 drain 能跟上,避免触发高水位硬排空。
最后一个判断口诀:看到「读延迟 P99 有台阶、台阶密度跟写流量走、平均延迟却正常」这个组合,先怀疑 drain,再用 uncore 写命令计数证实——别先怀疑 TLB 或 NUMA 绑错,那两个的指纹不跟写强度相关。
这一篇在知识体系里的位置
本篇属于 microarch 层「内存子系统」专题的调度细节篇:调度主线见 DRAM 控制器 FRFCFS 调度;颗粒行为见 DRAM 行缓冲命中策略 与 DRAM bank 并行与 rank;组织全景见 DRAM 子系统组织;远端内存的延迟放大效应见 CXL 内存扩展延迟。向上回到 CPU 微架构总览。
总结
DRAM 写排空是读优先调度的配套机制:写请求在写队列攒到高水位才触发 drain,切到写模式批量泄到低水位,用滞回防震荡;总线周转成本决定了「攒批摊薄」的必然性,也给读延迟带来与写强度成正比的 P99 台阶;观测靠 uncore IMC 读写命令计数配延迟直方图,调优按 BIOS 水位、分层放置、削平写洪峰三档入手。