uncore 环网与网格:从 Ring 总线到 Mesh,核间互连为什么被迫换骨架
承 cache-slice-hash-addressing——那一篇讲了 LLC(Last Level Cache,末级缓存)为什么被切成十几个 slice、地址怎么哈希到 slice 上,但留了一个问题没展开:核在芯片西北角,数据落在东南角的 slice 上,中间这段路到底怎么走?走多快?答案就是 uncore 环网与网格——uncore(核外部分,指核芯之外的 LLC、内存控制器、PCIe 控制器等共享部件)的片上互连骨架。Intel 从 Sandy Bridge 到 Skylake-SP 用了三代 Ring 环形总线,Skylake-X 一代突然换成 Mesh 网格。这不是设计口味变了,而是 Ring 在物理上撞了墙。本篇把两代骨架的机制、延迟画像和换型原因讲透。
本文要回答的问题
- uncore 到底管什么?为什么核数一多,共享总线就撑不住,必须上"片上网络"?
- Ring 环网上一个 ring stop(环站)长什么样?请求和响应怎么在环上仲裁、靠什么避免饿死?
- 同一个 LLC,访问"隔壁 slice"和"对角线 slice"的延迟差多少?这个差异在 Ring 和 Mesh 上分别是什么形状?
- Skylake-X 为什么宁可忍受 Mesh 更高的近端延迟也要换掉 Ring?触发换型的定量原因是什么?
- 这些底层差异在性能分析里能不能看到?uncore PMU 事件怎么用?
一、uncore 是什么,为什么核多了就要"片上网络"
先划清地盘。一颗现代服务器 CPU 里,每个核有自己的 L1/L2 缓存,这是"核内(core)"的世界。核外还有一大堆全芯片共享的东西:被切成 N 片的 LLC、两三个内存控制器(MC)、PCIe/UPI 根联合体、时钟电源管理单元。这一片区域统称 uncore。核对 LLC 的一次访问、一次内存读、一次 DMA,本质都是"核 ↔ uncore 部件"的通信,通信的公路网就是本篇的主角。
核少的时候公路很好修。4 核时代,一条共享总线(所有核挂同一组线上,分时使用)就够用——总线带宽一个核独占时富富有余,四个核轮流用也排得上队。但共享总线有两个硬上限:一是电气上限,挂的负载越多走线越长,频率越拉不上去;二是仲裁上限,总线同一时刻只能服务一笔传输,核数翻倍排队延迟就翻倍。到 8 核、12 核,总线变成全员堵车的单车道。
破局思路是把"一根大家抢的总线"换成"一张点对点的网络",让每个节点只和邻居说话。这就是片上网络(NoC,Network-on-Chip)。问题只剩一个:网络拓扑选什么形状。Intel 第一代答案是 Ring 环,第二代答案是 Mesh 网格。uncore 环网与网格的取舍,就是本篇的全部内容。
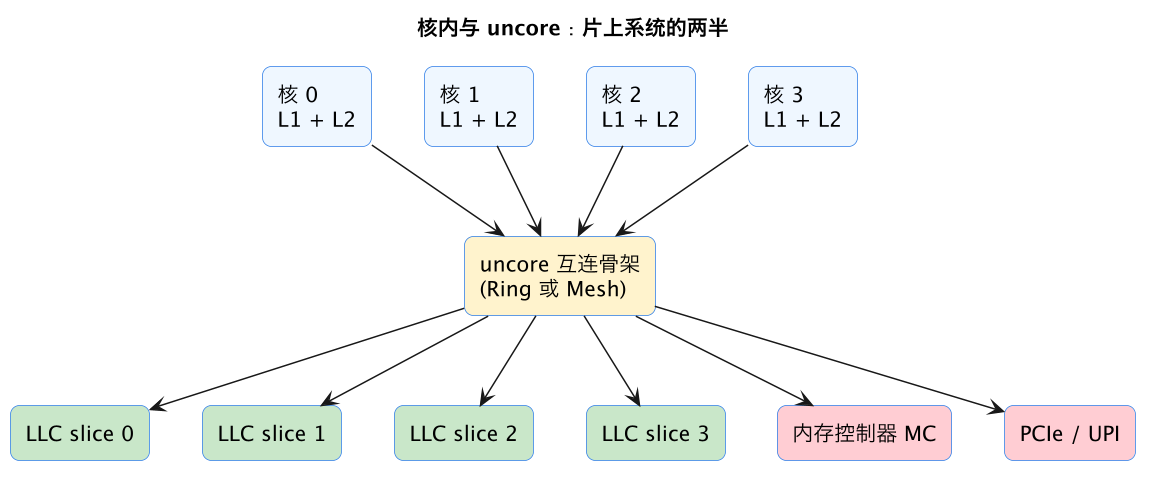
这张图的关键信息是:所有共享资源都吊在互连骨架上,骨架的形状决定每一次 LLC 命中的代价。核对某个 slice 的访问延迟 = 本地 miss 处理 + 骨架上的传输跳数 + slice 排队,其中"传输跳数"这一项完全由拓扑决定。骨架还承载一致性流量——核间 snoop、目录查询,核数越多一致性流量越大,对骨架的带宽要求水涨船高。
二、Ring 总线:ring stop 怎么仲裁
Sandy Bridge(2011)引入的 Ring 思路朴素优雅:把所有节点(核、LLC slice、系统代理)串成一个环,数据像班车一样沿环单向前进,每拍到下一站。每个节点旁设一个 ring stop(环站),职责三件:收下班车(判断是不是给自己的)、让本节点上车(仲裁)、放行过路班车。
实际芯片里通常是两套方向相反的环(顺时针 + 逆时针),让任意两点间取较短方向走;再按流量类型分成多条物理独立的环——请求环、响应环、数据环、snoop 环,各走各的,避免 64 字节缓存行数据把短小的请求包堵在后面。这相当于在同一条环形公路上分了公交车道和小车道。
仲裁是 Ring 的灵魂。ring stop 每拍要做一次裁决:环上正有一班车要经过(在途流量),本站点也有包裹想发(注入请求),谁先用这一拍的"发车窗口"?规则是在途优先——已经在环上跑的数据享有路权,站点只在环上空出窗口(本拍没有在途数据经过)时才允许注入。这个规则天然防死锁:在途数据不会被新注入挡住,永远能继续流向目的地。代价是注入方可能要等,下游站点饿不死,本地包裹可能排长队。
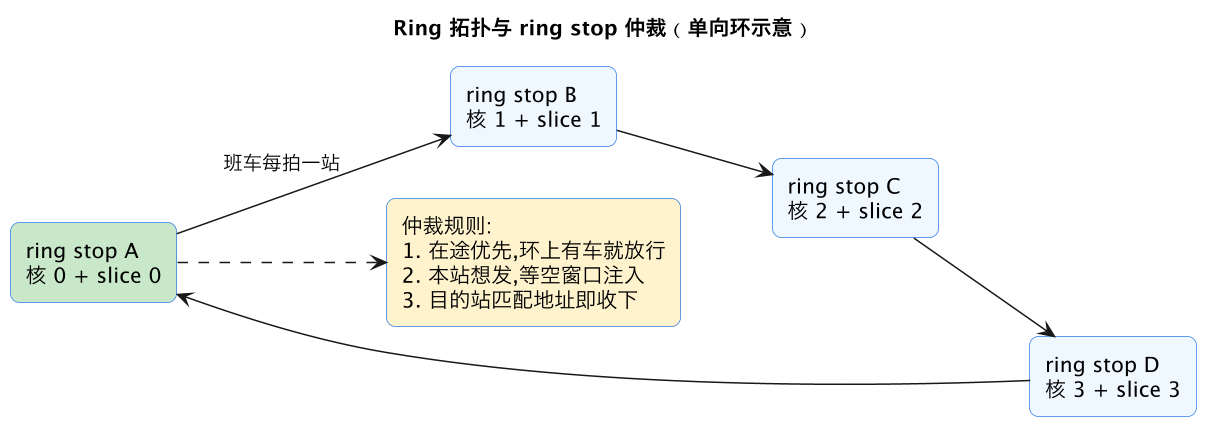
解读这张图:A 的核要读落在 slice 2(挂在 C 站)的缓存行,请求包从 A 出发,经 B 到 C,C 的 ring stop 认出"这是给我的"收下;slice 2 查到数据后把数据环上的响应包发出来,再沿环回到 A。每一跳固定一拍上下(实际略多,ring stop 内部有流水级),延迟与跳数成正比。
这个结构有几个立刻能推出来的性质:
- 就近便宜、就远贵。邻站 1 跳,对角站 N/2 跳,延迟画像是一个三角形:平均跳数约为站数的一半(双向环再减半)。
- 总带宽随站数线性增长。环上不同区段可以同时跑不同的班车,没有全局争抢——这比共享总线强得多,是 Ring 能撑到 12 核以上的本钱。
- 频率与环长成反比。环越长,一站之间的走线和流水级越紧张,uncore 时钟越拉不高;想保频率就得加流水级,单跳延迟又变长。这是 Ring 的第一道裂缝。
三、Ring 撞墙:Skylake-X 为什么换 Mesh
Ring 的账在核数冲到十几、二十几时就怎么算都不平了。三股力量一起把它挤下舞台:
第一股是延迟。双向环的平均跳数 ≈ 站数/4,24 站的环平均 6 跳、最坏 12 跳,每跳 1~2 拍,光骨架传输就要吃掉十几到三十拍——LLC 命中的总延迟被顶到 70 拍以上,而且方差巨大,"这次命中 40 拍、下次命中 90 拍"全看 slice 落在环的哪一段。对延迟敏感的线程(游戏主线程、延迟关键的服务)苦不堪言。
第二股是频率-延迟的跷跷板。核数继续涨,环变长,要么降 uncore 频率(全员变慢),要么加流水级(单跳变更贵)。两头堵死,Ring 的扩展性曲线在 12~16 站附近明显变平——再加站,带宽涨不动,延迟照涨。
第三股是版图。Broadwell-EP 时代的变通是把核分成两列、每列一条环、环间用桥连接——这已经是"Ring 撑不住"的公开招供。桥本身成为新的瓶颈和延迟热点,两条环之间的流量都要挤桥。
Skylake-X / Skylake-SP(2017)的答案是把环拉直、织成网:Mesh 网格。核与 slice 排列成二维阵列,每个节点带一台小路由器,东西南北四个方向连邻居,包按固定规则逐跳转发。片上网路从"一条班车环线"升级成"一座街区路网"。
| 维度 | Ring 环(Sandy~Broadwell) | Mesh 网格(Skylake-SP 起) |
|---|---|---|
| 拓扑 | 一维环,双向 | 二维网格,行列直连 |
| 平均跳数(N 节点) | 约 N/4 | 约 2√N/3,随 √N 增长 |
| 最坏跳数 | 约 N/2 | 2(√N−1),有确定上界 |
| 连线长度 | 环越长单段越长,频率受限 | 每段只连邻居,走线短、易上频率 |
| 聚合带宽 | 随环数/站数线性,但受环长制约 | 随网格边数增长,扩展性好 |
| 近端(1~2 跳)延迟 | 很低 | 略高(路由器流水级更多) |
| 适合核数 | 4~12 站舒服,16 站以上勉强 | 28 核以上仍从容 |
表里最关键的一行是"平均跳数随 √N 增长"——Ring 是随 N 线性涨,Mesh 是随根号涨。节点越多,这个差距越是生死之别。代价也写在表里:Mesh 每台路由器有查路由、过开关的流水级,隔壁 slice 的延迟反而比 Ring 时代略高,近程通信吃了点亏。Skylake-X 早期评测里"同频游戏性能偶尔倒退"的谜团,一半就是 Mesh 近端延迟和默认较低的 uncore 频率造成的。
四、Mesh 内部:XY 路由与确定性
Mesh 路由器怎么决定包往哪走?主流方案是 XY 维序路由(dimension-ordered routing):先沿 X 方向(行)走到目标列,再沿 Y 方向(列)走到目标行,路径唯一确定。维序路由的最大好处是天生无死锁——转弯顺序被限制(只允许"先横后竖"),不可能出现四个包互相等对方让路的环路等待。其次是硬件便宜:每台路由器只需比较自己的坐标和包里的目的坐标,不需要路由表。
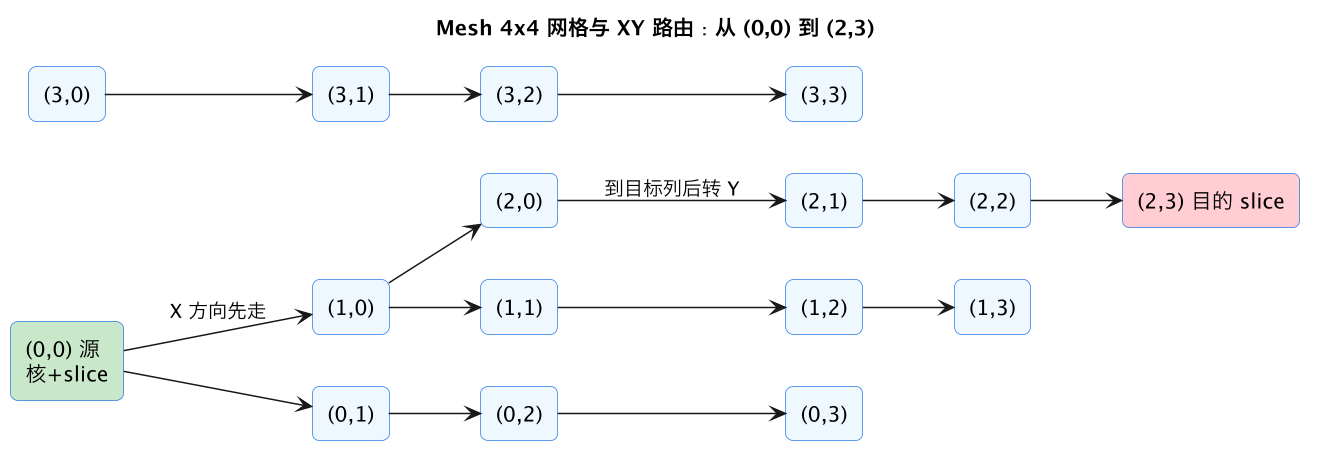
图中加粗的那条路径就是 XY 路由的结果:(0,0) → (1,0) → (2,0) 先把 X 坐标对齐,再 (2,0) → (2,1) → (2,2) → (2,3) 沿 Y 走到底,共 5 跳。其余灰线表示网格里同时可用的其他链路——这是 Mesh 相对 Ring 的带宽本质:不同行、不同列上可以并发跑着许多互不干扰的包,28 核芯片的聚合带宽轻松达到 TB/s 量级,而 Ring 时代想加带宽只能再铺一条新环。
还要注意一个常被忽略的细节:Skylake-SP 把内存控制器挂在网格边缘的固定节点上,而 LLC slice 按地址哈希铺满整个阵列(哈希规则见 cache-slice-hash-addressing)。这意味着任何一次 LLC miss 去内存,都要再跨一次网格到边缘——miss 的远端惩罚比 Ring 时代更明显,这也是 Mesh 芯片内存延迟账面数字偏高的原因之一。
五、LLC slice 访问延迟差异:近端与远端差多少
uncore 环网与网格最实际的后果,是"LLC 命中"不再是一个固定延迟,而是一个分布。同一个核,访问哈希到本节点 slice 的地址和访问对角线 slice 的地址,传输跳数可以差出近 10 跳。把两种拓扑下的延迟画像放在一起对比:
| 场景 | Ring(12 站双向) | Mesh(6x5 阵列) |
|---|---|---|
| 本地 slice(0~1 跳) | 约 30~40 拍(含 slice 流水) | 约 33~45 拍,略高 |
| 平均随机 slice | 约 45~60 拍 | 约 50~70 拍 |
| 最远 slice | 约 70~90 拍(6 跳上限) | 约 75~100 拍(9 跳上限) |
| 延迟方差 | 中等(一维距离决定) | 大(二维距离决定) |
数字是公开实测(芯片级 pin 追踪与逆向测量)的典型量级,不必纠结个位数——要点在形状:LLC 延迟有 2 倍上下的散布,而且程序员无法通过数据布局控制它,因为地址到 slice 的哈希是故意打散的(为了防冲突和偏斜,动机详见 cache-slice-hash-addressing)。这带来两条推论。
推论一:单线程看,LLC 延迟是个统计量。优化到"LLC 命中为主"的代码,其 IPC 会被骨架平均跳数悄悄设上限;跨代对比时,Ring 时代的 LLC 延迟经验值不能照搬到 Mesh 芯片,反之亦然。
推论二:多插槽系统里还有第二级跳变。片内 Mesh 之上是 UPI 链路连到另一颗 CPU,访问对端插槽的 LLC/内存再多一层"NUMA 跳",延迟再加 50%~100%。延迟阶梯因此是:本地 L1/L2 → 片内近端 slice → 片内远端 slice → 本地内存 → 远端插槽内存。后两级的差距大头就来自互连骨架与插槽间链路。
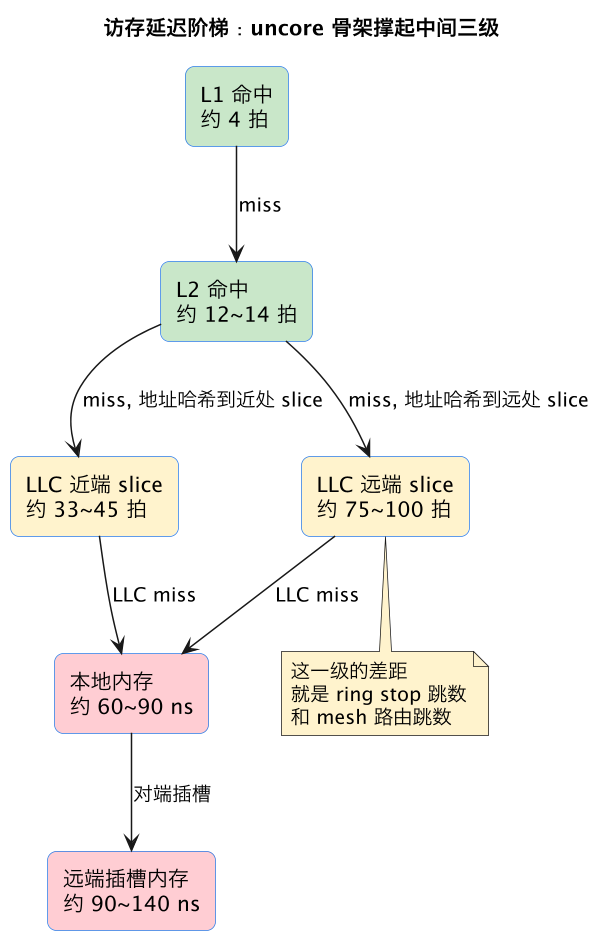
这张阶梯图是全篇的落脚:uncore 环网与网格不是抽象的网络课内容,它直接决定了阶梯中间两级的高度和散布。理解它,才能解释为什么同一颗芯片上 LLC 延迟测量值总在抖、为什么绑核(减少跨插槽流量)对延迟敏感应用立竿见影。
六、观测:uncore PMU 看见骨架的忙闲
这些机制不只能推理,还能测量。Intel 把性能计数器分两套:核内 PMU 和 uncore PMU——后者分布在各个 uncore 部件里(每个 LLC slice 的 C-Box、内存控制器的 MC-Box、UPI 链路的 UPI-Box),在 perf list 里以 uncore_ 前缀出现:
# 看有哪些 uncore 事件
perf list | grep uncore

# 统计各 slice 的 LLC 查找与命中(按 C-Box 聚合)
perf stat -a -e uncore_cbox_0/clockticks/,\
uncore_imc/cas_count_read/,uncore_imc/cas_count_write/ ./app

# 粗看 LLC 命中率与内存读写量之比,
# 命中率低且内存读写大 → 骨架和 MC 都在高压下
两个实战提示。其一,uncore 事件按部件实例分开计数(cbox_0、cbox_1……每个 slice 一个),想看全片要聚合所有实例,或先用 -a 系统级抓总量。其二,uncore 频率本身是个变量:Mesh 芯片的 uncore 频率独立于核频动态调节(BIOS 里常叫 uncore frequency 或 mesh frequency),负载低时降频省电,此时测量到的 LLC/内存延迟会系统性偏高。做延迟对比实验时把 uncore 频率钉在最大值(BIOS 或 intel_uncore_freq 接口),否则你测到的"代际差异"里可能掺着一半的频率差异。功耗门控与频率策略的背景见 microarch-clock-power-gating,Mesh 频率与 IPC 分析的交叉影响见 ipc-bottlenecks。
这一篇在知识体系里的位置
本篇是微架构"缓存与互连"线上讲片上网络骨架的专题,与姊妹文互补:
- cache-slice-hash-addressing:LLC 为什么切 slice、地址怎么哈希打散——它回答"数据落在哪个站",本篇回答"怎么走到那个站、走多快"。
- cache-inclusiveness-l2-l3:L2/L3 的包含关系,Skylake-X 换 Mesh 的同代还把 LLC 改成非包含,两件事一起重塑了该代的缓存延迟画像。
- coherence-directory-vs-snoop:一致性协议跑在骨架之上的流量形态,Mesh 时代目录流量占比显著上升。
- mshr-miss-status-register:核内容忍 LLC 延迟抖动的并发机制——骨架延迟越高、方差越大,MSHR 越容易被打满。
- cache-replacement-policies-lru:slice 内部的替换策略,与本篇的"slice 之间怎么走"正交。
- 上游框架:cpu-microarch-overview;下游分析:ipc-bottlenecks、microarch-clock-power-gating。
总结
uncore 环网与网格是多核 CPU 共享资源的两代公路网:Ring 用 ring stop"在途优先、空窗注入"的仲裁把延迟和跳数绑成线性关系,十几站后频率、延迟、版图三面撞墙;Skylake-X 换成的 Mesh 用 XY 维序路由把跳数压到随 √N 增长、带宽随网格边数扩张,代价是近端 slice 延迟略升——LLC 命中从此不是一个固定延迟,而是一个由骨架拓扑决定形状的分布,做延迟测量和绑核优化时,这个分布就是你必须先看懂的那张地图。