窥探命中延迟:缓存一致性里 hit / hitm 的周期账单与测量方法
承 coherence-directory-vs-snoop 对两类一致性协议的比较,以及 snoop-filter-coherence-probe 对窥探过滤器的介绍。当一个核 load 的 cache line 其实在别的核的缓存里时,这算不算「命中」?数据确实不用去内存,但拿到的路径上有窥探、有状态协商、可能还有脏数据回写——这条路的延迟就叫窥探命中延迟(snoop hit latency)。它比本地 LLC 命中贵,比内存便宜,是伪共享、锁竞争问题的「疼痛刻度尺」。
本文要回答的问题
- snoop hit 与 snoop hitm 有什么区别?为什么 hitm 贵一截?
- 一次窥探命中的延迟由哪几段构成?典型多少周期?
- snoop filter 和目录是怎么缩短这条路径的?
- 怎么用 PMU 事件把「我的程序有多少流量走了 snoop 转发」量出来?
- 对编程实践有什么直接结论?
一、hit 还是 hitm:状态决定价格
MESI 家族协议下(背景见 cache-mesi-moesif-protocols),核 0 的 load 在本地未命中、向一致性层请求 line X 时,line 在核 1 手里有两种常见情形。
Snoop hit(干净命中):核 1 持有 line X 的 S 态(Shared,只读副本)。核 1 的缓存应答「我有,干净的」,数据可以从核 1 的缓存转发,也可能由 LLC/内存直接供给(取决于实现),核 0 拿到 S 态副本。因为没有脏数据,不需要回写,这条路相对便宜。
Snoop hitm(脏命中,hit modified):核 1 持有 M 态(Modified,已修改未回写)。line 里的最新值只存在于核 1 的 L1/L2 里,内存和 LLC 里的都是旧值。这时必须:核 1 响应窥探 → 把脏 line 数据转发给请求方,同时(视实现)回写到 LLC/内存或转为 O 态(MOESI 的 Owned,允许脏共享)。数据路径更长、还多一次缓存层级的事务,hitm 的延迟通常是 hit 的 1.3-2 倍。
还要提一句 F 态(MIF?即 MOESIF 里的 Forward):部分实现指定一个「转发责任方」,同一条 line 被多个核共享时只有它负责供给数据,避免多个 S 态持有者抢着应答浪费互连带宽。
二、延迟构成:一段一段数
以现代服务器(mesh 互连 + 目录 + snoop filter)上一次典型 hitm 为例,路径大致是:
- 核 0 L1/L2 miss,请求发到 home 节点(由地址 hash 决定,见 cache-slice-hash-addressing)——mesh 跳数 1-N 跳,每跳 1-3 周期;
- home 的目录查到「line 在核 1 M 态」,snoop filter 确认目标只有核 1,发定向窥探——又一程 mesh;
- 核 1 收到窥探,查 L1/L2 标签,命中的话可能要先处理与在飞访存的冲突(同一个 line 正被本核 store buffer/未决 load 使用),然后读出数据、修改本地状态;
- 数据从核 1 的缓存经 mesh 送回 home 或直接回核 0——第三程 mesh;
- 核 0 填 L1/L2,load 完成。
典型数字:同 socket 内 hit 约 60-90 周期,hitm 约 75-110 周期;跨 socket 走 UPI 再翻 2-3 倍。对照基准:本地 LLC 命中约 30-50 周期,本地 DRAM 约 150-250 周期。所以「数据在别的核缓存里」恰好落在「比 LLC 贵、比内存便宜」的中间带——伪共享为什么疼但不至于死,就是这个位置决定的。
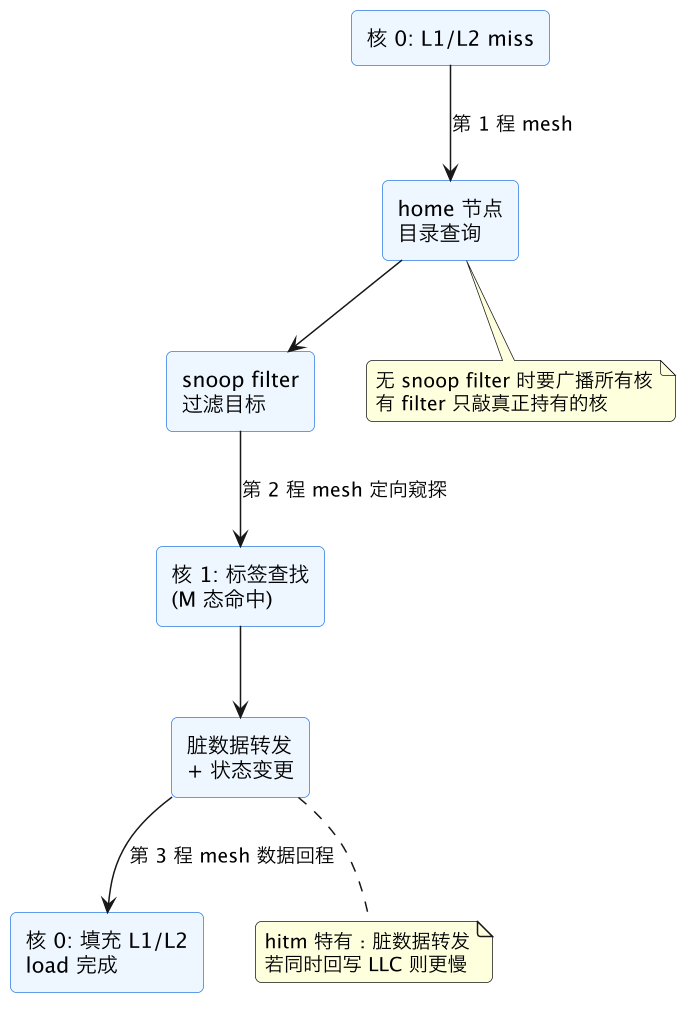
图上三程 mesh 是延迟大头——这就是为什么「目录放在哪个 slice」「两个核物理距离多远」会直接影响一致性延迟,也是 uncore-ring-mesh-interconnect 讨论的 mesh 跳数在真实负载里的体现。
三、snoop filter:少敲门就是省延迟
早期 snoop 协议是广播:一次请求把窥探发给所有核,每个核都要查一遍自己的标签阵列。两个问题:互连带宽被窥探流量吃掉,每个核的标签端口被窥探访问抢占(和本核自己的 load/store 抢端口)。snoop filter(详见 snoop-filter-coherence-probe)是一张「谁手里有什么 line」的摘要表,home 节点先查它,只向真正持有的核发定向窥探。
对延迟的影响是双重的:直接效果是少走无谓的往返(不持有的核不再被打扰);间接效果是标签端口竞争减少,被窥探核的应答更快。snoop filter 自身也不是免费的——它容量有限,line 被逐出 filter 时会触发反向失效(back-invalidation),强制对应核丢掉干净的副本,这会在高共享工作集负载下制造额外的 miss 流量。AMD 的 Probe Filter、Intel 的 CHA 内 SF 都是同一思路的不同实现。
四、用 PMU 把一致性延迟量出来
想知道你的程序有多少 load 走了 snoop 转发,核内 PMU 有直接对应的事件族(Intel 为例):
MEM_LOAD_L3_HIT_RETIRED.XSNP_HIT/XSNP_HITM/XSNP_MISS:退休 load 里跨核窥探 hit / hitm / 无窥探直接去内存的计数;OCR.DEMAND_DATA_RD.L3_HIT.SNOOP_HITM:offcore 请求口径的 hitm 计数。
一个实用的比值:hitm / (hit + hitm + miss)。健康的数据并行程序这个值通常不到 5%;锁竞争、伪共享严重的程序能干到 30% 以上。配合 perf c2c(专门做缓存行级竞争分析的工具,perf c2c record + perf c2c report 直接列出 HITM 最多的 cache line 与代码位置),可以把「哪个变量在核间乒乓」精确定位到源码行——伪共享排查的标准流程,案例见 mesi-false-sharing 与 atomic-lock-cacheline-impl。
| 情形 | 典型延迟(同 socket) | 触发场景 |
|---|---|---|
| 本地 L1/L2 命中 | 4-15 周期 | 正常私有数据 |
| 本地 LLC 命中 | 30-50 周期 | 共享只读数据 |
| snoop hit(S 态转发) | 60-90 周期 | 只读共享、目录未标记本地 |
| snoop hitm(脏转发) | 75-110 周期 | 伪共享、锁、生产者-消费者 |
| 本地 DRAM | 150-250 周期 | 真冷数据 |
| 跨 socket hitm | 200-400+ 周期 | NUMA 错配 + 竞争 |
五、一个可复现的 hitm 延迟测量实验
想亲手量出 hitm 与 hit 的差值,经典做法是乒乓测试(ping-pong benchmark):两个线程绑到同 socket 的两个核,共享一个按 64 字节对齐的变量,用 lock cmpxchg 或普通 store/load 交替读写同一个变量 N 次,总耗时除以 N/2 就是单次「核间倒手」的延迟。
// 伪代码:line 在核 A、核 B 之间往返
// 每次写都让 line 变 M 态,对方下一次读必然 hitm
while (n--) {
    while (atomic_load(&flag) != my_turn);   // 读到的是对方写的脏 line
    atomic_store(&flag, other_turn);          // 写,line 转入本核 M 态
}
实测同 socket 单次往返 70-110 周期(hitm 主导);把两线程改绑到不同 socket,数字跳到 250-400 周期——这就是跨 socket hitm 的真实身价。做两个对照组更有意思:把共享变量改成只读(两边都只 load,line 双 S 态),延迟立刻回落到接近 LLC 命中的水平,因为不再触发脏转发;把变量改成各自私有、但放在同一条 line 里,延迟又回到 hitm 水平——这就是教科书级别的伪共享复现,一行实验把「hitm 的根源是跨核写同一 line」讲得明明白白。
读数时注意两点:一是循环里别掺进分支预测失败(控制循环足够热),二是 TSC 读取用 rdtsc-invariant-tsc-sync 里讲的夹取法,避免把计时误差算进一致性延迟。
六、对编程的直接结论
第一,写后共享是最贵的共享:hitm 比 hit 贵、比冷内存便宜,真正疼的是「高频」——每秒百万次的 hitm 等价于把十几个核的 IPC 拖下水。第二,减少 hitm 的唯一正道是减少同 line 的跨核写:per-core 计数器、padding 隔离、批量交接代替逐元素握手。第三,共享只读数据尽量让它在 LLC 安家:只读副本多核共存不触发 hitm,但如果工作集大于 LLC 导致频繁换入换出,S 态副本反而可能退化出「伪 hitm」式的转发流量——大只读表也要考虑复制到每 NUMA 一份。
第四,把 hitm 比值纳入性能回归基线。新功能上线前跑一次标准压测,记下 XSNP_HITM 占总 offcore 流量的比例;这个比值和 QPS、P99 延迟一样值得进看板——很多「代码没动、机器没变、就是变慢了」的事故,最后都是某个共享结构悄悄引入了跨核写。
这一篇在知识体系里的位置
协议背景见 cache-mesi-moesif-protocols 与 coherence-directory-vs-snoop;窥探加速器见 snoop-filter-coherence-probe;应用层面的伪共享与原子竞争见 mesi-false-sharing 与 atomic-lock-cacheline-impl;跨 socket 延迟背景见 numa-local-remote-latency。
总结
窥探命中延迟是「数据在别的核缓存里」的取数代价:hit 约 60-90 周期、hitm 因脏数据转发再贵一截,夹在 LLC 命中与内存访问之间;snoop filter 靠少敲门压低它,而程序员能做的就是减少跨核写共享——用 perf c2c 把 HITM 热点揪出来,疼的位置一目了然。