访存依赖预测:load 敢不敢插队,违例冲刷值不值
在乱序核里,ALU 指令的依赖靠物理寄存器编号一拍就能查完(见 RAW 篇),但访存指令没这么幸运——load 与前面 store 是否冲突,取决于两边地址都算出来才知道。等,就白白阻塞一大片独立 load;不等,就可能读旧数据。访存依赖预测(memory dependence prediction)就是硬件在这个两难上做的赌博:猜不冲突,先把 load 发射出去,回头再验证。本篇承接 LSU 篇 与 访存 RAW 篇,专门解剖这个"预测—验证—违例冲刷"的闭环。
本文要回答的问题
- 为什么乱序核不能简单地"load 等前面所有 store 地址算完再发射"?
- 访存依赖预测器长什么样,它按什么记住"哪些 load 曾经赌输过"?
- 赌赢了省什么、赌输了赔什么?违例冲刷的代价如何量化?
- 工程上怎么观测 store-load 违例、什么样的代码模式容易踩雷?
一、问题的本质:地址是依赖判定的唯一依据,而地址来得很晚
寄存器域的依赖判定是"静态"的:µop 进保留站时源/目的物理寄存器号已经确定,tag 比较器一比对就完事。访存域完全不同:
store [rax + 8], rcx     ; 地址 = rax + 8,rax 可能刚被 load 读进来
load  rdx, [rbx]         ; 地址 = rbx,和上面冲不冲突?现在没人知道
store 的地址操作数 rax 可能依赖一条还在缓存层次里跋涉的 load,地址算出来可能是几十拍之后的事。如果硬件采取保守策略——任何 load 都必须等前面所有 store 的地址就绪并比对完才能发射——后果是灾难性的:
- 大多数 store 与大多数 load 根本不相干(实测程序中 store-load 真正同地址冲突的比例通常低于 5%);
- 等地址 = 把 store 上游的整条依赖链延迟强加给所有后续 load,乱序窗口里本该并行发射的访存流量被串行化;
- L1 命中 4~5 拍的 load 延迟无法与别的指令重叠,IPC 明显下跌。
另一个极端是激进策略——load 永远不等,直接发射。这会撞上真冲突:load 读到的是 store 落位之前的旧数据,程序语义直接错掉。这在单核上也是错误,不能容忍。
于是所有现代高性能核都落在中间:预测。默认赌不冲突,load 照常提前发射;同时保留一套验证机制,发现赌错了就冲刷重来。这就是访存依赖预测存在的理由——它把"99% 无冲突"的统计事实变成性能,把"1% 有冲突"的正确性负担留给违例检测兜底。
二、预测器:赌不冲突,并记住赌输的历史
访存依赖预测(Intel 文档里叫 memory disambiguation)的硬件大致由三部分配合:
| 部件 | 职责 | 关键动作 |
|---|---|---|
| Load Buffer | 已发射 load 的档案 | 记录 load 的地址、年龄、是否已读数据 |
| Store Buffer | 未退休 store 的档案 | 地址就绪后与所有更年轻 load 比对;数据就绪后支持 forwarding |
| 依赖预测器 | 决定 load 是否要等 | 按 load 的 PC 查历史,命中"曾经违例"条目就强制该 load 等待相关 store |
新进来的 load 在调度时先问预测器:"以我的 PC 看,历史上我跟前面的 store 冲突过吗?" 没冲突记录——直接发射,和前面 store 并行推进。有冲突记录——预测器让它等到"嫌疑 store"的地址就绪(更精细的实现记住具体是哪个 store,用 store 序号做精确配对,避免等所有 store)。
验证发生在 store 地址算出来的那一刻:store 地址与 Load Buffer 里所有比它年轻、且已经发射读数的 load 逐一比对。命中即违例——那个 load 当年赌输,读到的是旧数据,它以及它后面所有 µop 都必须作废。这套"事后发现"的机制保证了正确性不依赖预测准不准:预测只是性能优化,验证才是正确性底线。
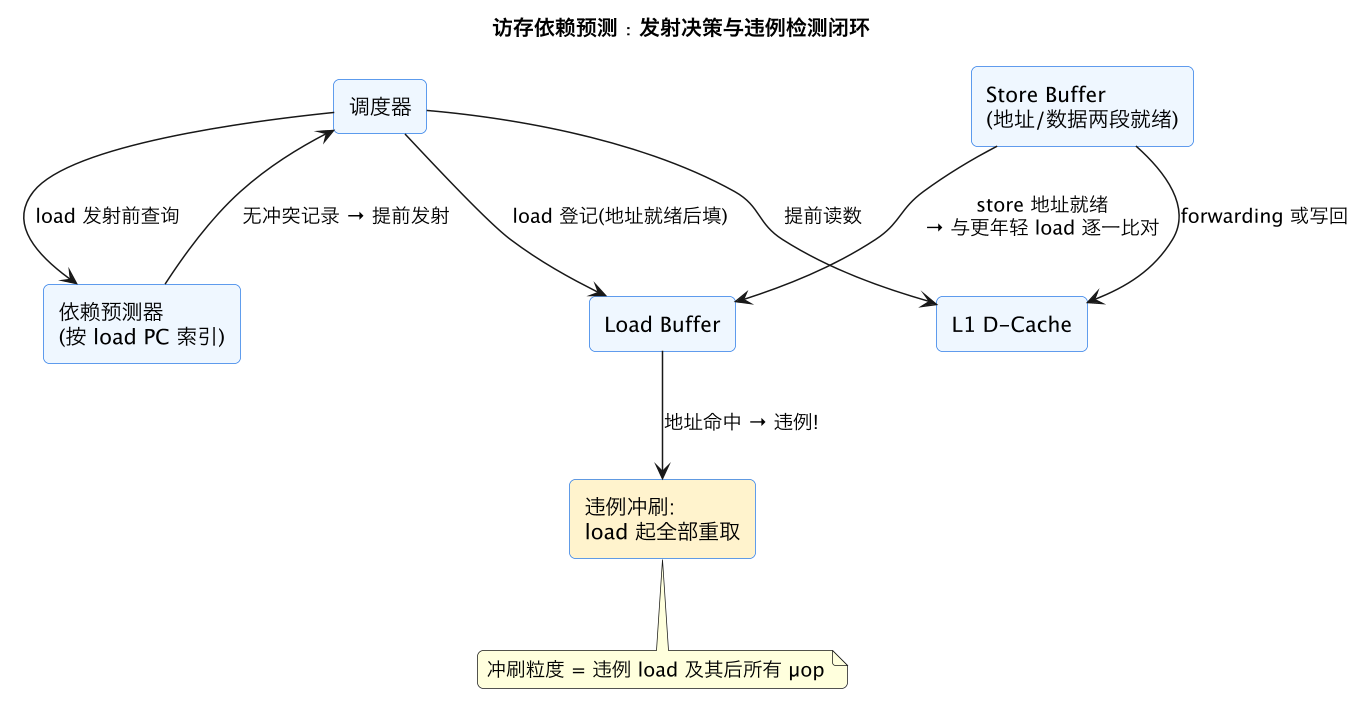
上图的核心是两条箭头方向相反的路径:预测路径(左侧,调度前查询,决定 load 敢不敢走)和验证路径(右侧,store 地址就绪后反向审计 Load Buffer)。预测器只在第一条路径上起加速作用;第二条路径无论预测器说什么都会跑,这是"赌错了也能兜住"的原因。
三、赌赢与赌输的账本
赌赢的收益很直接:load 与无关 store 并行推进,访存延迟被乱序窗口吸收,IPC 维持高位。赌输的代价则是流水线冲刷:从违例 load 开始重新取指,期间已经投机执行的几百条 µop 全部作废。
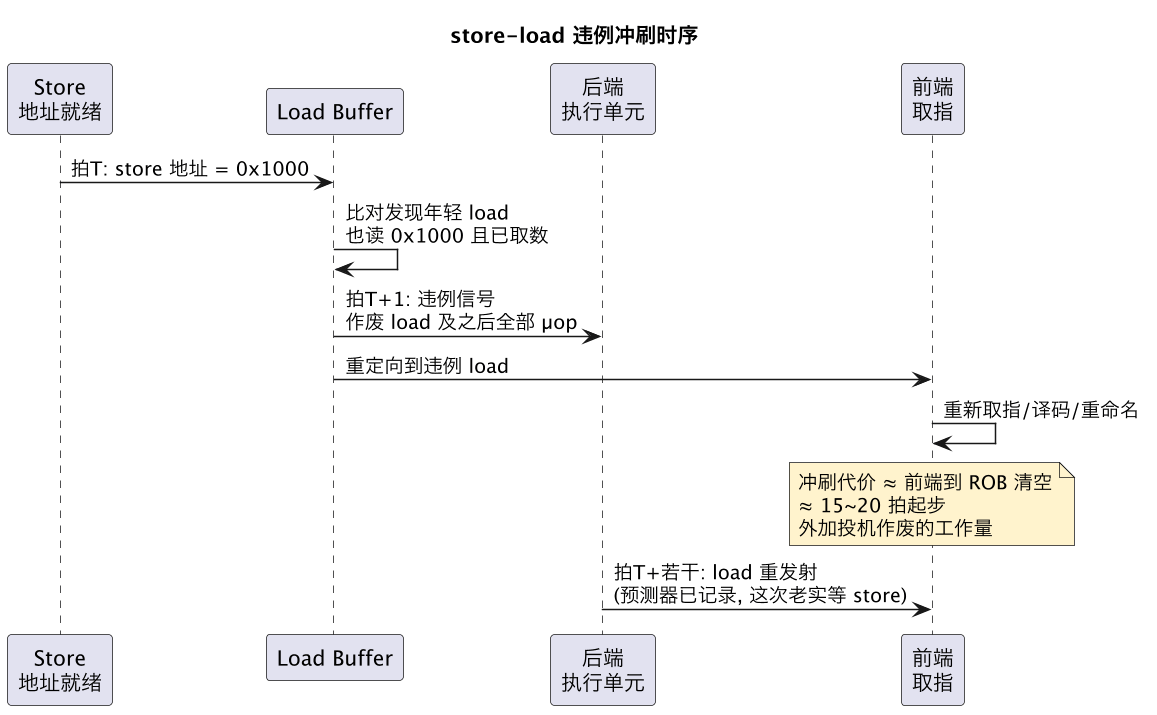
一次违例冲刷的直接代价约 15~20 拍(前端流水线深度 + ROB 排空),间接代价是作废 µop 占用的发射带宽。更要命的是连锁反应:违例 load 的下游消费者可能已把错误数据传播给了更多 µop,全部作废;而重新执行时预测器已将该 load 标为"需等待",这次的等待本身也是开销。粗略的量化口径:
- 冲刷一次 ≈ 损失 20~40 拍的有效执行时间;
- 因此预测器的"盈亏平衡点"大约是:违例率必须压在 2~5% 以下,提前发射才有净收益——这正是各家核把违例率当作关键微架构指标的原因;
- 与分支预测对比:分支预测错一次也是冲刷,量级相当,两者共享"冲刷管线",所以分支误预测率与 load 违例率高的代码,惩罚是叠加的。
四、工程观测与代码避坑
Linux 下观测这类事件主要看 perf 的厂商事件。Intel 上是 ld_blocks.no_sr(load 因未知 store 地址被阻塞)与 machine_clears.memory_ordering(访存次序违例冲刷);软件层面经验法则是:
| 代码模式 | 风险 | 说明 |
|---|---|---|
指针别名不明的写后读(如 *p = f(*q)) | 高 | 编译器与硬件都无法静态排除 p==q |
| 结构体拆分字段、紧邻写读 | 中 | 不同字段同 cache line,预测器容易误判 |
| 4K 别名(地址低 12 位相同的伪冲突) | 中 | 部分核用地址低位做快速比对,低位相同即报冲突 |
| 完全独立的数组流(如 memcpy 源/目的不重叠) | 低 | 预测器历史干净,load 畅行 |
避坑动作也就对应三条:热点路径上减少"写后立刻读同一片内存"的模式;跨 4K 边界布局频繁互访的缓冲区;以及用 perf 在疑似热点上确认 machine_clears.memory_ordering 是否真的非零——别凭猜去重构代码。
这一篇在知识体系里的位置
本篇是乱序执行专题里"访存侧预测"的一角。前置:LSU 篇 给出 Load/Store Buffer 的结构与 forwarding;访存 RAW 篇 讲清 store→load 真依赖的正规解法;乱序执行总览 提供 ROB 与投机执行的框架。平行对照是分支预测(同样"先猜后冲刷");下游延伸是 IPC 瓶颈篇 中把违例冲刷计入后端停顿的分析。
总结
访存依赖预测是乱序核对"store 地址来得太晚"的赌博式解法:默认放 load 先行,用 Load Buffer 档案 + store 地址就绪时的反向比对兜底正确性;赌赢吸收访存延迟,赌输一次付出 15~20 拍起步的流水线冲刷,因此违例率压在个位数百分比才有净收益——工程上靠 perf 的 memory ordering 事件观测,靠消除指针别名与 4K 别名避坑。