预取反馈节流:准确率与污染度如何反向调节预取器的胃口
更新时间:2026-10-06。本篇是预取系列的零件文。站内相关阅读:硬件预取器之步长与流 讲主流预取器的检测原理,预取准确率与覆盖率指标 定义了评估预取器的两把尺子,MSHR 未命中状态寄存器 讲未命中在飞的承载上限,内存级并行 MLP 讲预取要服务的根本目标。本篇回答一个承上启下的问题:预取器凭什么知道什么时候该闭嘴?
本文要回答的问题
- 预取器为什么会帮倒忙,「污染」和「抢占」各指什么?
- 准确率、覆盖率、污染度三类反馈信号怎么度量、怎么进入决策?
- 动态节流有哪些档位语义,激进与保守之间怎么切换?
- MSHR 占用和内存带宽压力是怎么反馈给预取器的?
- 为什么独占机器上的正资产预取器,混部后会变成负资产?
- 怎么用 perf 判断当前负载下预取器是正资产还是负资产?
- 应用侧有什么办法「帮」预取器保持高置信度?
一、预取器的双面性:免费的午餐也可能吃坏肚子
硬件预取器的本职工作是把「等 miss 了再去拿」改成「猜你要、提前拿」,把内存延迟从关键路径上抹掉。检测逻辑(步长、流、空间 footprint)在 硬件预取器之步长与流 里讲过,不再重复。要强调的是它的另一面:每一个预取请求都消耗真实资源——占一个 MSHR 项、消耗一次缓存标签查询、走一遍下级缓存或内存控制器、拿到数据后还要占用一个缓存行把原来的住户挤走。预取命中时这些开销被「省下的等待」百倍偿还;预取落空时,这些开销是纯亏。
纯亏有三种形态。一是准确率亏损:预取来的行永远没人用,白白消耗带宽和功耗。二是污染亏损:无用的预取行把有用的行踢出缓存,反而制造新的 miss——这在工作集贴近缓存容量时最致命。三是抢占亏损:预取请求和真实 demand miss 在 MSHR、fill buffer、内存控制器队列里排队抢资源,demand miss 被堵在后面,关键路径延迟不降反升。MSHR 未命中状态寄存器 讲的「在飞容量打满就全停摆」正是抢占亏损的放大器:预取把 MSHR 塞满,真正的 load miss 连门都进不来。
给一个量级感。一次 L2 预取的直接成本大约是:占用 MSHR 一项约 20-40 拍(L3 命中)到 200+ 拍(走内存)、消耗 L3/内存读带宽 64 字节、替换掉一个 L2 行。如果这一发命中在刀刃上,省下的 demand 停顿是同等量级甚至更多;落空则这些全部打水漂,还外加污染的机会成本。当负载的预取准确率从 90% 滑到 50%,每发一条预取的期望收益就从「大概率净赚」变成「盈亏对半」,再往下就是稳定亏损——这就是反馈节流存在的经济理由。
正因为有这三种亏法,商用预取器从来不是「检测到模式就猛发」,而是带一套反馈节流(feedback throttling)机制:持续评估自己最近干得怎么样,干得好就放开胃口,干得差就收敛甚至自我关闭。这套反馈环路是预取器从「学术论文」变成「量产芯片」的关键工程。
二、三类反馈信号:节流器的仪表盘
反馈节流的第一步是可度量。预取器内部维护的统计信号可归为三类,与 预取准确率与覆盖率指标 的两把尺子对应并扩充:
| 信号 | 定义 | 怎么统计 | 恶化时意味着 |
|---|---|---|---|
| 准确率(accuracy) | 被用到的预取行 / 发出的预取总数 | 预取行打标记,被 demand 访问时置「有用」位,替换时结算 | 检测逻辑在乱猜 |
| 覆盖率(coverage) | 被预取救下的 miss / 原本会发生的 miss | 对比「有预取」与「假想无预取」的 miss 数 | 预取太保守 |
| 污染度(pollution) | 因预取而提前被逐的有用行 | 被逐行带「近期被访问」标记的比例 | 预取在挤走正主 |
硬件实现上这些统计都很廉价:给缓存行加一两个状态位(「我是预取来的」「我后来被用过」),在替换路径上顺手结算;再加几个饱和计数器按时间窗累计。学术界的经典方案(如 SPP 的 perceptron 打分、Bingo 的空间足迹置信度)和商用实现(Intel 的 L2 streamer 动态档位、ARM 的 prefetch tune 寄存器)形态各异,但输入信号都是这三类的某种组合。
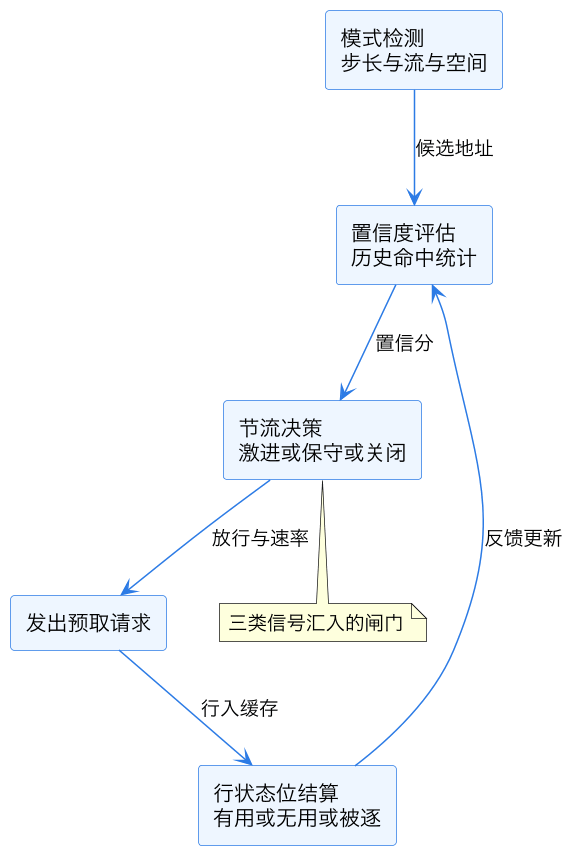
上图是反馈环路的骨架:检测产生候选,置信度打分,节流闸门决定放行速率和激进度,行入缓存后的生命周期结算成统计信号,再回头修正打分。环路里最关键的元件是中间的「节流决策」——它是唯一能把「预取器自身状态」和「系统全局压力」两类信息合在一起的地方。
把这条回路按「信号流向决策」的顺序再捋成一张漏斗卡,从观测一路收敛到收口动作:
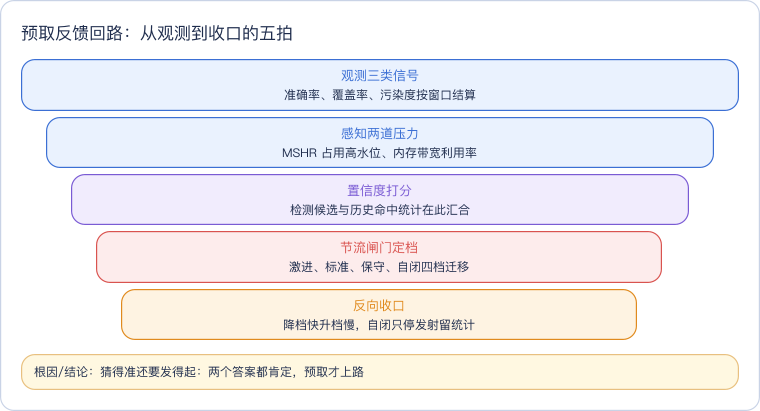
这张漏斗卡强调的收敛方向:五拍里前四拍都是「信息变少、判断变硬」的过程——三类统计加两类压力,最后只压成「放行还是收紧」一个比特级的闸门动作;而末拍的「降快升慢」非对称策略,是整套回路宁可少赚不可多亏的性格。
三、节流档位:从全速到自闭的连续谱
节流不是开/关两态,而是一个连续谱,商用实现里通常呈现为几档语义:
- 激进档:高置信候选全部发出,预取距离(prefetch distance)拉远,一次触发可发多条。适用于准确率高、系统空闲的场景。
- 标准档:只发高置信候选,预取距离居中,触发频率受限。大多数时间的默认状态。
- 保守档:压低预取距离、每次只发一条、跳过置信度中等的候选。准确率下滑或带宽吃紧时降入。
- 自闭档:整个流或整个预取器暂停检测与发射,只留统计继续跑;连续若干窗口准确率低于阈值时进入,等模式稳定再复活。
档位的切换依据不止准确率。**预取 timeliness(及时性)**是第二个维度:预取发得太晚(demand 都到了预取还没到,变成「半命中」走 fill buffer 转发,见 Line Fill Buffer)说明距离太近,该拉远;发得太早(行到了之后长期没人用,甚至被替换掉才被访问)说明距离太远或预测太乐观,该收。及时性的反馈让节流器能在「发多少」之外再调「发多远」。
预取距离的调整还有一个硬约束:它能拉多远,取决于访问流的「节奏」。一个每 40 拍消费一行的流,把距离设到 8 行意味着提前 320 拍发出请求——这在空载机器上足以掩盖内存延迟,但在带宽竞争下 320 拍前的世界和现在是两个世界,早早取回的行可能白白占位等到被逐。所以距离调整本质上是「预测未来的置信度随时间衰减」的折扣问题,节流器把及时性统计当成这个折扣率的实测估计。
第三个维度是系统压力信号:MSHR 占用率超过高水位、下级缓存端口排队变长、内存控制器读队列积压(调度策略见 DRAM 控制器 FR-FCFS 调度),都说明「再发预取就是给 demand miss 添堵」。此时即使准确率很高,节流器也应降档——准确率回答「猜得准不准」,压力信号回答「现在发不发得起」,两个问题的答案都必须是肯定的,预取才该上路。
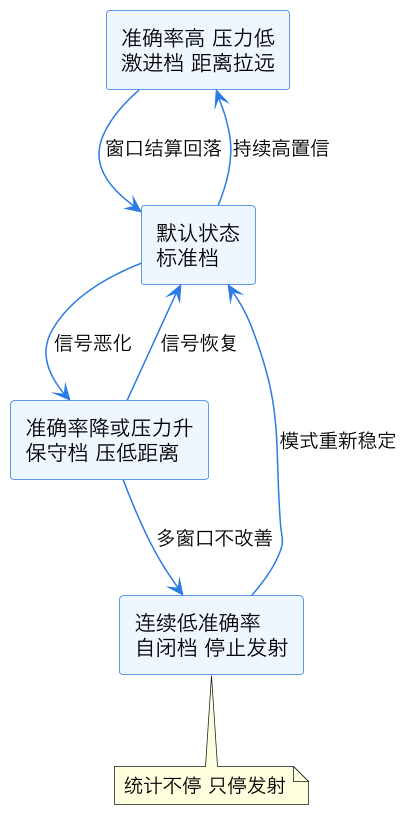
上图是档位迁移的状态图。注意两个设计细节:降档比升档「快」(一个坏窗口就降,多个好窗口才升),这是典型的「宁可少赚、不可多亏」的非对称策略;自闭档保留统计,是为了让复活决策有依据,避免完全盲启动。
四、MSHR 与带宽:压力信号从哪里来
压力反馈的物理来源值得单独拆开看,因为它解释了为什么「预取器表现」会因机器、因混部邻居而剧烈波动。
MSHR 是第一道闸门。每个 L1/L2 的 MSHR 项数固定(十到几十项),demand miss 和预取 miss 共用这个池子。池子一旦占满,后续任何 miss 都阻塞——包括最不该被阻塞的关键路径 load。实现上的常见保护是给 MSHR 加预取配额:预取最多占用池子的某个比例(比如 3/4),永远给 demand 留座。配额本身就是节流的一部分,而且是硬节流——不依赖统计,物理隔离。
带宽是第二道闸门,也是更宏观的那道。预取消耗的内存带宽和 demand 完全同质,当 DRAM 利用率逼近饱和(服务器混部时常见,见 内存通道交织 与 缓存划分 CAT 的隔离语境),多发一条预取就等于让别人的 demand 多排一拍。先进的实现会采样内存控制器的队列深度或利用率计数器,带宽利用率高时全局压低预取激进度。这解释了一个常见现象:同样的二进制,在独占机器上预取是正资产,在带宽打满的混部机器上变成负资产——不是预取器变笨了,是它的反馈环正确地识别出环境变了。
两道闸门的层级也值得一提:MSHR 配额是核内的、局部的保护,反应快(一拍之内见效)但视野窄;带宽反馈是全系统的、全局的调节,视野宽但反应慢(要跨 uncore 采样与传播)。一个好的节流设计是两者串联:局部配额兜底防呆,全局信号决定档位基调。只有前者没有后者,多核同时激进预取时系统带宽照样被打穿;只有后者没有前者,单核突发流就能先把本地 MSHR 耗干。
五、观测与调优:怎么判断预取器帮没帮倒忙
软件侧看预取节流,主要靠对照实验加计数器。三板斧:
- 开关对照:BIOS 或 MSR(如 Intel 的
0x1a4预取器开关位)可以关掉各级预取器,同一负载跑两轮,比 CPI、带宽、miss 率。开预取更慢,说明反馈节流在这颗芯片上没调好,或负载天然反预取(随机访问、指针追逐)。 - 污染指纹:
perf stat里 L1/L2 miss 率上升 + 内存带宽上升 + CPI 恶化三者同现,是预取污染的经典三合一指纹。单独带宽上升可能只是需求真涨了,三样齐涨才坐实。 - 利用率对照:读
perf stat的 DRAM 带宽利用率事件(或 uncore 计数器,编程方式见 perf-counter 与 PMU 编程)。带宽利用率长期 80% 以上的负载,预取的边际收益必然衰减,此时关预取往往反而提速。
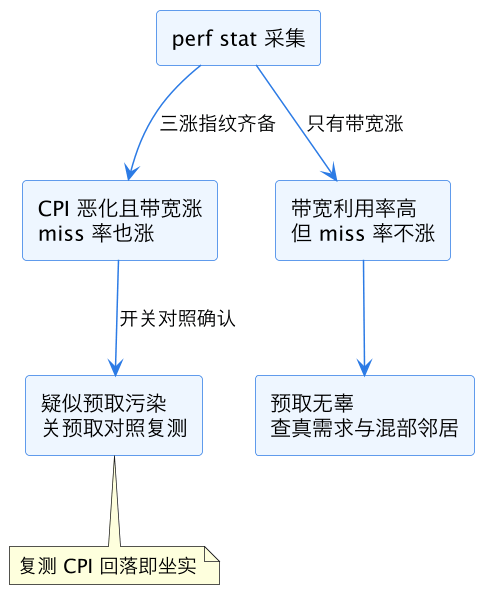
上图是「预取器是否帮倒忙」的判别流程:三涨指纹进对照实验,只有带宽涨则去查别处。判别的关键纪律是不要跳过对照实验直接下结论——预取嫌疑很容易和其他带宽问题混淆,开关两轮复测是唯一可靠的判据。
一个典型的实战案例。某图像转码服务,单机性能达标,混部到存储节点后 p99 劣化 30%。perf stat 对照显示:混部后 L2 miss 率上升 12%、DRAM 带宽利用率从 55% 冲到 90%、CPI 恶化——三涨指纹齐备。BIOS 关闭 L2 streamer 后重测:带宽利用率回落到 70%,p99 恢复,单机吞吐仅损失 2%。结论很典型:转码的顺序访问本来准确率极高,节流器愿意保持激进档,但在带宽打满的环境里「猜得准」也抵不过「发不起」,而这颗芯片的压力反馈没能及时把档位压下来,只能人工兜底。这个案例同时说明:反馈节流是启发式,不是保证,它的统计窗口(通常几十到几百微秒)对突发型带宽竞争的反应注定滞后。
调优动作上,应用侧能做的是「让访问模式对预取器友好」:连续的、定步长的、可预测的布局(数组而非链表、SoA 而非 AoS、按行遍历而非随机跳),等于帮检测逻辑提高置信度,让节流器愿意保持激进档。系统侧能做的是 BIOS 预取开关的基线化——对延迟敏感且访问模式已知的服务,实测决定开关,别迷信默认。
这一篇在知识体系里的位置
本篇是预取系列的收尾件:检测原理在 硬件预取器之步长与流,评估尺子在 预取准确率与覆盖率指标,资源约束在 MSHR 未命中状态寄存器 与 Line Fill Buffer,目标函数在 内存级并行 MLP,系统压力的宏观背景在 DRAM 控制器 FR-FCFS 调度。读完这一圈,预取器从「黑盒加速器」就变成了一个可观测、可推理的反馈控制系统。
总结
预取反馈节流是预取器的自律机制:用准确率、覆盖率、污染度三类统计评估自己,用 MSHR 占用和内存带宽两类压力信号感知环境,在激进、标准、保守、自闭几档之间非对称迁移(降档快、升档慢);判断预取器是否帮倒忙,认「miss 率、带宽、CPI 三涨」的污染指纹,高带宽利用率场景下实测关预取往往是免费的提速。