CET 影子栈与 IBT:硬件控制流完整性如何取代 retpoline 软件缓解
更新时间:2026-10-04。Spectre v2 公开之后,业界对间接分支的态度从「信任预测器」变成「处处设防」:软件侧用 retpoline 把间接跳转改写成一条死循环陷阱,用 IBRS 锁住预测器状态,代价是 5% 到 50% 不等的性能税,这笔账在 retpoline 与 IBRS 的微架构成本 里算过。但软件缓解本质上是在「骗预测器」,治标。Intel 的 CET(Control-flow Enforcement Technology,控制流强制技术)换了一条路:由硬件直接校验控制流——影子栈(Shadow Stack)管
ret返回地址,IBT(Indirect Branch Tracking,间接分支跟踪)管间接jmp/call的着陆点。本篇讲清 CET 影子栈与 IBT 的硬件机理、它们如何在流水线里干活、开销到底多少,以及相对 retpoline 这代软件缓解该怎么选型。瞬态执行攻击的大背景见 Spectre 与 Meltdown 瞬态执行原理,间接分支预测器本身的结构见 间接分支预测。
本文要回答的问题
- CET 影子栈是什么?call/ret 在硬件上多了哪些动作?
- 影子栈内存凭什么「普通指令写不进」?页表上做了什么手脚?
- IBT 与 ENDBR64 如何给间接分支划定合法着陆点?误伤会怎样?
- CET 影子栈的运行时开销有多大?和 retpoline、IBRS 比谁便宜?
- 为什么有了 CET 还要谈「缓解选型」?老 CPU 和老二进制怎么办?
一、为什么需要 CET:软件缓解治标,硬件校验治本
先回顾一下对手。Spectre v2 利用的是间接分支预测器可以被「训练」:攻击者在自己的地址空间里反复跳某个目标,把 BTB(Branch Target Buffer,分支目标缓冲,结构见 分支目标缓冲 BTB)或间接预测器的历史喂脏,受害者进程里同一条间接 jmp/call 就会被预测到攻击者选定的 gadget 上,瞬态执行窗口里把秘密编码进缓存侧信道。返回指令同样有风险——RSB(Return Stack Buffer,返回栈缓冲,见 返回地址栈 RAS)在深度不够时会欠流(underflow),预测结果回退到 BTB,又回到可被训练的老路上。
软件缓解的思路是「让预测结果无害化」。retpoline 把每条间接跳转改写成一小段「call 一个 trampoline,再在里面 pause 转圈」的序列,让预测器即使被污染也只会预测到一个无害的循环;IBRS(Indirect Branch Restricted Speculation)干脆用 MSR 告诉硬件「高权限代码运行时别用低权限上下文训练的预测」。两者的问题在另一篇里详细量化过:retpoline 让每条间接跳转从约 1 到 2 周期涨到 20 多周期,IBRS 的模式切换每次要几百到上千周期,syscall 密集和函数指针密集的负载被税得最狠。
CET 的判断是:与其阻止错误预测,不如让「按错误预测执行下去」这件事变得无害或不可达。它把控制流拆成两个方向分别上锁:
| 方向 | 攻击面 | CET 对应机制 | 校验动作 |
|---|---|---|---|
| 前向边 | 间接 jmp/call 跳到 gadget 中段 | IBT | 着陆点首指令必须是 ENDBR |
| 后向边 | ret 返回到被篡改的地址(ROP) | 影子栈 | ret 地址与影子副本比对 |
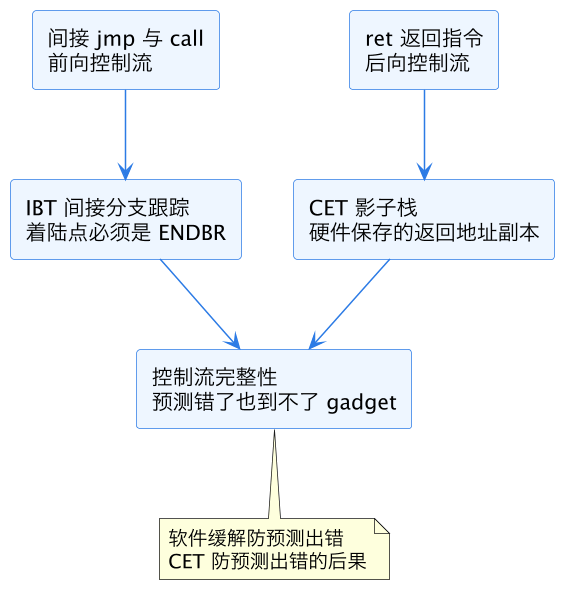
上图是 CET 的世界观:它不试图修好预测器(预测器永远会错,这是推测执行的前提),而是在「预测对了」之外的每条错误路径上设卡。前向边由 IBT 把守,后向边由 CET 影子栈把守,两道关卡合起来构成硬件级的控制流完整性(CFI,Control-Flow Integrity)。
二、CET 影子栈的硬件机理:call 存两份,ret 对两份
影子栈的原理一句话可以说完:除了普通栈上的返回地址,硬件在 call 时把同一份返回地址再压进一块「普通指令写不进」的影子栈内存,ret 时把两边弹出来的值比对,不等就报控制流保护异常(#CP 异常,错误码 NEAR-RET)。
拆开看每个动作多做了什么:
call:照常把返回地址压到普通栈(RSP 减 8 再存),同时把同一地址压到影子栈(SSP,Shadow Stack Pointer,一个新增的架构寄存器,减 8 再存)。两次压栈,一次是普通内存写,一次是影子栈内存写。ret:从普通栈弹出返回地址 A,从影子栈弹出地址 B,比较 A 与 B。相等则正常返回;不等则抛 #CP,进程被内核收尸。- 异常与中断:进入内核时硬件把 SSP 的切换也纳入管理(用户态与内核态各有独立影子栈,内核用
SETSSBSY/SAVEPREVSSP等专用指令切换,防止用户影子栈被内核路径混用)。
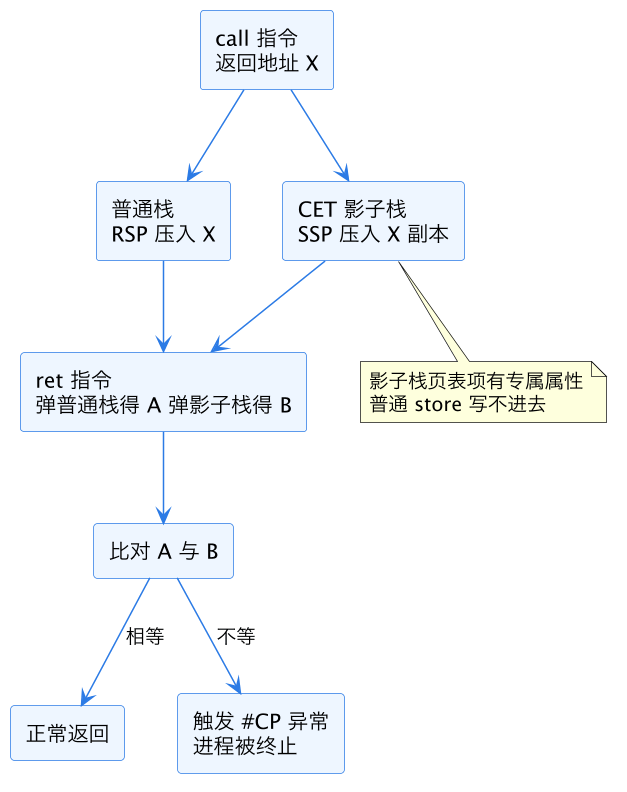
上图里最关键的不是流程而是那道「写不进」的墙。如果影子栈只是另一块普通内存,攻击者既然能改普通栈上的返回地址,顺手也能改影子栈的副本,比对就失去了意义。所以影子栈内存的隔离是机制的命根子,下一节专门讲它怎么实现。
安全收益上,影子栈对 ROP(Return-Oriented Programming,返回导向编程)是釜底抽薪:ROP 的全部前提是改写栈上返回地址把 ret 串成 gadget 链,影子栈让「改普通栈」这一步单独无效——除非你同时攻破影子栈的写保护,但那已经不是栈溢出能做的事了。对 Spectre v2 的返回侧变体(ret 预测被毒化到 gadget)也有意义:瞬态执行里 ret 的错误预测目标仍然受影子栈语义的微架构约束,攻击面被压缩。
三、影子栈内存的隔离:页表属性位与 supervisor 锁
「普通指令写不进」这件事是页表层做的。Intel 在 PTE(页表项)里定义了影子栈页的属性组合:一个「脏位已置位且只读」的页被重新解释为影子栈页。普通 mov 指令往这种页里写会触发页错误;只有 call、ret、以及极少数专用指令(WRUSS、INCSSP、SAVEPREVSSP、RSTORSSP 等)能以影子栈语义访问它。
这个设计有一个很刁的工程细节:影子栈页在属性上看起来是「只读」的,但 call 指令压栈明明是写操作。硬件的处理是:当页表判定目标是影子栈页时,允许来自控制流指令的「影子栈写」,拒绝一切数据写。换句话说,页表权限检查多了一个维度——不只看「读写」,还看「这次访问是谁发起的」。
| 访问发起方 | 普通页 | 影子栈页 |
|---|---|---|
| 普通 mov/store | 按 R/W 位判定 | 页错误(写不进) |
| call 压栈 | 正常写普通栈 | 允许影子栈写 |
| ret 弹栈 | 正常读 | 允许影子栈读 |
| WRUSS 等专用指令 | 视 CPL 而定 | 允许(内核修补用) |
Linux 侧的支持链也要完整:glibc 在加载 ELF 时检查 GNU_PROPERTY_X86_FEATURE_1_SHSTK 标记,只有主程序和所有动态库都带这个标记才启用影子栈;任何一个老 .so 不带标记,整个进程退回无影子栈模式——因为那个 .so 里的 ret 在调用影子栈语义下可能不匹配(比如 setcontext、手工汇编的栈切换)。用户态影子栈通过 arch_prctl(ARCH_SHSTK_*) 接口向内核申请,影子栈 VMA 在内核里也是特殊映射,fork、信号处理(信号帧要保存/恢复 SSP)、makecontext 换栈都要内核配合修补影子栈。
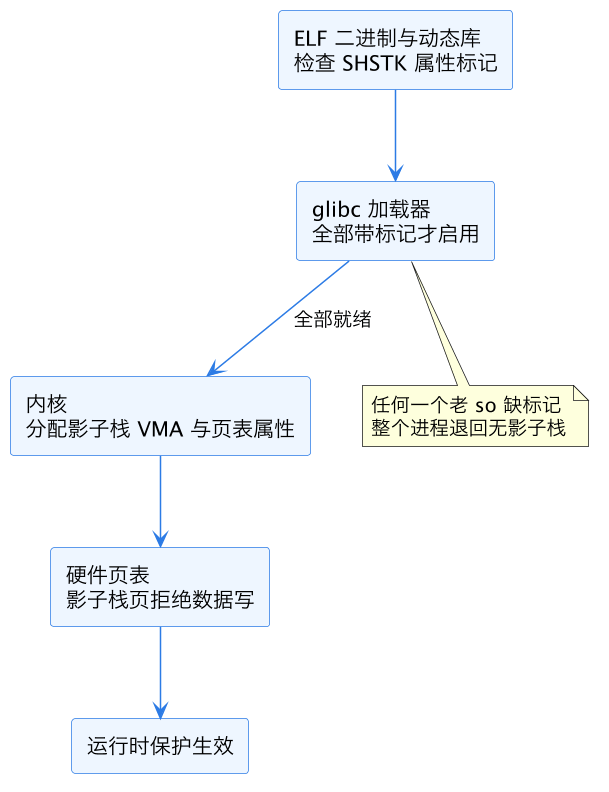
上图说明了为什么影子栈的部署是「全有或全无」:保护链的强度取决于最弱的一环,而混编老库的环境里那一环经常缺席。这也是 CET 上线多年渗透率仍在爬坡的直接原因——不是硬件贵,是软件生态要重新编译。
四、IBT 与 ENDBR64:给间接分支画合法着陆点
后向边有影子栈,前向边靠 IBT。IBT 的规则极简:处理器维护一个「等待 ENDBR」状态,每当执行间接 jmp 或间接 call(包括经 PLT 的动态链接跳转),硬件进入该状态;下一条被执行的指令必须是 ENDBR64(64 位)或 ENDBR32,否则抛 #CP。直接跳转不受影响,可以落到任何地方。
ENDBR64 本身是一条四字节指令(F3 0F 1E FA),在没开 IBT 的老 CPU 上它是 NOP——这是整个方案能渐进部署的关键:编译器可以无脑在每个可能成为间接跳转目标的函数入口和每个函数指针指向的着陆点都放 ENDBR64,老机器上零成本,新机器上自动获得校验。gcc 与 clang 用 -fcf-protection=branch 控制这个行为,full 则同时打开影子栈的编译期支持。
硬件实现上,IBT 是取指/译码前端的一个小状态机,成本远低于影子栈的内存流量:它只是给前端加了一个「下一条指令 opcode 必须匹配」的检查,几乎不占时序关键路径。
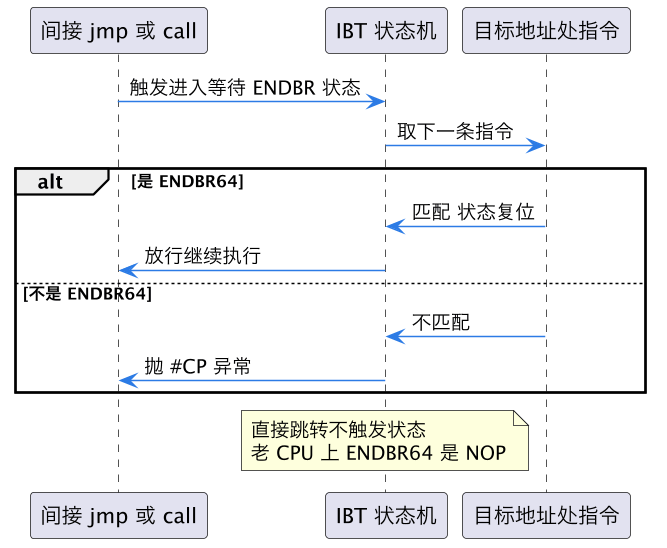
上图是 IBT 的判定序列。注意它对 Spectre v2 的意义比对 ROP 的意义更直接:攻击者训练预测器让间接跳转瞬态落到「函数中段的 gadget」,而函数中段没有 ENDBR64,瞬态路径在 IBT 检查下要么触发异常要么被硬件约束——具体行为取决于微架构实现,但攻击者可用的 gadget 集合被砍到「所有以 ENDBR 开头的位置」,够用的小工具骤减。这也正是发行版在内核里对支持 IBT 的 CPU 优先用 IBT 替代 retpoline 的原因,替代的经济账见下节。
五、开销模型与选型:CET 影子栈对比 retpoline
把三代方案摆到同一张桌上算性能账。
retpoline 的成本是每条间接跳转约 20 多周期(构造的 RSB 陷阱加 pause 循环),对函数指针、虚函数、回调密集的负载(解释器、网络栈 epoll 回调、高频交易系统)是肉眼可见的 5% 到 30% 退化,细节见 retpoline 与 IBRS 的微架构成本。IBRS 的成本在特权级切换:每次进出内核写 MSR,syscall 密集负载退化可达两位数百分比。而 CET 方案里:
- IBT:ENDBR64 是一条前端立即消化的 NOP 类指令,函数入口多 4 字节代码 footprint,I-cache 压力微增;状态机检查不占关键路径。实测开销普遍在 1% 以内,多数基准测不出。
- CET 影子栈:每次 call 多一次影子栈写、每次 ret 多一次影子栈读加比对。影子栈访问走独立缓存行,热路径下基本命中 L1;微基准(纯 call/ret 循环)能看到 2% 到 8% 的开销,真实应用普遍在 1% 到 2% 以内。主要代价其实是内存:每个线程多一份与栈等深的影子栈映射,以及 fork/信号/换栈的内核修补路径。
| 方案 | 防护面 | 单点开销 | 典型负载退化 | 部署条件 |
|---|---|---|---|---|
| retpoline | 仅间接分支瞬态 | 每间接跳约 20 多周期 | 5% 到 30% | 重编译 |
| IBRS | 间接分支瞬态 | 每次特权切换数百周期 | syscall 密集两位数 | 内核加微码 |
| IBT | 前向边 CFI 加 gadget 削减 | 函数入口 4 字节 | 1% 以内 | 新 CPU 加重编译 |
| CET 影子栈 | 后向边 CFI 加 ROP 免疫 | 每 call/ret 各一次影子栈访问 | 1% 到 2% 微基准到 8% | 新 CPU 加全生态重编译 |
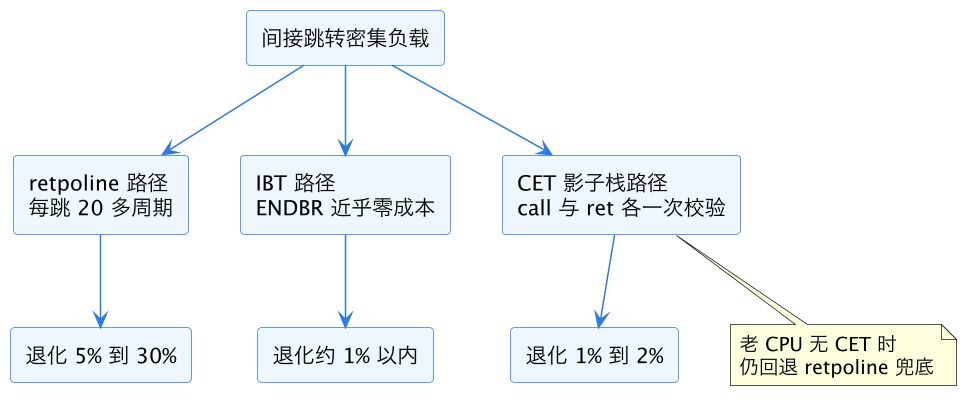
上图给出了选型逻辑:在有 CET 的新 CPU 上,内核和发行版用 IBT 换掉 retpoline、用影子栈补 ROP 防护,把缓解税降到接近零;在老 CPU 或二进制没重编译的场景,retpoline 与 IBRS 仍是唯一可用的兜底。这就是为什么性能分析时必须先确认机器实际启用了哪套缓解——/sys/devices/system/cpu/vulnerabilities/spectre_v2 的输出里 IBT 与 Retpoline 字样直接决定你看到的 IPC 基线,观测手段见 PMU 性能计数器编程。
还有一个容易忽视的现实:CET 与软件缓解不是互斥的。瞬态执行的根子——预测器与推测窗口——依然在,背景见 Spectre 与 Meltdown 瞬态执行原理;CET 压缩了可利用的 gadget 面,但内核里仍然保留着针对残余变体的 lfence、入口清空 RSB 等补丁。理解 CET 的正确姿势是「把软件缓解里最贵的那部分硬件化」,而不是「终结缓解」。
这一篇在知识体系里的位置
本篇是微架构模块「瞬态执行与缓解线」的硬件篇。攻击原理的上游是 Spectre 与 Meltdown 瞬态执行原理,预测器结构背景见 分支目标缓冲 BTB、返回地址栈 RAS 与 间接分支预测。同线的软件缓解对照篇是 retpoline 与 IBRS 的微架构成本——本篇的 CET 影子栈与 IBT 正是那篇文章里两笔重税的硬件化解法。观测缓解是否生效、开销落在哪,用 PMU 性能计数器编程。全景地图见 CPU 微架构总览。
总结
CET 影子栈与 IBT 把控制流完整性从软件缓解升级为硬件校验:影子栈在 call 时把返回地址压进一块页表属性保护、普通指令写不进的副本区,ret 时双栈比对、不符即抛 #CP,从根上免疫 ROP;IBT 则要求间接 jmp/call 的着陆点首指令必须是 ENDBR64(老 CPU 上是 NOP),把攻击者可用的 gadget 面砍到函数入口级。两者合计把 retpoline 动辄 5% 到 30%、IBRS 切换数百周期的软件缓解税压到 1% 到 2% 以内,代价是全软件生态需要重编译且任何缺标记的老动态库都会让保护整体失效,因此在新硬件上 CET 优先、老硬件上 retpoline 与 IBRS 兜底,构成当前控制流防护的双轨格局。