目录与监听一致性:多核缓存为什么从"广播喊话"进化到"花名册点名"
承 mesi-protocol——那一篇讲的是单个一致性协议内部 M/E/S/I 四个状态怎么流转,但没有回答一个更根本的问题:状态变更这件事,其他核是怎么知道的? 答案只有两派:一派让所有人竖起耳朵听总线上的广播(监听协议,Snoopy Protocol),另一派设一个"户籍管理处",每个缓存行登记在册,谁持有谁共享一目了然(目录协议,Directory Protocol)。目录与监听一致性的选择决定了多核处理器能堆多少核、片间互连长什么样,也是理解 NUMA 服务器和 ccNUMA 扩展机的钥匙。目录在互连结构里的物理落地见 directory-coherence-interconnect,本篇聚焦两种协议范式的对比本身。
本文要回答的问题
- 监听协议和目录协议在结构上差在哪,各自的一次读缺失要发几条消息?
- 为什么监听协议超过 8~16 核就撑不住,瓶颈到底是带宽还是别的东西?
- 目录协议用存储开销换可扩展性,这个开销具体多大、有几种压缩办法?
- 真实的 x86 服务器是怎么把两种协议拼在一起用的?
- 写性能分析代码时,这两种协议的行为差异会暴露成什么可观测的现象?
一、问题的起点:一致性消息必须送达谁
先把问题本身钉死。多核各自带私有 L1/L2 缓存,同一个内存地址可能同时存在多份拷贝。当核 A 要写这个地址时,协议必须保证:其他核手里的旧拷贝要么失效、要么被更新——这是"一致性"的全部含义。MESI 这类状态机(见 mesi-protocol 与 mesi-variants)规定了每个本地缓存行处于什么状态、什么事件触发什么迁移,但状态机是"本地视角"的:核 A 把自己的行从 S 改成 M,这件事必须有人通知所有持有 S 拷贝的核,让它们降级到 I。
通知怎么发出去,就是协议范式之争。抽象地看只有两种拓扑:
- 广播式(监听):消息发到一条共享介质上,所有缓存控制器同时收到,各自判断"这条消息跟我有没有关系"。
- 点对点式(目录):消息先发到一个中心协调者,协调者查表知道谁持有该行,只给相关者发消息。
这个差别听起来是"群发短信 vs 打电话"的小事,但在 4 核和 64 核尺度上,它决定了系统能不能活着跑起来。
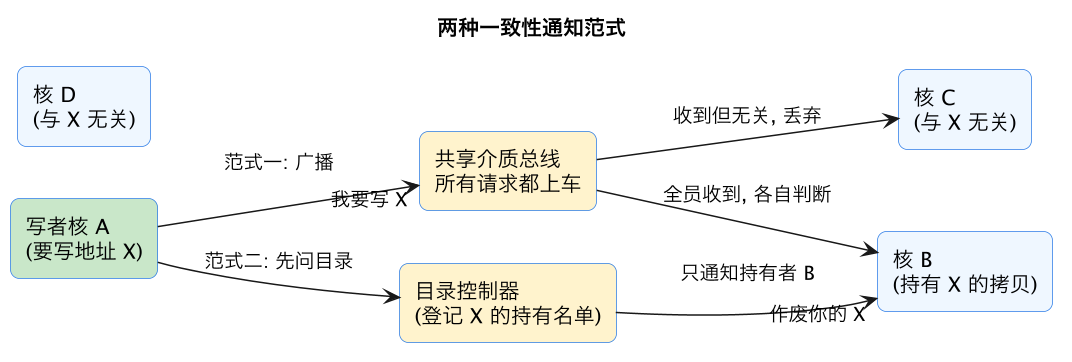
这张图的核心对比:广播路径里无关者 C 也被迫收到消息,它要做的只是听完扔掉,但"听"这个动作本身就占用互连带宽和缓存 tag 端口的查询周期;目录路径里消息只流向真正持有拷贝的 B,无关者完全无感。规模小时前者反而更快(一跳直达),规模大了后者才显出价值。
二、监听协议:总线时代的优雅与天花板
监听协议的完整工作流,以一次"核 A 写、核 B 持有共享拷贝"为例:
- 核 A 的写请求在本地 L1 查是 S 状态(只读共享),不能直接写,于是向总线发出 BusUpgr / 读独占(BusRdX) 请求;
- 总线上所有缓存控制器同时看到这个请求,各自查自己的 tag:核 B 发现自己有 S 拷贝,把该行置为 I,并发出确认;
- 核 A 收齐确认后把本地行升为 M,写入完成。
三个消息、一次广播、一跳延迟——在 2~4 核的小系统里这套机制几乎无可挑剔:逻辑简单、正确性容易验证(总线天然给所有请求排了全局顺序),也不需要任何额外的状态存储。
但天花板同样明显,而且有三层:
| 瓶颈层 | 机理 | 出现拐点 |
|---|---|---|
| 总线带宽 | 每个一致性请求都上总线,总线吞吐固定 | 核数 × 请求率超总线能力即饱和 |
| 串行化仲裁 | 总线同一时刻只能传一个请求,本质是一把全局锁 | 8~16 核时仲裁等待主导延迟 |
| tag 端口争抢 | 每个广播都要所有缓存查 tag,与本地正常访存抢端口 | 需要双端口 tag 或复制 tag,面积代价 |
第一条是硬约束。假设每核每秒产生 200M 次一致性消息(一次 L1 miss 大约一条),16 核就是每秒 32 亿条消息全压在一条总线上——物理上做不出这样的共享介质。第二条更本质:总线把所有请求排成一个全局序列,这个性质简化了协议正确性,却也意味着请求延迟随核数线性恶化,核越多排队越久。
所以历史上监听协议的领地止步于单插槽小系统:经典 SMP 服务器 4~8 核、今天的单 die 消费级 CPU(ring/mesh 上跑改良版监听语义)都在这个量级。核数一上去,要么换范式,要么把系统切成多个小监听域——后者正是现代 x86 的实际做法,后文详述。
三、目录协议:用一张花名册换可扩展性
目录协议的思路是把"谁知道这行"从"问所有人"改成"查登记簿"。每个内存地址(以缓存行为粒度)在目录里有一条记录,内容是:这行现在被哪些缓存持有、处于什么状态。同样一次"核 A 写、核 B 持有":
- 核 A 本地是 S,向 X 的 home 节点(该地址归属的目录控制器)发 ReadExclusive 请求——注意是点对点,不走广播;
- 目录查到记录:X 当前由 B 共享(S 状态),于是只向 B 发 Invalidate;
- B 作废本地拷贝,向目录(或直接向 A)确认;
- 目录更新记录为"A 独占(M)",放行 A 的写。
消息数从"1 次广播到达全部 N 个节点"变成"3~4 条点对点消息",且与总核数无关——无论系统 16 核还是 256 核,一次写升级的消息量恒定。这就是可扩展性的全部来源:一致性流量只随"真正共享这行的核数"增长,而不随系统总规模增长。
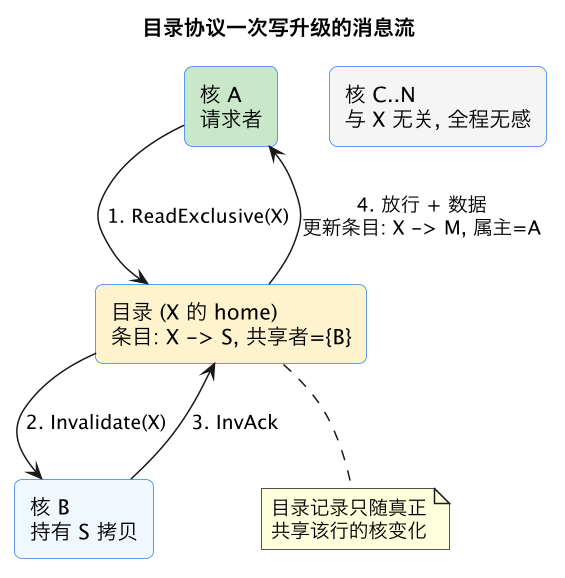
注意这张时序图里无关者从头到尾不出现——这正是与上一张图的本质差别。代价也有两个:一是延迟从"一跳广播"变成"请求者 → 目录 → 持有者"两到三跳,home 在远端 NUMA 节点时延迟更高(NUMA 局部性的影响见 cache-numa-locality);二是目录本身要占存储,而且占多少是个严肃的设计问题。
四、目录存储开销:这笔账到底多大
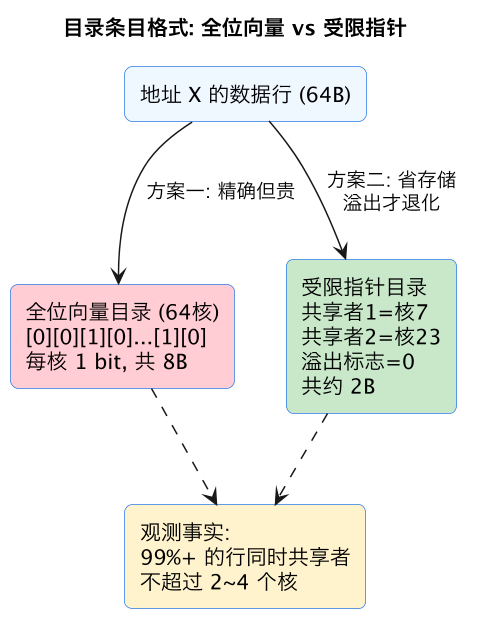
目录条目需要回答"地址 X 的行被谁持有"。最朴素的方案叫全位向量(full bit-vector):N 个核就用 N 个比特,第 i 位置 1 表示核 i 持有拷贝。算一笔账:
- 64 核系统,每行 64 bit = 8 字节目录信息;
- 每行数据 64 字节,目录开销 = 8/64 = 12.5%;
- 128 核变 16 字节,开销 25%;1024 核就是 128 字节——目录比数据还大。
开销随核数线性增长,这成了目录协议自己的天花板。工程上发展出一族压缩方案:
| 方案 | 做法 | 开销 | 代价 |
|---|---|---|---|
| 全位向量 | N bit 精确记录每个核 | N/64 字节每行 | 随核数线性膨胀 |
| 粗粒度向量 | 一比特代表一组核(如 8 核一组) | N/8 bit | 组内误发多余 Invalidate |
| 受限指针 | 只存 k 个共享者的核号 | k·log2(N) bit | 第 k+1 个共享者触发溢出处理 |
| 链式目录 | 目录存头指针,缓存行互相串链 | log2(N) bit | 失效沿链传播,延迟跳数增加 |
| 分层/混合 | 核内全向量 + 跨片粗粒度 | 分级 | 实现复杂,商用主流 |
关键洞察是:绝大多数缓存行在任意时刻只有 0 或 1 个持有者(程序里私有数据远多于共享数据),少数热点行才有 2~8 个共享者,64 个核同时共享一行的情况几乎只出现在同步原语和全局屏障上。所以"为每行预留记录全部 N 核的空间"是极大的浪费——受限指针方案存 2~4 个指针就能覆盖 99% 以上的场景,溢出时退化为广播或软件处理。这个分布规律和 cache-lock-contention-bouncing 描述的锁竞争热点是同一件事的两面:真共享是稀少的、集中的。
商用实现的实际做法也印证了这一点。Intel 从 Nehalem-EX 起在 LLC 里内嵌目录位(tag 旁挂共享者信息),AMD EPYC 的每个 CCD 内是一致性域、跨 CCD 由 IOD 的目录协调;两者目录记录都做到缓存 tag 的存储里随数据行一起分配,行被逐出时目录条目随之回收——目录不需要独立的大 SRAM,而是寄生在已有的缓存结构上。
五、真实世界是混血儿:片内监听语义 + 片间目录
教科书把两种协议讲得泾渭分明,打开现代服务器却发现是分层混血。以一颗典型的 2 路 Xeon / EPYC 为例:
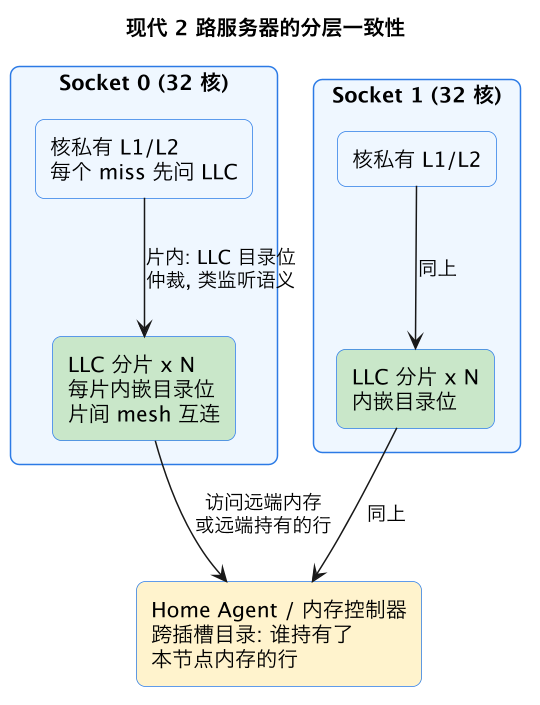
三个层次各取所长:片内几十核规模,靠 LLC 每个分片 tag 上挂的目录位就能知道行在片内谁手里,不需要全局广播,但协议行为保留了监听式的"快速一跳"特征;跨插槽走 UPI/xGMI 这类点对点链路,Home Agent 维护跨节点目录,纯目录协议;内存侧DRAM 行本身不带一致性状态,状态全部寄生在缓存和 Home Agent 里。NUMA 远端访问的高延迟(本地 ~90ns vs 远端 ~140ns 以上)很大程度上就是"多了一跳跨插槽目录查询"的物理体现,这条链路的性能分析手法见 cache-numa-locality。
这个分层结构对性能分析者的实际意义是:同一个 false sharing 问题,在两个核同属一个 LLC 域时表现是一种延迟曲线,跨插槽时是另一种更陡的曲线。用 perf 观测时,跨插槽一致性流量会体现在 uncore 计数器和 UPI 带宽事件上,而片内的则完全藏在 LLC 命中延迟的方差里。false sharing 的机理见 mesi-false-sharing,本篇不重复。
六、可观测差异:两种协议在性能计数器里长什么样
落到工程观测上,两种范式的行为差异有三个可检测的信号:
- 一致性延迟的核数敏感度。监听域内每增加一个活跃核,所有广播的仲裁排队都变长——锁竞争基准里核数翻倍、单次
lock cmpxchg延迟涨 30% 以上是典型信号;目录协议下延迟只随"这行的真实共享者数"变化,加无关核不劣化。 - 广播流量的存在性。总线利用率类计数器(老机器的
BUS_TRANS_*,现代机器的 mesh/UPI 带宽事件)若随核数线性暴涨,说明存在某种广播或类广播机制在饱和。 - NUMA 远端延迟的构成。跨插槽读 = 本地 miss + 跨节点目录查询 + 数据回传三段,用
perf c2c(见站内 measuring-cache-perf-counters 的计数器基础)可以把 HITM(Hit Modified,从别的核缓存里取到修改过的行)按本地/远端拆开,远端 HITM 占比高 = 跨插槽一致性流量是瓶颈。
对写代码的人,结论收敛成一句老话的升级版:减少真共享、消灭伪共享、让共享数据的持有者尽量在同一个一致性域内。协议层面你改变不了它是目录还是监听,但你能改变目录里登记的名单长度——名单越短,消息越少,世界越安静。
这一篇在知识体系里的位置
本篇是缓存一致性专题里"协议范式"这一层,向上承接状态机、向下落地互连:
- mesi-protocol / mesi-variants:一致性状态机的本地视角;本篇回答"状态变更怎么送达其他核"这个它没展开的问题。
- directory-coherence-interconnect:目录在互连拓扑里的物理实现细节,与本篇互补。
- mesi-false-sharing 与 cache-lock-contention-bouncing:一致性流量在应用层的两种典型病灶,本篇的协议视角解释了它们为什么贵。
- cache-numa-locality:目录协议跨节点查询延迟的应用层表现。
- 上游导读:cpu-microarch-overview 的微架构全景,cache-organization 的缓存结构基础。
总结
目录与监听一致性是多核缓存一致性的两种通知范式:监听协议让所有核竖起耳朵听总线广播,一跳直达、逻辑简单,但广播带宽和串行仲裁把规模钉死在十几核以内;目录协议给每个缓存行登记"谁持有"的花名册,消息点对点只送相关者,用约 5%~12% 的存储开销(靠受限指针、粗粒度向量压缩)换来核数无关的恒定消息量——现代服务器是两者混血:片内 LLC 目录位保留监听式快路径,跨插槽 Home Agent 跑纯目录协议,而性能分析者的全部功课就是让自己数据的花名册名单尽可能短。