分支别名冲突:BTB 与 PHT 哈希撞车导致的预测互扰
更新时间:2026-10-06。本篇是分支预测系列的零件文。站内相关阅读:TAGE 分支预测器 讲方向预测的主力结构,分支目标缓冲 BTB 讲目标地址的缓存,双模态与 gshare 预测器 讲基础预测器族,分支历史寄存器长度 讲历史位的预算。本篇聚焦一个所有预测器都躲不开的结构性问题:表是哈希索引的,哈希就会撞车。
本文要回答的问题
- 预测表为什么必须用哈希索引,别名从哪来?
- 中性、建设性、破坏性三种别名各是什么,哪种真正伤人?
- BTB 别名和 PHT 别名的伤害方式有何不同?
- TAGE 的多表结构为什么能天然稀释别名?
- 怎么用 perf 和微基准测量别名冲突的严重程度?
- 代码布局和对齐上有哪些可操作的规避手法?
一、别名的根源:无限的分支,有限的表项
分支预测器的所有表格——BTB、方向预测的模式历史表(PHT)、间接预测表——本质都是用程序地址(PC)的若干位做索引的哈希表。程序里可能有几十万条分支,表项只有几千到几万个,多对一的映射不可避免:两条地址不同的分支,只要 PC 用于索引的那些位相同(再叠加全局历史后的哈希值相同),就会落到同一个表项上。这就是别名(aliasing):两条互不相关的分支共享同一份预测状态,一方的训练会改写另一方赖以预测的历史。
别名不是设计失误,而是成本约束下的必然。全相连无冲突的预测表在面积和功耗上不可行,TAGE 分支预测器 用「多个不同历史长度的表」把别名概率摊薄(两条分支要在所有表上都撞上才彻底互扰),双模态与 gshare 预测器 里的 gshare 用「PC 异或全局历史」做索引,历史不同则索引不同——历史本身就是一种天然的防冲突扰码。但只要表容量有限、分支足够多,别名就只是被稀释,从未被消灭。
TAGE 的抗别名设计值得再展开一层。它的每一级表用不同长度的全局历史折叠进索引,两条分支的近期历史相同、远期历史通常不同,于是在短历史表上撞车的两条分支,在长历史表上大概率分道扬镳——TAGE 的「择优用最长匹配历史」规则,客观上让每条分支逃到「不撞车的那一级」。这就是为什么 TAGE 类预测器对别名的鲁棒性远强于单表 gshare:不是表更大,而是撞车的概率被历史维度稀释了。反过来,当全局历史本身被破坏(高噪声分支灌入历史流),这个稀释机制会失效,别名在各级表上同步恶化——历史质量和表容量是抗别名的两条腿。
上图是别名产生的瞬间:两条分支的 PC 低位与全局历史经异或后得到相同索引,共享一个两位饱和计数器。甲刚把计数器训练到「强跳」,乙的实际行为是不跳——乙的每次执行都把计数器往回拨,甲再来时预测就错了。两条分支越「意见不合」,互扰越严重。
还要澄清别名与「容量不足」的区别:容量不足是表项被热分支占满,新分支挤走旧分支的状态,属于「先来的吃亏」;别名是两条分支同时在册、共享一项,属于「谁也占不稳」。前者随热分支总数增长而线性恶化,后者是离散的「撞没撞上」问题。两者经常叠加出现——热分支越多,撞车概率越大,破坏性别名的密度越高——但诊断和缓解的手法不同:容量问题靠减少热分支总量,别名问题靠挪动地址分布。
二、三种别名:只有一种是真伤
按两条分支的行为组合,别名分三类:
| 类型 | 两条分支的行为 | 后果 | 占比直觉 |
|---|---|---|---|
| 中性(neutral) | 行为相同(都常跳或都常不跳) | 无损失,训练结果对双方都对 | 多数随机撞车落在这类 |
| 建设性(constructive) | 一方帮另一方更快收敛 | 冷启动误预测减少 | 少见但真实存在 |
| 破坏性(destructive) | 行为相反或一方高噪声 | 双方误预测率同步上升 | 性能事故的主角 |
这个分类的工程含义是:别名普遍存在,但有害别名是稀少的。典型程序里绝大多数撞车是中性的——随机两条分支的行为分布本就偏向「大多数分支高度偏斜(bias)」,两个强偏斜分支撞一起,只要偏斜方向一致就相安无事。破坏性别名需要「强跳」与「强不跳」(或 50% 摇摆的高噪声分支与任何分支)恰好共享表项且都在热路径上,概率不高,可一旦命中就是稳定的误预测源。由于每次误预测的代价是 15-25 拍的前端冲刷(机制见 取指重定向与恢复),一个热循环里的破坏性别名对 IPC 的影响清晰可测。
给一个具体画面。热循环里有一条「99% 不跳」的循环退出分支,另有一条「95% 跳」的错误处理分支,两者 PC 低位恰好只差一个表索引位覆盖不到的高位。循环每转一圈,错误处理分支把共享计数器往「跳」推一格,退出分支再把它拨回来——退出分支本该稳定预测「不跳」,却因为邻居的持续干扰,每隔若干轮就被推到「弱跳」区间,一旦越界就是一次 20 拍的误冲刷。两条分支各自的逻辑都无可挑剔,错的是它们住得太近。
BTB 的别名伤害方式与 PHT 不同,值得分开看。PHT 别名只是猜错方向;BTB 别名更粗暴——两条分支共享 BTB 项时,分支目标缓冲 BTB 里存的目标地址会被互相覆盖:甲分支查到的可能是乙分支的目标,前端直接取指到错误地址,要等执行级验算才发现。更糟的一种是「假阳性」:某条根本不是分支的指令地址撞上了一条分支的 BTB 项,前端会对着普通指令做跳转预测——纯冤枉钱,误预测的全程代价一拍不少。

三、测量:怎么证明慢是因为别名
别名冲突的测量分「证明存在」和「定位到谁」两步。
证明存在,用容量压力微基准:生成 N 条均匀散布、行为完全相同的无条件/恒跳分支,循环执行,测误预测率随 N 的变化。N 小于表容量时误预测接近零;N 超过某个拐点,误预测率开始爬升——拐点就暴露了有效表容量,而「同行为分支都开始互扰」说明撞车已经密集到中性别名都变成了容量驱逐。把分支行为改成「一半跳一半不跳」交替模式再测,破坏性别名占比上升,拐点会提前出现。这套方法也是反推各家预测器规格(表项数、tag 位数、历史长度,配合 分支历史寄存器长度 的思路)的标准逆向工程手法。
微基准的一个实用变体是「成对扫描」:固定一条参考分支,把第二条分支放在与它相距不同偏移的位置上,测参考分支的误预测率随偏移的变化。误预测率出现尖峰的偏移,正好暴露了索引位覆盖的地址区间宽度——这是推断「哪些 PC 位参与索引」的直接办法。逆向出的这些参数没有官方文档(厂商从不公布哈希细节),但对极致调优场景是有价值的输入。
对真实程序,工具链是 perf 加 LBR。第一步看总量:perf stat -e branches,branch-misses 得到误预测率,超过 2-3% 就值得深挖。第二步定位:perf record -e branch-misses -j any,branch(或 LBR 栈)采样,把误预测归因到具体分支地址。第三步才是别名特有的判断:同一条分支在代码逻辑上明明高度可预测(比如恒跳),误预测却持续发生——分支自己没问题,问题在「邻居」。此时可以用链接器重排函数/基本块,把这条分支的地址挪开,误预测率若显著变化,即坐实别名。
还有一个统计上的旁证:别名单元的误预测往往呈「成簇出现、地址稳定」的分布——同一代码位置反复误预测,且误预测的 LBR 记录里总能看到另一个固定的「嫌疑邻居」分支在近期历史中高频出现。把这层观察显式化,就是把 perf report 的热点地址和 LBR 栈里的前驱分支做交叉计数,排名靠前的共现对就是最可疑的别名对。这一步在没有微基准条件验证的生产环境排查里尤其有用。
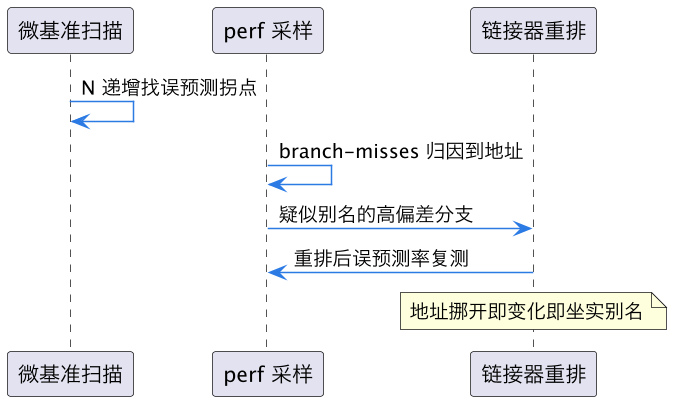
上图是三步验证链。注意最后一步是别名诊断的独有动作:其他预测问题(历史不够长、模式太随机)改地址是无效的,只有别名对「分支住在哪个地址」敏感——这既是诊断的判据,也是下一节规避手法的理论基础。
四、规避与共处:布局层的可操作手法
软件侧能动的只有一件事:让热路径上「意见不合」的分支在索引位上错开。可操作的手法按成本从低到高:
- 函数/基本块对齐与重排:编译器的
-falign-functions、PGO/BOLT 的布局优化会改变分支地址分布。别名敏感的微基准上,仅改变函数对齐就能让误预测率波动数个百分点——这不是玄学,是索引位被挪了。 - 拆散高密度分支区:一大片连续的
if-else链里所有分支的 PC 低位天然相近,某些预测表的索引位极易集体撞车。改写成跳转表、查表法或重排条件顺序,同时缓解了密度和别名两个问题(顺带还减少 taken 分支气泡)。 - 给「问题分支」换邻居:定位到破坏性别名对之后(三步验证链),在两条分支之间插入对齐填充或调整其中一个函数的位置。这类「精准手术」只适合被 profiling 证实的热点,全程序撒胡椒面式地调对齐反而会引入新的撞车。
- 减少对全局历史的依赖是双刃剑:高噪声分支「污染」的不仅是表项还有全局历史本身(分支历史寄存器长度 讨论过历史位是稀缺资源)。把可预测的确定性分支改成无分支代码(cmov、算术技巧),既消除它自己的误预测,也把它占的历史位和表项还给其他分支。
一个需要泼冷水的提醒:别名冲突的优化收益高度平台相关。同一个二进制换一代 CPU,表容量和哈希函数都变了,昨天精心错开的分支今天可能撞在一起。所以别名优化只适合两种场景:被 profiling 坐实的具体热点,和为固定平台深度调优的极致场景(高频交易、编解码内核)。通用代码层面,更值得做的是「减少分支总量、提高分支可预测性」这类与平台无关的功。
顺手纠正一个流传颇广的误解:「把代码对齐到 64 字节/缓存行边界能避免别名」。对齐改变的是取指与 I-Cache 的行为,对预测表索引的影响是间接且不确定的——索引位取的是 PC 的哪些位属于各家实现机密,对齐到某边界只是碰巧挪动了其中几位。因此「对齐防别名」不可作为方法论,只能作为实验变量:改了对齐就重测,用数据说话,不赌运气。
这一篇在知识体系里的位置
本篇补分支预测系列的「失效模式」一角:预测器结构见 TAGE 分支预测器、双模态与 gshare、感知机预测器 与 竞标赛预测器,目标侧见 分支目标缓冲 BTB 与 间接分支预测器 ITTAGE,资源预算见 分支历史寄存器长度,误预测代价见 取指重定向与恢复 与 taken 分支气泡,观测手段见 LBR。
总结
分支别名冲突是预测表哈希索引的结构性代价:两条分支撞上同一表项时,中性别名无害、破坏性别名让双方误预测率同步上升;BTB 别名比 PHT 别名更凶(目标地址直接错乱甚至误导非分支指令)。诊断认「分支本身高度可预测却持续误预测、挪动地址即变化」这条独有判据,规避靠布局错开索引位,但收益平台相关,只值得对 profiling 坐实的热点动刀。