SIMD 向量执行全景:从 SSE 到 AVX-512 与 SVE 的执行单元组织、掩码体系与性能地图
更新时间:2026-10-08。本站在向量方向已经攒下几篇零件级深文:向量 SIMD 执行单元 拆解向量单元在流水线里的物理位置,AVX-512 降频许可 讲重型向量指令为何拉低全核频率,SVE 谓词寄存器模式 讲 ARM 可变长向量的谓词玩法,SIMD 向量长度无关编程 讲「写一次跑所有宽度」的编程模型,AVX10 融合向量 ISA 讲 Intel 收拾 AVX-512 碎片化残局的新规范。零件都在,缺的是一张全景地图:向量执行这条技术线三十年怎么演进、硬件里到底有几条向量流水线、掩码体系解决了什么、SIMD 的性能天花板由谁决定。这篇枢纽文把 SIMD 向量执行全景一次铺开。
本文要回答的问题
- 从 SSE 到 AVX-512 再到 SVE,向量宽度与寄存器体系是怎么一路演进的,每一代解决了什么痛点?
- 一颗现代服务器核里到底有几条向量执行流水线,512 位运算是怎么被拼出来或被拆开的?
- 掩码寄存器与谓词寄存器是什么,为什么它是 AVX-512 与 SVE 相对老 SSE 的代差级能力?
- 「AVX 降频」的物理原因是什么,轻量与重型指令的许可档位怎么划分?
- 为什么很多 SIMD 内核跑不满理论峰值,内存带宽和指令组合各扮演什么角色?
- 工程上怎么判断一段代码值得向量化,又该用什么工具确认编译器真的生成了向量指令?
一、SIMD 是什么:用一条指令换一个数据流
SIMD(Single Instruction Multiple Data,单指令多数据)的思想朴素到极致:既然循环里对一千个浮点数做同样的加法,那就不要用一千条标量加法指令,而用一条「把 16 个浮点数一起加」的向量指令。指令 fetch、译码、发射、退休这些前端与乱序控制开销只付一次,却完成了 16 倍的数据吞吐。这就是向量执行的本质——把控制流成本摊薄到一个向量宽度的数据上。
与之对照的概念先分清。MIMD 是多核/多线程,每个核跑自己的指令流处理自己的数据;SIMT 是 GPU 的玩法,硬件把 32 个线程锁步成一个 warp,遇到分支就串行化两条路径;而 CPU 的 SIMD 是单线程内部的指令级并行加宽,它不引入新线程,程序员看到的是更宽的寄存器和更宽的运算指令。三者的性能哲学完全不同:多核扩的是任务吞吐,GPU 扩的是海量同质计算,CPU SIMD 扩的是单线程里那段热循环的密度——延迟敏感、难以拆线程的代码(编解码、密码学、JSON 解析、信号处理),恰恰只有 SIMD 能吃。
向量化的收益可以用一个极简模型估算:一段循环如果 90% 的时间在做同构算术,向量宽度为 W,理论加速上限接近 W 倍(Amdahl 定律下略低)。SSE 时代 W=4(32 位浮点),AVX2 是 8,AVX-512 是 16,SVE2 在 512 位实现上也是 16。但真实加速往往停在 3-10 倍之间,差的部分去哪了,是第五节的主题——先记住一个判断:SIMD 的账面宽度是免费的,跑满宽度是要拿工程细节换的。
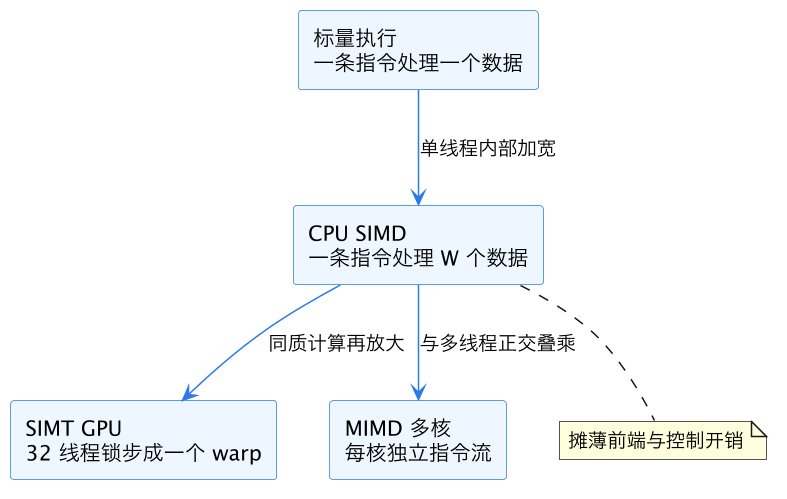
上图把四种并行形态摆在一起:SIMD 处在「单线程加宽」这一格,它与多线程是正交关系——先向量化把单核密度拉满,再开线程扩核数,两者相乘。顺序反了(先开线程再发现单线程代码没向量化)是性能工程里最常见的返工路径。
一个常被拿来反问 SIMD 价值的问题是「GPU 不是更快吗」。对海量同质浮点(训练、渲染)确实如此,但 GPU 的吞吐是拿延迟和调度粒度换来的:一次 kernel 启动微秒级开销、数据要过 PCIe 或统一内存往返、分支发散直接串行化。而 CPU SIMD 的向量指令就在调用者的下一条指令位置上,纳秒级生效,还能和标量逻辑、系统调用、指针追逐自由混编。判据很直白:计算密度高到值得把数据搬过去的给 GPU,长在控制流里的热循环给 SIMD。真实系统里两者经常接力——SIMD 做预处理与解析,把规整后的大块数据喂给 GPU。
二、ISA 年表:从 128 位到可变长
x86 向量指令集的三十年演进,每一代都围绕三件事做文章:更宽的寄存器、更多的寄存器个数、更丰富的数据操纵原语。
| 代际 | 年份 | 寄存器宽度与数量 | 关键新增能力 | 遗留痛点 |
|---|---|---|---|---|
| MMX | 1997 | 64 位 × 8(复用 x87 栈) | 整数打包运算 | 与浮点状态冲突,迅速淘汰 |
| SSE/SSE2 | 1999-2001 | 128 位 xmm0-15 | 独立浮点向量、双精度 | 两操作数破坏性写、对齐要求苛刻 |
| SSE3-SSSE3-SSE4 | 2004-2008 | 同上加指令 | 水平加、字节洗牌、点积 | 宽度停滞 |
| AVX/AVX2 | 2011-2013 | 256 位 ymm0-15 | 三操作数非破坏写、FMA、gather | 无掩码、尾循环处理笨重 |
| AVX-512 | 2016 起 | 512 位 zmm0-31 | k0-7 掩码、嵌入式舍入、broadcast | 子集碎片化严重、降频争议 |
| AVX10 | 2023 起 | 收敛 128/256/512 | 统一枚举、可选 512 | 生态迁移中 |
| ARM NEON | 2005 起 | 128 位固定 | 移动端事实标准 | 宽度固定 |
| ARM SVE/SVE2 | 2019 起 | 128-2048 位可变长 | 谓词寄存器 p0-15、长度无关 | 仅服务器/旗舰核实现 |
这张表里有三条暗线值得展开。第一条是操作数形式的解放:SSE 的 addps xmm0, xmm1 会把结果写回 xmm0、摧毁其中一个源操作数,编译器不得不插入大量 movaps 拷贝;AVX 引入三操作数形式 vaddps ymm0, ymm1, ymm2,一条指令干完,寄存器分配压力骤降——这是为什么同样的 128 位代码用 AVX 编码重编也能快几个百分点。第二条是寄存器数量翻倍:AVX-512 把向量寄存器从 16 个扩到 32 个,寄存器压力大的内核(多项式求值、矩阵小块乘法)可以少 spill 一半。第三条是碎片化的代价:AVX-512 历史上被拆成 F、CD、ER、PF、BW、DQ、VL、VBMI、VNNI 等十几个子集,不同代 CPU 支持不同组合,软件分发变成特性检测地狱;AVX10 融合向量 ISA 就是 Intel 为收拾这个局面提出的收敛枚举。
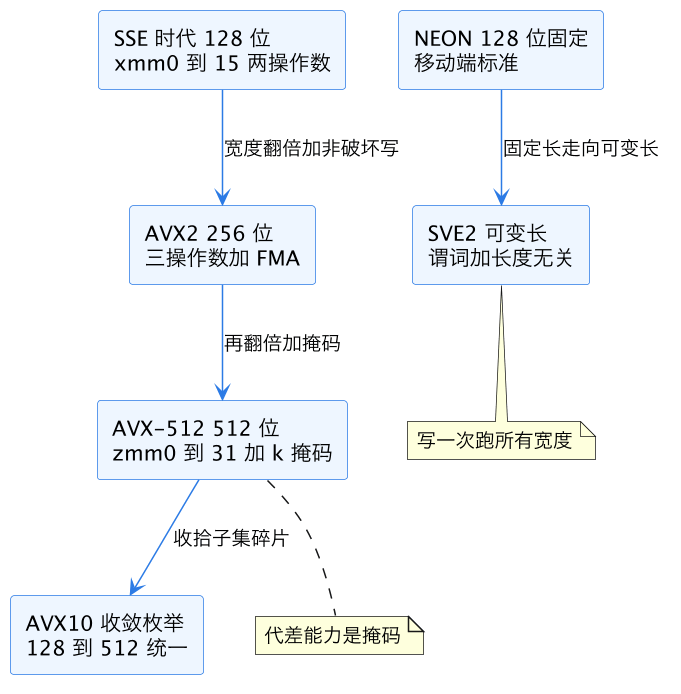
上图两条线并行:x86 线的主旋律是「加宽再加宽,然后收拾碎片」,ARM 线的主旋律是「跳出宽度本身」——SVE 让硬件决定向量长度,软件用谓词表达「处理到哪儿算完」,同一二进制在 128 位和 512 位实现上都跑满。两条线在 2020 年代交汇于同一个结论:宽度是硬件细节,掩码/谓词才是编程模型的未来。
三、执行单元的硬件组织:端口、融合与拆分
ISA 是合同,执行单元是施工队。一颗现代服务器核(以 Golden Cove / Zen 4 代际为例)通常有 4-6 个执行端口,其中 2-3 个端口挂着向量运算单元:端口 0 和端口 1 各有一套向量 ALU/FMA,端口 5 有第三套向量 ALU(常兼管洗牌 shuffle)。每套 FMA 单元的原生宽度由微架构决定——Skylake-X 是原生 512 位两个 FMA;Zen 4 的向量单元原生 256 位,一条 512 位指令被拆成两拍(double-pumping)流过同一套 256 位单元。
这个「原生宽度」的差异直接决定同一条 AVX-512 指令在不同硅片上的性价比。Skylake-X 上 vfmadd 512 位一拍出 16 个乘加,理论峰值是 256 位代码的两倍;Zen 4 上同一条指令拆两拍,峰值与 256 位代码持平——那 Zen 4 为什么还要支持 AVX-512?答案是掩码语义、32 个寄存器、单条指令编码更省前端带宽:即便峰值相同,实际内核仍常快 10%-20%。这就是「看 ISA 猜性能」容易翻车的原因:宽度决定账面,端口组织与拆拍策略决定实际。
另一个常忽略的维度是数据搬运类单元。向量内核里洗牌(shuffle)、置换(permute)、gather/scatter 往往比算术更稀缺:多数微架构只有端口 5 一套洗牌单元,而 FMA 有两三套。一个「算 4 次、洗 3 次」的算法,瓶颈会钉死在洗牌口上,算术单元再宽也帮不上忙。复块转置、矩阵小块重排、字节级解析(如 SIMD JSON)都是洗牌密集型,优化它们的方向是减少洗牌次数或改用加载时重排,而不是换更宽的 ISA。
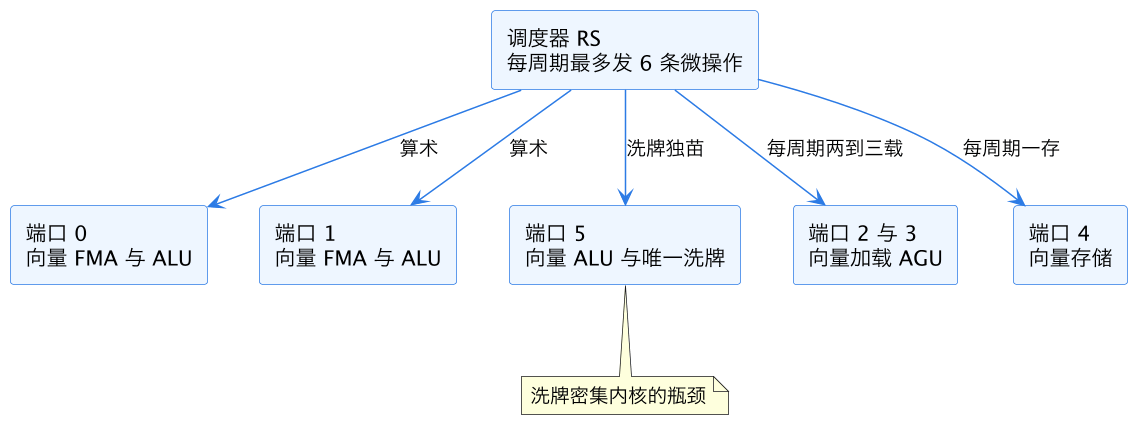
上图是现代宽核向量端口的典型分布:算术口有冗余、洗牌口是独苗、加载口比存储口宽。读一份反汇编时心里要有这张表——数一下热循环里 vperm*/vpshuf* 占几条,比数 FMA 更能预测瓶颈。向量 SIMD 执行单元 对各类单元的延迟与吞吐有逐条的计数器级数据。
寄存器重命名是另一个隐藏变量。乱序核心里物理寄存器堆远多于架构可见的 32 个 zmm,向量寄存器同样参与重命名,所以「只有 32 个向量寄存器」并不像听起来那么紧张——循环展开两三层通常还不会 spill。真正的压力来自跨指令的长依赖链:一条 512 位 FMA 延迟 4 拍、每周期能发两条,要喂满流水就需要 8 条相互独立的 FMA 在飞,这意味着算法里至少要有 8 路数据级并行(8 个独立累加器),否则再宽的单元也在等依赖。这也是「累加器展开」成为向量内核标准手法的原因——把 sum += a[i] 拆成 sum0 到 sum7 八路,最后再合并,同一个算法吞吐差出 4-8 倍。
四、掩码与谓词:向量编程的代差能力
老 SSE/AVX2 最疼的问题不是宽度,是「分支没法向量化」。循环里一句 if (x[i] > 0) y[i] = f(x[i]),向量化后必须用 blend(按位挑选)把两条路径都算一遍再按条件合并——算两遍、再洗一遍,分支稍微复杂点收益就被吃光。AVX-512 引入 8 个掩码寄存器 k0-k7(k0 特殊,表示「全开」),任何向量指令都可以带 {k1} 后缀:被掩掉的通道直接不写结果,甚至不产生访存异常。SVE 更进一步,谓词寄存器 p0-p15 是一等公民,连加载都可以带谓词——被掩掉的元素根本不发起访问,越界也不会段错误。
掩码体系带来三个结构性变化。其一,尾循环消失:处理 1000 个元素、向量宽 16,余下 8 个不再需要单独的标量尾巴,k 掩码一条指令搞定,代码体积和分支数都降。其二,条件执行零代价化:vaddps zmm0{k1}{z}, zmm1, zmm2 里被掩通道直接置零(zeroing)或保持(merging),不再需要 blend 兜底,含分支的循环第一次可以无损向量化。其三,异常语义改变:被掩掉的访存不触发缺页,这让「先按向量算、掩掉不合法通道」成为合法模式,字符串处理(strlen、memchr 的 AVX-512 版本)因此快出一大截。SVE 谓词寄存器模式 对谓词的 whilelt 生成模式有完整拆解,SIMD 向量长度无关编程 则讲了谓词如何让二进制与宽度解耦。
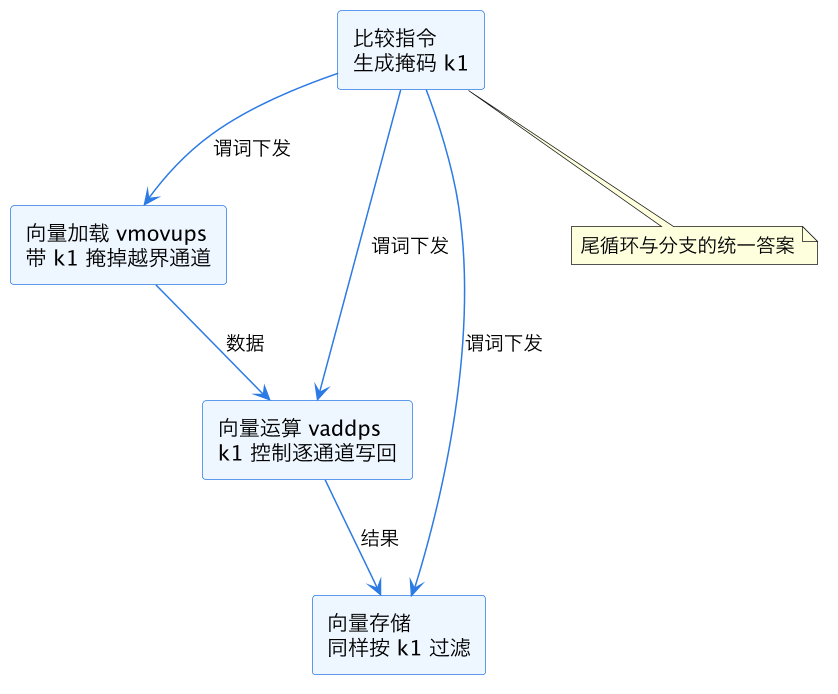
上图是掩码数据流的核心形态:比较生成掩码,掩码同时控制加载、运算、存储三个环节。记住一个细节——掩码寄存器本身也有读写端口预算,重度掩码代码里 k 寄存器的生产消费同样可能成为调度压力,但相比老 blend 路径仍然是数量级的胜利。
五、性能全景:降频、带宽与「跑不满」的真相
SIMD 性能讨论绕不开「降频」。AVX-512 降频许可 有完整机制拆解,这里给全景定位:512 位 FMA 单元满载时电流激增,电压调节器来不及补偿会引发电压跌落,为保住正确性,硬件按「许可档位」降频运行——L0 是标量/轻量指令基频,L1 是 256 位重型或 512 位轻量,L2 是 512 位重型 FMA/乘法,频率依次下探 10%-25%(代际不同差异很大,Ice Lake 之后已大幅缓和)。降频是全核共享的:一个核跑重型 AVX-512,同封装其他核的频率上限也被拉低,这就是混部场景「邻居跑向量我变慢」的来源。配套的功耗视角见 AVX 功耗病毒与频率偏移。
但比降频更普遍的真相是:多数向量内核根本碰不到功耗墙,它们先撞内存墙。以双精度浮点为例,一次 FMA 做 2 次浮点运算、消费 8 字节数据,算术强度只有 0.25 FLOP/字节;一颗 64 核服务器理论算力 3 TFLOPS 上下,而内存带宽只有 300-400 GB/s——流式负载(向量加、拷贝、规约)在几十个核上用满带宽后,单核算力再宽也只是等数据。这就是 roofline 模型的核心判断:算术强度低于拐点的代码,SIMD 优化到头也只是在更快地等内存。
真正能吃满向量单元的代码有三个共同特征:数据复用高(矩阵乘的分块让每字节进 cache 后参与几十次运算)、访存模式顺(连续流式加载吃满硬件预取)、指令组合匀(FMA 与洗牌配比贴着端口比例)。反过来,三类「伪向量化」场景要警惕:编译器报告 vectorized 但加速为零的,多半是 gather/scatter 主导(每次访存都是离散地址,比标量还慢);加速远低于宽度的,查端口 5 洗牌占比和掩码生成开销;多线程下加速反降的,查降频与带宽饱和。
| 瓶颈类型 | 典型症状 | 确诊工具与事件 | 处方方向 |
|---|---|---|---|
| 内存带宽 | 核数翻倍吞吐不翻倍 | perf 的 uncore_imc 带宽事件 | 降精度、压缩布局、分块 |
| 洗牌端口 | FMA 占比低仍跑不满 | uops_executed.port5 | 减少 permute、加载时重排 |
| gather 离散访存 | 向量化后反而变慢 | L1 miss 率与周期比 | 改数据结构为 SoA |
| 降频许可 | 单核快、全核吞吐不达预期 | turbostat 看 AVX 许可频率 | 轻重指令分离、错峰调度 |
| 掩码生成开销 | 小循环向量化收益微弱 | k 寄存器相关微操作计数 | 扩大迭代块、减少分支 |
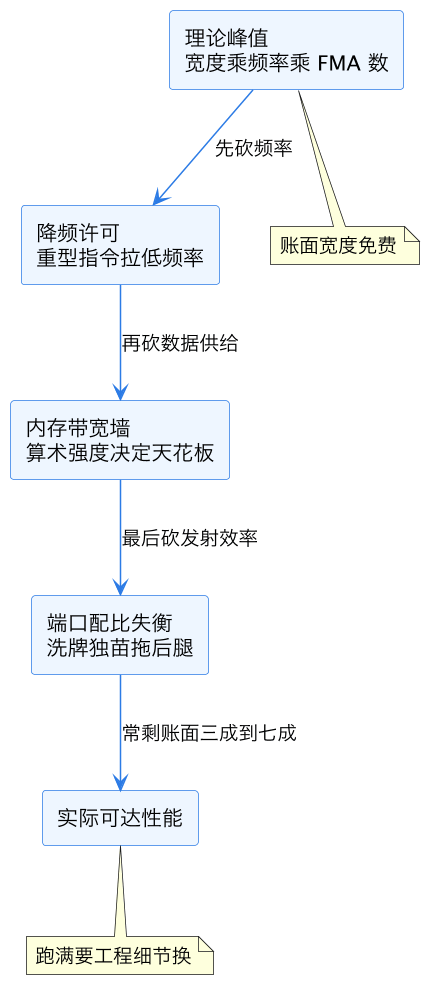
上图是 SIMD 性能的「漏斗」:从理论峰值到实际性能要经过降频、带宽、端口配比三道筛子,每一道都按负载特征收不同的税。看任何一份「AVX-512 加速 15 倍」的宣传都要先问:筛子哪一层被绕过了(通常是高算术强度的矩阵乘),以及全核满载时还是不是这个数。
降频还催生出一种调度层面的对策:轻重分离。既然重型 512 位指令会拉低全核频率,而拉低后标量代码跟着变慢,那么多租户混部机上的理性策略是把重型向量内核(视频转码、科学计算)绑到专用核组,把延迟敏感的标量请求路径隔离到另一组核——cgroup 的 cpuset 与内核的 core scheduling 都能做这件事。观察是否值得做这条隔离,先看 turbostat 报告里 AVX 许可档的驻留比例:如果重型档位驻留不到 5%,降频代价可以忽略;超过 20%,隔离的收益通常大过一个档位的频率差。
六、观测与选型:让「感觉向量化」变成「计数器确认」
工程落地的第一步永远是观测,而不是重写。确认编译器干了什么:gcc -fopt-info-vec-all 或 clang -Rpass=vector -Rpass-missed=vector 会直接报告哪个循环被向量化、哪个被拒及原因(别名不明、依赖无法证明、收益评估为负是三大拒因);objdump -d 看热循环里是 vaddps ymm 还是标量 addss。确认硬件跑得怎样:perf stat -e cycles,instructions,uops_executed.port0,uops_executed.port5 看端口分布,turbostat 看全核频率是否掉到 AVX 许可档,perf c2c 或 uncore 事件看带宽是否到顶。
选型层面的决策可以压成三步。第一步判断值不值得:这段代码占整体耗时多少(Amdahl 上限),算术强度够不够(看数据复用),分支多不多(有掩码体系就敢做)。第二步选用什么写:优先级是「编译器自动向量化 + restrict 与对齐提示」大于「intrinsics」大于「手写汇编」——自动向量化的代码能跟着新 ISA 免费升级,intrinsics 锁死在写的那代;需要跨宽度可移植时用 SIMD 库(highway、simde、std::experimental::simd)或直接采用 SIMD 向量长度无关编程 的模型。第三步定部署策略:同一进程内按 CPUID 分发多版本内核(glibc 的 ifunc 与 -march 多版本克隆是标准做法),避免用最低公共分母编译整个程序。
最后一条横切经验:SIMD 优化最大的敌人是「数据布局不顺」。结构体数组(AoS)里跨字段的向量加载天生要 shuffle,改成数组结构体(SoA)后同样算法常常不动一条指令就快 2-4 倍;对齐从 16 字节升到 cache 行 64 字节,跨行加载消失又是白捡的几个点。把布局理顺再谈指令集,是性价比排序里永远的第一位。
还有两个选型外的现实问题值得知道答案。一是「老机器没有 AVX-512 怎么办」:glibc 的 hwcaps 机制允许同一共享库放多份实现(x86-64-v2/v3/v4 目录),加载器按 CPU 能力自动挑最优版本,打包发行版时不必二选一。二是「向量化会不会改数值结果」:会——FMA 把乘加合成一次舍入,并行规约改变求和顺序,浮点结果与标量版本在末位上不同。金融与科学计算里这是要立项评估的变更,-ffp-contract=off 与 Kahan 求和是常见的止血手段;接受这一点的前提是先想清楚业务到底需要「可复现」还是「更精确」,这两者并不总是同一个方向。
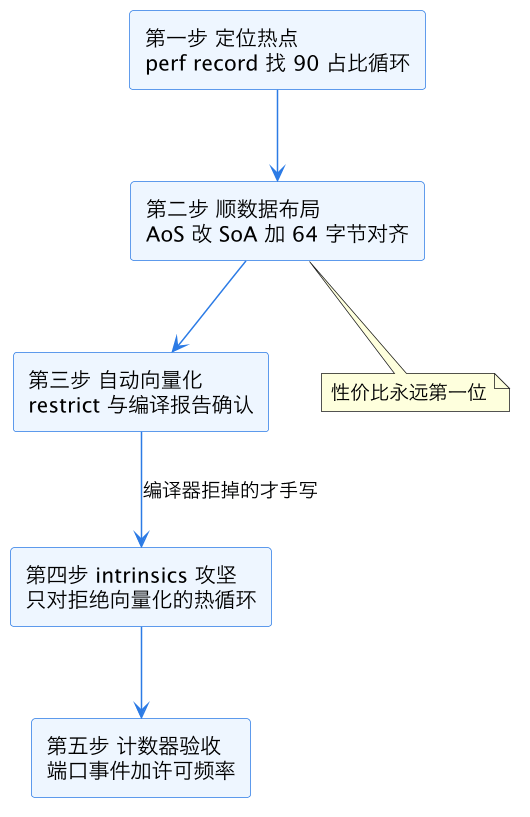
上图是 SIMD 优化的标准动线:先定位、再顺布局、然后让编译器干活、只对钉子户动 intrinsics、最后用计数器验收。绝大多数项目的向量化收益在第二步和第三步就已兑现,第四步只服务少数关键内核——反着做(上来就汇编重写)是 SIMD 项目超支的头号原因。
这一篇在知识体系里的位置
本篇是向量执行方向的枢纽:执行单元层接 向量 SIMD 执行单元 与 CPU 乱序执行,频率与功耗层接 AVX-512 降频许可 与 AVX 功耗病毒与频率偏移,编程模型层接 SVE 谓词寄存器模式、SIMD 向量长度无关编程 与 AVX10 融合向量 ISA,总览层接 CPU 微架构总览,观测手段层接 CPU 观测工具族。读完本篇再评估任何一段代码的向量化价值,都可以先问四句话:它占多少总耗时、算术强度过没过拐点、分支能不能交给掩码、编译器为什么拒绝了它。
总结
SIMD 向量执行全景的主线是三件事:ISA 三十年从 SSE 128 位一路加到 AVX-512 512 位再走向 SVE 可变长,真正的代差不是宽度而是掩码/谓词体系——它让分支与尾循环第一次可以无损向量化;硬件上向量峰值由端口组织(算术口冗余、洗牌口独苗)、降频许可(重型指令全核收税)与内存带宽(算术强度决定天花板)三道筛子共同决定,账面宽度常要打三折到七折;工程上的最优动线永远是先顺数据布局、再靠编译器自动向量化、只对钉子户动 intrinsics,并用 perf 端口事件与 turbostat 频率把「感觉变快」验收成「计数器确认」。