发射队列唤醒选择:依赖广播、仲裁与乱序核的频率墙
承 寄存器重命名 把 µop 送进保留站之后,真正决定"哪条 µop 这一拍能发"的,是发射队列(issue queue,调度器)里的**唤醒(wakeup)与选择(select)**两级逻辑。它与 保留站 的 CAM 监听、cpu-out-of-order 的数据流模型共同构成乱序核的心脏——也是几乎所有乱序核频率上不去的根本原因。
本文要回答的问题
- 发射队列里的 µop 是怎么知道"我的操作数就绪了"的?
- 唤醒和选择为什么必须挤在同一拍里,构成一个紧耦合的循环?
- 广播网络的线长与比较器数量如何随队列深度爆炸?
- 为什么调度器是乱序核的"频率墙",而不是 ALU?
- 现代 CPU 用什么工程手段(分簇调度、replay、按年龄优先)在频率与宽度之间折中?
这些问题串成一条主线:发射队列唤醒选择决定了乱序核"看得见多宽、跑得多快"的上限,理解它也就理解了为什么各家 CPU 的微架构演进几乎都绕不开调度器的重新设计。
一、唤醒选择循环:一拍之内必须干完的事
调度器的工作拆成两步:唤醒是"找出本拍之后可以就绪的 µop",选择是"从就绪的里面挑 N 条发给执行端口"。这两步构成一个循环,而且必须在一拍内闭环:
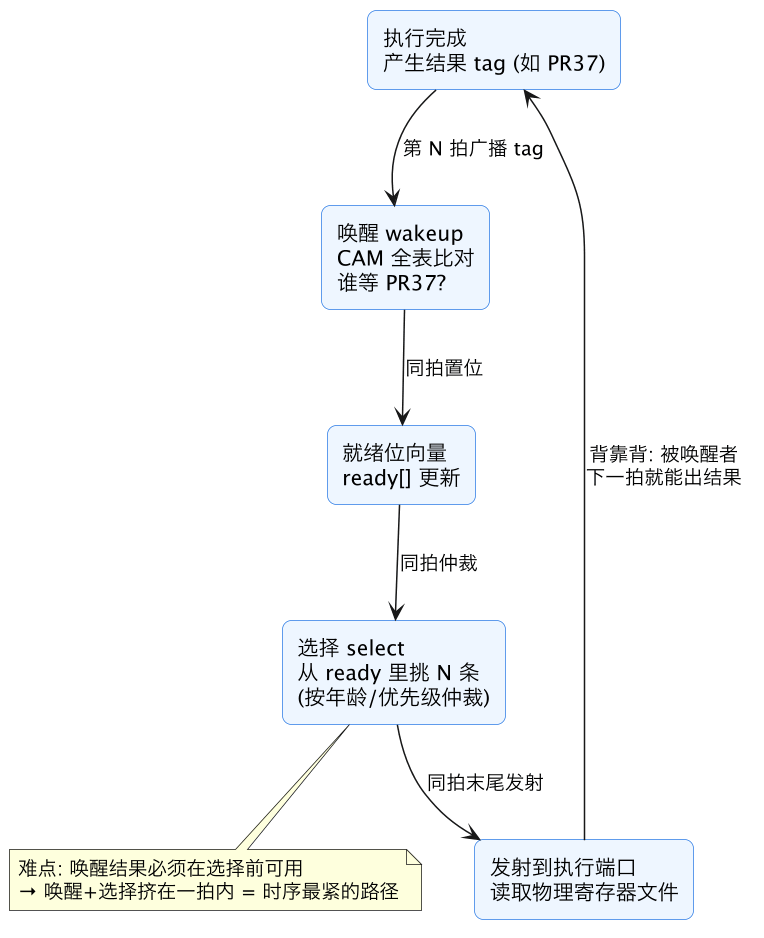
关键在"背靠背"(back-to-back)这个要求:µop A 第 N 拍算出结果,依赖它的 µop B 必须在第 N+1 拍就能进入执行单元,否则 ALU 链条中间出现气泡,连续依赖链的 IPC 直接掉一半。要做到这一点,A 的结果 tag 在第 N 拍广播的同时就要完成全队列比对、置好 B 的就绪位,B 在第 N 拍末就被选中、第 N+1 拍发射。
也就是说,唤醒和选择串行级联,且整条链的延迟预算是 1 个时钟周期。这一拍里要完成:tag 广播走线 → CAM 比对 → 就绪位 OR 树 → 优先级仲裁 → grant 信号回传。它是整个乱序核里门级数最深、线最长的路径。
一个常见的误解是把调度器想成"一个队列加个优先级电路",好像时序压力不大。但把它放进具体数字里看:Golden Cove 级别的核,整数侧有约 5 组执行端口、总计上百条在飞 µop 同时等操作数,每拍最多有 5 个结果 tag 同时广播、全部条目同时比对、然后从就绪集合里挑 5 条发射。这不是一个队列,而是一组并发运转的唤醒-选择环,每个环都被同一根时钟线掐着脖子。只要其中任何一环没能在一拍内收敛,整条流水线就得降频或者插气泡,没有第三条路。
二、唤醒:CAM 比对与广播网络
2.1 矩阵式调度器的结构
教科书式的调度器是一个内容寻址存储器(CAM,按内容而不是地址查数据的存储结构)加一个就绪位向量:
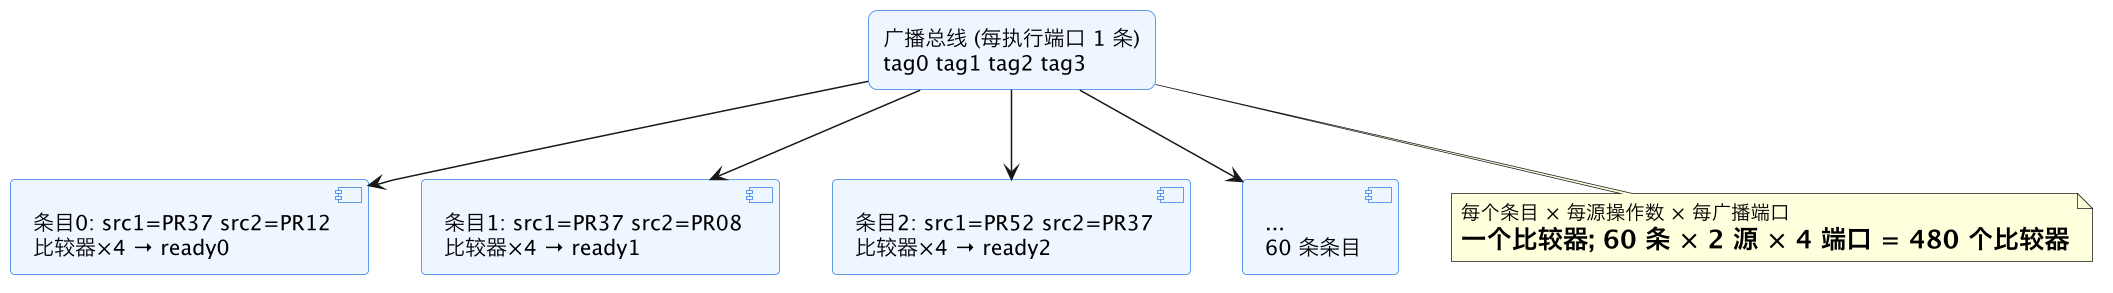
每个保留站条目里存着源操作数的物理寄存器 tag。每条执行端口完成 µop 时把自己的结果 tag 放上广播总线,所有条目的所有源槽位同时跟所有广播 tag 比较,命中就置对应的 src_ready 位。两个源都 ready,条目就绪。
这里有一个细节值得展开:tag 是物理寄存器号而不是架构寄存器号。重命名之后,每条 µop 的源操作数已经换成"我要等 PR37 这个物理槽位出值",广播总线上跑的也是 PR37 这种物理 tag。物理寄存器堆有 280 个条目(Golden Cove 整数侧约 180~280 之间),tag 宽度 8~9 位,每个比较器就是一组 8 位异或加与非树——单个比较器很小,但架不住数量。
数字一摆就能看出问题:60 条目的整数调度器、每条 2 个源操作数、4 个执行端口同时广播,需要 60×2×4 = 480 个 8-bit 比较器,比较结果再喂给就绪位逻辑。这还没算:
- 广播走线:4 条 tag 总线要物理上穿过整个 60 条的队列版图,线长随队列深度线性增长,延迟随线长平方增长(RC 延迟)。
- 电容负载:每条广播线挂在 480 个比较器输入端上,驱动它的输出级要在一拍内把这个大负载翻转到位。
- 功耗:每拍全表比对,不管命不命中,480 个比较器全部翻转,调度器是乱序核里单位面积功耗最高的模块之一。
2.2 比较器数量随宽度×深度爆炸
| 配置 | 队列深度 | 源/条 | 广播端口 | 比较器总数 | 广播线负载 |
|---|---|---|---|---|---|
| A55 级小核 | 16 | 2 | 2 | 64 | 轻 |
| Zen 2 整数 | 28×4 ALU 簇 | 2 | 4 | ~224 | 中 |
| Golden Cove 整数 | ~60×5 端口分簇 | 2 | 5 | ~600 | 重 |
| 假设 128 条统一队列 | 128 | 2 | 6 | 1536 | 不可布线的重 |
把队列从 60 条加深到 128 条、端口从 4 加到 6,比较器数量翻 2.5 倍,广播线负载和线长进一步恶化——CAM 型调度器的成本是 O(深度 × 端口数)的硬件,塞不进一拍延迟里。这就是发射队列唤醒选择被称为乱序核"频率墙"的直接原因:ALU 加一级流水线很容易,调度器的唤醒-选择环却没法随便流水化,因为流水化等于在背靠背依赖链里插气泡。
三、选择:仲裁器的优先级与矩阵
唤醒完之后,就绪的 µop 可能有 10 条,执行端口只有 4 个——选择逻辑要在一拍内挑出"最该发的"4 条。最经典的方案是按年龄优先(oldest-first):队列条目按分配顺序有隐含的年龄序,先发老的能最快释放 ROB 头部、推动退休,也天然避免饥饿。
实现上常用位置矩阵(position matrix):一个 N×N 的位矩阵,第 i 行第 j 列表示"条目 i 比条目 j 老"。选择时先对就绪位向量做优先级编码,再用矩阵找出最老的就绪条目;选掉它之后用剩余的就绪位再找第二老的,直到选满 N 个端口。
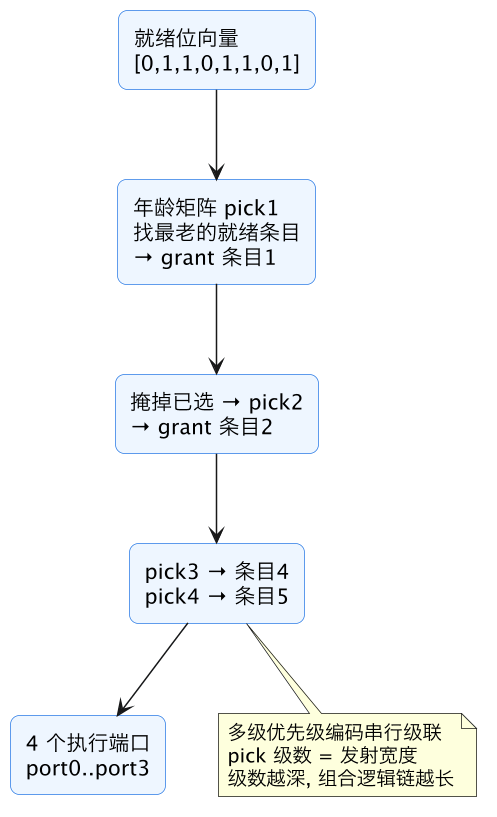
问题同样明显:pick 级数等于发射宽度。4 宽发射要串 4 级"编码-掩码-再编码",每一级都是几十条目的优先级逻辑,这条链叠在唤醒逻辑后面,进一步挤压一拍的时序预算。工程上的缓解手段包括:
除了纯时序问题,按年龄优先还有一个常被忽略的副作用:它假定"老 µop 先退休"总是最优。遇到 load miss 卡住的老 µop 时,按年龄优先会把发射槽让给它身后已就绪的年轻 µop,这没问题;但如果 miss 的老 µop 的依赖者在队列里占了一大片,队列被"等一个不回来的人"填满,选择逻辑再怎么聪明也挑不出能发的条目——这就是后面第五节要讲的"发射队列满导致前端停摆"。
- 树形/并行仲裁:把串行 pick 改成二叉树归约,深度从 O(宽度) 降到 O(log),但面积和布线膨胀。
- 分簇调度器:按执行端口把队列拆成多个小簇(ALU 簇、AGU 簇、FPU 簇),每簇自己的唤醒-选择环更小更快;代价是 µop 入队时要猜它去哪个簇,簇间负载不均会浪费发射槽。
- 确定性时序 + replay:调度器假设 load 一定命中 L1(4 拍延迟),按这个假设提前唤醒依赖者;真 miss 了就 replay 重来。省去了"等 load 返回再唤醒"的不确定延迟,但 miss 时浪费发射带宽。
四、频率墙:为什么 5GHz 的核不敢把队列做深
把前面几节串起来,时序账是这样的:一拍 3GHz 是 333ps,5GHz 只剩 200ps。这条预算里要塞下:tag 广播走完整条队列版图的 RC 延迟 + CAM 比对 + 就绪位汇聚 + 2~4 级仲裁 + grant 回传 + 触发器建立时间。队列加深到 128 条,版图边长大约翻一倍,广播线 RC 延迟按平方恶化,仲裁的优先级逻辑宽度也翻倍——单靠工艺进步吃不下这个增长。
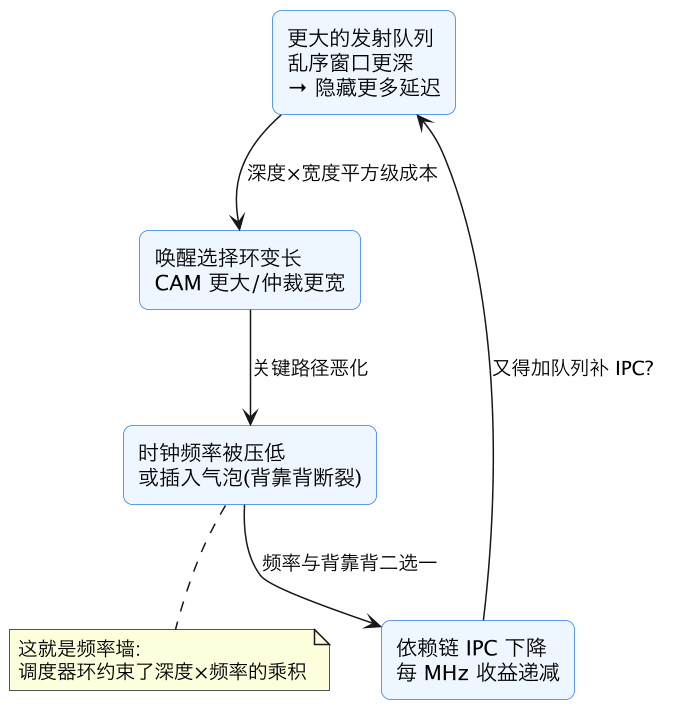
真实的工程取舍都长这样:Golden Cove 把整数调度器做成 5 个分簇小队列而不是一个 97 条大统一队列;Apple 的 Firestorm 用确定性时序 + replay 把唤醒路径做短,换取 3.2GHz 下 8 宽发射;IBM POWER 走另一条路,调度器两拍循环、接受依赖链多一拍延迟,换 5GHz+ 的频率。没有谁是免费的——发射宽度、队列深度、时钟频率、背靠背延迟,四个指标你最多同时占三个。
还有一个方向是干脆绕开 CAM:有些研究型和嵌入式核用先入先出队列加分发逻辑代替全比对调度器,编译器负责静态排好序,硬件只按序弹出——唤醒逻辑整个消失,频率和功耗都好看,代价是动态适应能力归零,遇到 cache miss 这种只有运行时才知道的延迟立刻露馅。这也是"调度器放硬件还是放软件"这条老争论(VLIW 对超标量)在新时代的回响:硬件调度器贵,但它买的是对动态延迟的容忍度,而动态延迟恰恰是现代存储层次里最不可预测的部分。只要内存墙还在,CAM 型唤醒选择就还得在频率墙上硬扛。
五、对软件与调优的意义
调度器硬件规则写死了,软件侧能做的是让µop流更"调度器友好":
| 现象 | 调度器视角的原因 | 软件对策 |
|---|---|---|
| 长依赖链 IPC 锁死在 1/链长 | 背靠背唤醒是唯一能 1 拍跟进的机制,链上一环卡就全链等 | 拆依赖链:多个累加器、软件流水 |
| load miss 后 IPC 骤降 | 确定性时序调度器 replay 浪费发射槽,相关 µop 全被重发 | 数据局部性、预取,减少 L1 miss |
| 端口争抢导致 µop 滞留 | 选择逻辑按年龄挑,但端口是稀缺资源 | 指令混合:ALU/load/store 交错,别全是同一端口 |
| 发射队列满导致前端停摆 | 队列深度就是窗口,塞满了 rename 只能停 | 减少长延迟未决操作(除法、miss load 的依赖者别堆太多) |
观测上,perf stat -e resource_stalls.sb,rs_events.empty_cycles 一类事件能侧面反映调度器压力;Intel 平台上 Top-down 方法的 "Core Bound" 细分项本质上就是在问"µop 是卡在调度器里发不出去,还是发出去执行得慢"。
再往深一层,编译器其实一直在替调度器打工。指令调度(instruction scheduling)这个编译器 pass 的核心目标之一,就是把互相独立的指令交错排布、把长延迟指令的结果使用点尽量推后——硬件调度器的窗口有限(几十到上百条),编译器的"窗口"是整个基本块乃至循环体,两者配合才能把 ILP 真正榨出来。手写汇编调优时也是同一个思路:看到反汇编里一长串首尾相接的依赖链,就该意识到这条链会锁死 IPC,任何调度器都救不了。
最后提醒一个测量上的坑:发射宽度不等于实际吞吐。8 宽发射的核跑普通整数代码, sustained IPC 往往在 3~4 之间,因为依赖链、端口冲突、load/store 混合比都在限制选择逻辑每拍能挑出的条目数。拿"峰值发射宽度"当性能预期,是看了广告没看说明书。
这一篇在知识体系里的位置
本篇与 保留站 是同一模块的两面:保留站讲"µop 住在哪里、等什么",本篇讲"谁把它叫醒、怎么挑它出门"。上游依赖 寄存器重命名 分配的物理 tag——没有 tag 就没有广播比对的对象;下游衔接 rob——按年龄选择推进退休进度,发射出去的 µop 最终在 ROB 里按序提交。宏观定位见 cpu-out-of-order 的乱序五大部件图,本篇对应其中"调度/发射"一环的时序深挖。
总结
发射队列唤醒选择是乱序核里延迟预算最紧的一拍:结果 tag 一拍内广播全队列、CAM 全表比对唤醒依赖者、仲裁器再从就绪集合里按年龄挑出 N 条发射——CAM 成本随"深度×端口数"平方级增长、仲裁链随发射宽度加深,所以调度器而不是 ALU 成了乱序核的频率墙;工程上用分簇队列、确定性时序加 replay、并行仲裁在宽度、深度、频率、背靠背延迟四个指标里取舍,软件侧则靠拆依赖链、保数据局部性、混合端口压力来配合它。