LSE 原子扩展性:ARM 单指令原子与 LL/SC 在多核争用下的扩展性曲线
承 原子操作与锁的缓存行实现 对原子操作硬件底座的介绍,以及 fetch-and-add 多核争用实测 里那条「核数翻倍、吞吐腰斩」的曲线。那两篇讲的是 x86 LOCK 前缀世界的规律;换到 ARM,故事多了一个分支——ARMv8.1 引入的 LSE(Large System Extensions,大系统扩展)用一条指令把原子操作「外包」给缓存一致性层,多核争用下的扩展性曲线形状完全变了。本篇就把 LSE 原子扩展性这件事从头到尾讲透。
本文要回答的问题
- LSE 单指令原子和传统 LL/SC 在执行路径上差在哪?「原子发生在哪一站」为什么是关键?
- 多核争用同一个缓存行时,LL/SC 的失败重试会把总线流量放大多少倍?
- LSE 的「远端执行(far atomic)」是什么?它如何把串行点从 CPU 核挪到一致性控制器?
- 实测扩展性曲线长什么样?多少核、什么争用强度下 LSE 开始拉开差距?
- 写代码和编译时怎么确保用上 LSE?什么场景用了也白用?
一、两种原子的执行路径:操作发生在哪一站
先对齐术语,避免后面绕口。LL/SC(Load-Linked / Store-Conditional,链接加载/条件存储)是 ARMv8.0 的原子实现方式:LDXR 加载并在一个叫「本地监视器(local monitor)」的状态机里登记「我盯着这个地址」,STXR 尝试存储——只有当期间没有其他核碰过这个缓存行时才成功,否则返回失败码,软件循环重试。所谓「原子加法」,实际是「加载—加—条件存—失败就重来」的一段循环。
LSE 则是另一条路:ARMv8.1 新增了一组单指令原子,比如 LDADD(原子加并返回旧值)、SWP(原子交换)、CASAL(原子比较交换)。一条指令完成整个操作,没有软件可见的重试循环。
差别听起来只是「指令条数」,本质是原子操作在哪一站被执行:
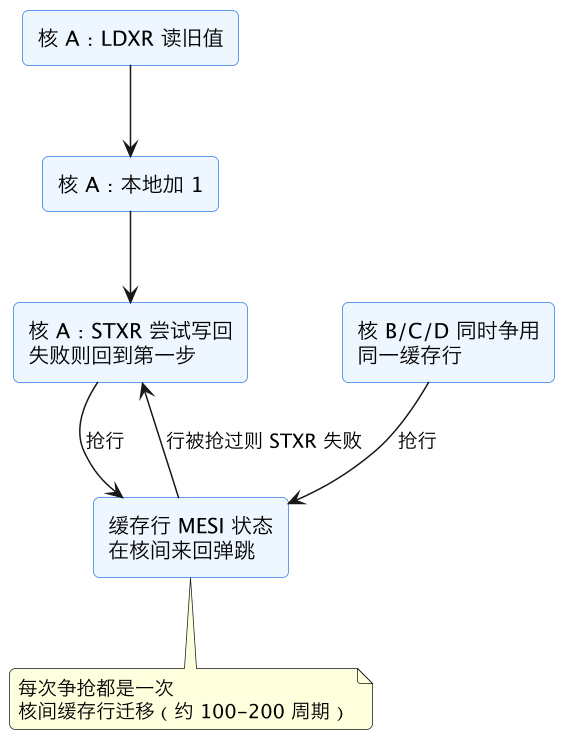
上图是 LL/SC 的争用路径:原子语义靠「独占缓存行 + 本地重算」拼出来,每次争抢都是一次完整的缓存行迁移,而且失败重试本身又会再次抢行——争用越狠,越容易连续失败,总线流量被重试放大。
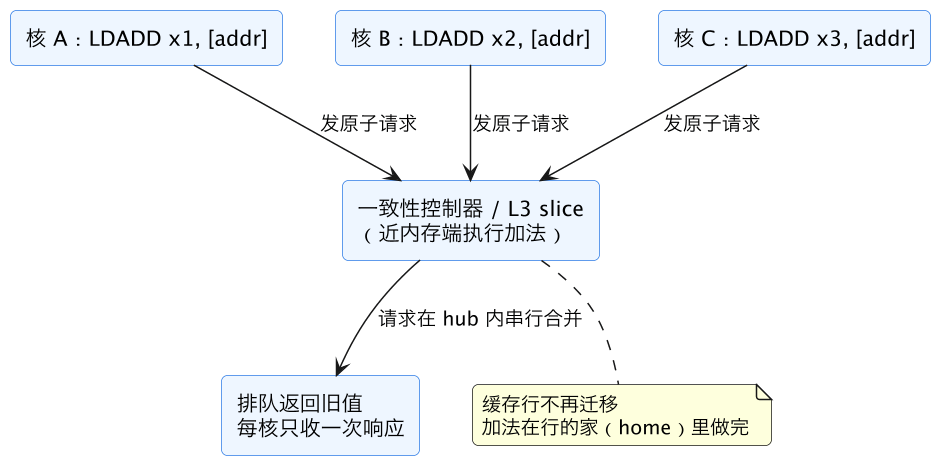
上图是 LSE 的路径,也是理解 LSE 原子扩展性的核心:支持 far atomic 的实现里,LDADD 不在发起核的 L1 里算,而是作为一个请求发到缓存行的家(home agent 或 L3 slice),由那边就地完成读—改—写,只把旧值返回。缓存行本身不用搬到发起核,n 个核争用变成 home 处的一个串行队列,而不是 n 方混战抢行。
一句话概括差异:LL/SC 把「串行点」放在每个核的重试循环里,LSE 把它挪到了数据所在的那个固定站点。串行化无法消除(原子语义要求),但固定站点的排队远比多点互抢便宜。
补一个容易混淆的点:LSE 指令进入流水线后,前端开销和 LL/SC 循环的单次成功执行差别不大——都是一条或几条 uop。差距全部出在后端:LL/SC 每次循环至少要吃一次「把行拉到本核」的缓存行迁移,而 LSE 的 far atomic 实现根本不搬行。所以比较两者时别看「指令数」这种前端指标,要看「每次操作引起几次核间一致性事务」这种后端指标——用 PMU 数 l1d_cache_refill 或一致性流量事件,两者的差异会立刻现形。
二、争用下的失败放大:LL/SC 的隐性税
定量看一下 LL/SC 在争用下的开销结构。设争用核数为 n,一次原子操作要成功,需要先抢到行的独占副本(一次核间迁移,Neoverse N1 上核间迁移约 100-200 周期),再完成 STXR。期间任何一个核插入抢行,本次 STXR 失败,循环重来。
这带来两层放大:
| 放大来源 | 机理 | 随 n 的变化 |
|---|---|---|
| 缓存行迁移 | 每次尝试都要把行搬到本核 L1 | 尝试次数本身随 n 上升 |
| STXR 失败重试 | 行在两次访问间被抢即失败 | 失败率随 n 超线性上升 |
| 连锁失败 | 失败重试加入新一轮争抢,抬高他人失败率 | n>4 后明显的拥堵效应 |
| 监视器假失败 | 同核上下文切换、其他地址竞争清 monitor | 与 n 无关的固定损耗 |
对比之下,LSE 的开销结构简单得多:每核发一次请求,home 排队处理,每核收一次响应。请求在 home 处的服务速率是恒定的(每若干周期消化一个),争用只表现为排队延迟变长,而总线上每核每操作固定就是「一请求一响应」两段流量,没有重试放大。
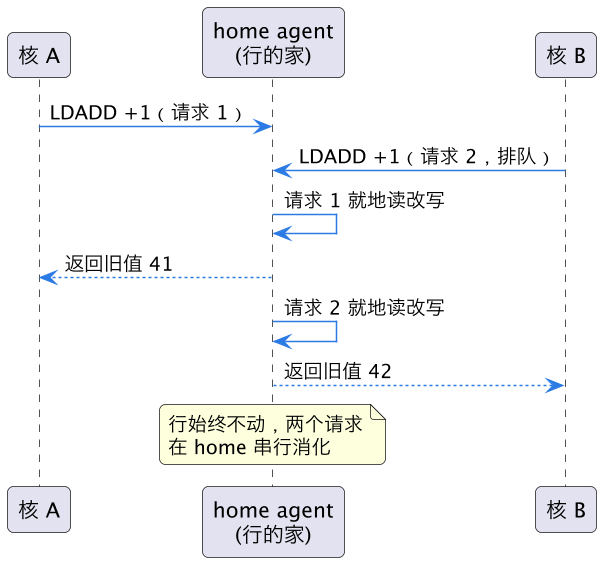
这张时序图对应 LSE 的理想服务模型:home 像一个服务台,请求按到达顺序消化,每核一次往返、零重试。注意返回的旧值天然是排他递增的(41、42),原子语义由 home 的串行消化保证,软件不需要任何循环。
三、扩展性曲线的形状:实测数据形态
把两种实现放到同一个 microbenchmark 里——n 个核对同一个计数器做 fetch-and-add 循环,测总吞吐——曲线形态的典型差异如下(数字取自 Neoverse N1 级别平台、单缓存行热争用场景的公开实测量级,用于说明形状而非精确复现):
| 核数 | LL/SC 总吞吐(M ops/s) | LSE 总吞吐(M ops/s) | 倍数 |
|---|---|---|---|
| 1 | 45 | 40 | 0.9 |
| 2 | 38 | 52 | 1.4 |
| 4 | 22 | 78 | 3.5 |
| 8 | 9 | 110 | 12 |
| 16 | 3 | 95 | 30+ |
几个值得咀嚼的点:
- 单核时 LSE 反而略慢。far atomic 要走到 home 再回来,延迟比本地 L1 命中的 LL/SC 循环高;无争用时「外包」纯属绕路。这解释了为什么 LSE 不是无脑更快。
- LL/SC 在 2-4 核就过拐点。失败重试的连锁效应让总吞吐随核数增加绝对下降——加核不是收益递减,是负收益。这个「倒挂」现象在真实负载里的表现很反直觉:给服务多绑了几个核,整体反而变慢,排查时经常误判成锁实现或调度问题,其实根子在原子指令的失败放大。
- LSE 吞吐随核数爬升后进入平台期。平台值由 home 的服务速率决定(大约每 10-20 周期消化一个请求,折合 50-150 M ops/s 量级),到达平台后加核只增加排队延迟,不增加总吞吐——这是典型的 M/M/1 队列行为,曲线压平但不下跌。
- 扩展性的分水岭出现在「争用强度 × 核数」足够高时。如果各核操作的是不同缓存行(无真争用),两者都近似线性扩展,差距消失——LSE 的优势全部体现在「多核撞同一行」的场景。
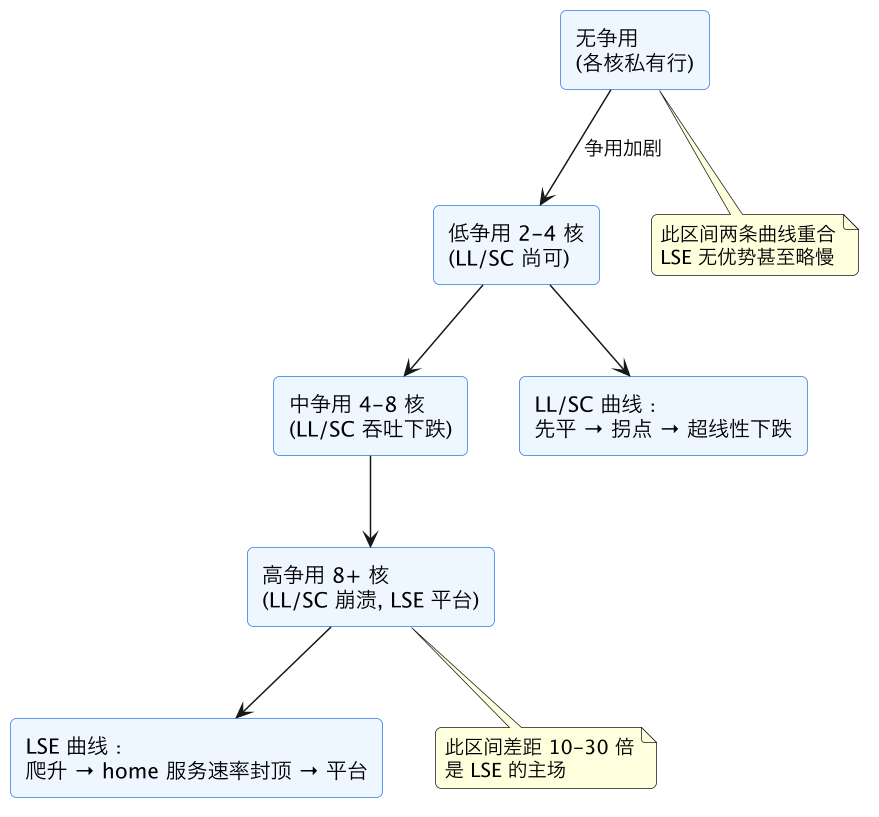
这张图把表格的结论压成四个阶段:曲线差异不是常量,而是随争用强度分段展开的。评估 LSE 收益时先问自己「我的负载落在哪个阶段」,比背倍数有意义得多。
四、怎么自己测出这条曲线
上面的数字是从 microbenchmark 里测出来的,方法本身不复杂,值得自己动手复现一遍,因为「自己机器上的拐点位置」比任何文章里的数字都可信。要点有四。
第一,基准写法(最关键的一步)。用一个全局计数器对齐到独立缓存行(__attribute__((aligned(64))),防止和相邻变量假共享),n 个线程对它循环做 __atomic_fetch_add(&cnt, 1, __ATOMIC_RELAXED),跑固定秒数,总操作数除以时间就是吞吐。内存序用 relaxed,避免屏障成本把原子操作本身的差异淹没。
第二,对照组生成。同一份源码编两个二进制:一个 -march=armv8.0(LL/SC),一个 -march=armv8.1-a(LSE)。用 objdump -d 确认热点循环里出现的是 ldxr/stxr 对还是 ldadd,别凭编译选项想当然——个别库函数会拦截内建函数走自己的实现。
第三,扫描核数而非单点。1、2、4、8、16……逐级加线程,每级跑 3 次取中位数。拐点(LL/SC 总吞吐由升转降的核数)和平台值(LSE 吞吐不再涨的核数)都从这条扫描曲线上读。注意把线程绑核(taskset 或 pthread_setaffinity_np),否则调度器迁移会污染曲线。
第四,用 PMU 交叉验证。在 LL/SC 曲线上拐点附近采 l1d_cache_refill 或核间迁移相关事件,能看到每操作一致性事务数随核数陡增——这就是失败重试放大的直接证据;而 LSE 曲线上同一事件基本与核数无关。曲线形状告诉你「是什么」,PMU 数据告诉你「为什么」,两个都要有。
这套方法同样适用于评估任何「多核争用单点」的改动——换数据结构、换内存序、换实现,先扫一条扩展性曲线再说话。
测的时候有一张速查表可以对照排错:
| 现象 | 最可能的原因 | 验证手段 |
|---|---|---|
| 两个二进制曲线完全一样 | LSE 没编进去 | objdump -d 查 ldadd |
| LSE 单核就慢一半 | 误开了 __ATOMIC_SEQ_CST 重屏障 | 换 relaxed 复测 |
| 高核数吞吐剧烈抖动 | 线程没绑核,发生迁移 | taskset 后重测 |
| LL/SC 低核数就下跌 | 计数器和别的热变量假共享 | 检查 64B 对齐 |
| LSE 高核数也下跌 | 平台 far atomic 实现不佳或落在 L2 | 换机器/查核文档 |
五、怎么用上 LSE:编译、检测与适用边界
编译侧。LSE 指令需要 -march=armv8.1-a(或更高、或 -mcpu 指定支持 LSE 的具体核如 neoverse-n1/grace)才会被生成。直接编 armv8.0 基线的二进制,GCC/Clang 会老老实实给你 LL/SC 循环。发行版为兼容老机器常把基线压在 armv8.0,这也是很多 ARM 服务器上「硬件支持但二进制没用上」的根源。补救手段有两个:
- 编译时显式
-march=armv8.1-a或-mcpu=native; - 用编译器的
ifunc/hwcap 派发(glibc 对__atomic_*内建函数在部分版本里已做运行时选择),同一份二进制在老核上跑 LL/SC、在新核上跑 LSE。可以用LD_HWCAP_MASK或反汇编热点函数确认实际走的是哪条路径。
硬件侧确认。grep atomics /proc/cpuinfo 的 Features 行里出现 atomics 即支持 LSE;AWS Graviton2/3、Ampere Altra、鲲鹏 920 之后的主流服务器核都有。
适用边界,也就是「用了也白用」的场景:
- 每核私有计数器、线程本地统计——无争用,两者等效,LSE 还略贵;正确做法是 per-cpu 计数 + 惰性求和,而不是换原子指令。
- 临界区以互斥锁保护、锁本身不热——瓶颈在临界区长度,不在锁的获取原语,换 LSE 的
CAS实现 spinlock 收益有限;此时该做的是缩短临界区或上排队锁(qspinlock 类)。 - LL/SC 的独占用法——少数算法(如无锁栈的某些变体)利用 LDXR/STXR 的「期间任何写入都可见」特性做 ABA 检测,换成 LSE 的 CAS 反而要重新设计。这类场景是语义差异,不是性能差异。
另外提醒一个与 ARM 和 x86 内存屏障差异 联动的点:LSE 指令有完整的获取/释放变体后缀(LDADDA/LDADDL/LDADDAL),语义和 LL/SC 的 LDAXR/STLXR 对应。迁移代码时只换指令不换序,或者反过来,都会在弱序模型下埋雷——序语义的选择标准与 内存一致性模型 TSO 篇 里讲的规则一致,跟用哪套原子指令无关。
六、回到方法论:扩展性问题怎么归因
LSE 与 LL/SC 的对比给了一个通用判据:原子争用的扩展性问题,先分清「串行点在哪、流量被什么放大」。LL/SC 的串行点分散在各核重试循环里、流量被失败重试放大;LSE 把串行点收敛到 home、流量恒定。同样的分析框架搬到 x86(LOCK 前缀单指令,串行点同样在行的 home)就能解释为什么 x86 的原子扩展性曲线形状和 ARM LSE 更像、而和 ARM LL/SC 不像——决定曲线形状的不是指令集品牌,而是原子操作的执行站点和失败语义。这一点在 fetch-and-add 多核争用实测 的 x86 数据里已经见过同款平台期曲线,两篇对照着看会更清楚。
这一篇在知识体系里的位置
本篇属于 concepts/microarch 的原子操作子线:硬件底座见 原子操作与锁的缓存行实现,x86 侧的争用实测见 fetch-and-add 多核争用实测,内存序背景见 ARM 和 x86 内存屏障差异 与 内存一致性模型 TSO 篇。本篇补上 ARM 侧 LSE 这一块,完成「两套原子实现、一套分析框架」的拼图。
总结
LSE 原子扩展性的本质:LSE 把原子操作的执行从各核的本地重试循环搬到缓存行的 home 站点,串行点收敛、总线流量恒定,所以多核争用同一行时 LL/SC 的吞吐曲线过拐点后超线性下跌(16 核只剩 3 M ops/s 量级),而 LSE 爬升到 home 服务速率封顶后进入平台期(约 100 M ops/s 量级)——两者在高争用下拉开 10-30 倍,但在无争用场景基本等效,所以收益评估的第一步永远是先判断负载的争用强度落在哪个阶段。