栈引擎:专用加法器如何消除 PUSH/POP/CALL/RET 对 RSP 更新的串行化
更新时间:2026-10-04。本篇是微架构模块「乱序执行线」上的一小块拼图,讲的是 Intel 从 Pentium M 时代引入、沿用至今的栈引擎(Stack Engine)。它专管一件事:让
PUSH、POP、CALL、RET这四类最依赖栈指针的指令,不再为了更新 RSP 而排队串行执行。理解它之前需要两块背景:寄存器重命名怎么消假依赖(见 寄存器重命名),以及CALL/RET的返回地址靠哪块结构预测(见 返回地址栈 RAS)。它和 move 消除与零惯用法 是同一设计哲学的两个案例:在前端就把「不用真执行」的工作消化掉。全景见 CPU 微架构总览。
本文要回答的问题
- 没有栈引擎时,一串连续的
PUSH/POP为什么会退化成串行执行? - 栈引擎的专用加法器和「推测偏移」具体怎么工作?
PUSH、POP、CALL、RET四类指令各自吃到什么优化?- 推测错了怎么办?栈引擎的恢复与「同步微码」是什么?
- 它对真实代码(函数序言、频繁小函数调用)有多大收益,怎么观测?
一、问题:RSP 是 x86 上被「写」得最频繁的寄存器
先看一段再普通不过的函数序言和尾声:
push rbp
push rbx
push r12
sub  rsp, 32
; ... 函数体 ...
add  rsp, 32
pop  r12
pop  rbx
pop  rbp
ret在程序员眼里这只是八条指令。但在乱序引擎眼里,它埋着一条致命的串行链:PUSH rbp 要先把 RSP 减 8 再写内存;PUSH rbx 依赖上一条的新 RSP,再减 8 再写;PUSH r12 又依赖再上一条……三条 PUSH 的 RSP 更新构成一条真依赖(RAW,Read After Write)链,每条一拍加法,外加把 RSP 从旧物理寄存器重命名到新物理寄存器的开销。如果按常规乱序处理,每个 PUSH 都要走一遍「读旧 RSP → 加 -8 → 写新 RSP」的完整执行流程,宽度 6 的机器在这条链上只能跑出 1 IPC。
关键在于:这些加减法的「结果」在解码时刻就全知道了。PUSH 一定是 -8,POP 一定是 +8,CALL 是 -8 附带一次存储和一次跳转,RET 是 +8 附带一次加载和一次间接跳转。根本不需要等执行单元,前端解码时就能算出每条指令看到的 RSP 值。这正是栈引擎存在的全部理由——重命名机制能消掉假依赖(见 寄存器重命名 RAT 与 RRF),但 RSP 链上的依赖是真的,只能靠「提前算好」来消。
上图是问题的骨架:没有栈引擎时,五条栈指令在 RSP 上串成一条不能并行的链。每环延迟虽然只有一拍加法,但链长等于栈指令条数,且每环都要占用发射端口和重命名带宽——而这些指令里真正「干活」的部分(压栈的存储、出栈的加载)本来可以全部并行。
二、栈引擎的结构:一枚专用加法器加一个推测偏移
栈引擎在微架构里的位置很靠前:它挂在重命名阶段(rename),紧邻追踪栈指针的那部分 RAT(Register Alias Table,寄存器别名表)。它的核心只有两样东西:
- 一枚专用加法器:只算 RSP 的加减,位宽 64 位,操作数永远是 8 的倍数。不占任何通用执行端口。
- 一个推测偏移寄存器(ESPOF,或者叫 ESP delta):记录「从前端看到的逻辑 RSP」与「重命名表里当前 RSP 物理寄存器的值」之间的累计差值。
工作方式用一个例子讲最清楚。假设进入函数时 RSP 的物理寄存器值是 0x8000,前端连续解码出三条 PUSH:
- 第一条
PUSH:栈引擎算出它使用的 RSP 是0x8000 - 8,把 -8 记进偏移;这条指令被改写成「以旧 RSP 加偏移 -8 为地址的存储」,不再需要等执行单元更新 RSP。 - 第二条
PUSH:偏移累计到 -16,指令使用0x8000 - 16。 - 第三条
PUSH:偏移累计 -24,使用0x8000 - 24。
三条 PUSH 的存储地址在重命名阶段就全部确定,彼此零依赖,可以同周期并行发射到任意空闲的存储端口。RSP 的新值(0x8000 - 24)由栈引擎的专用加法器顺手算出,写进重命名表,供后续非栈指令引用——同样不占执行端口。这就是「消除串行化」的准确含义:不是让加法变快,而是让加法从关键路径上消失。
上图里最重要的一条边是栈引擎到「存储和加载微操作」的那条:偏移直接参与地址计算,意味着栈指令之间不再有数据依赖。乱序引擎收到的已经是「地址确定的存储」,和普通的 MOV [rax], rbx 没有区别,可以满宽度并行。
三、四类指令的不同吃法
栈引擎对四类指令的处理并不对称,值得逐一看。
PUSH reg:拆成「RSP 调整 + 存储」两个动作时,RSP 调整被栈引擎完全吸收,只剩一个存储微操作下发到乱序引擎。这是最干净的情形。
POP reg:对称地只剩一个加载微操作。连续 POP 之间同样零依赖,可以并行发射——这一点对函数尾声密集的代码(比如尾调用链、异常展开)收益很大。
CALL rel:栈引擎负责返回地址压栈的 RSP 调整部分;返回地址的计算(RIP 加指令长度)在前端已知,也不用等执行。真正的跳转预测交给 BTB(Branch Target Buffer,分支目标缓冲),见 分支预测。
RET:这是最微妙的一条。RET 的 RSP +8 调整被栈引擎吸收,弹出的返回地址作为加载下发,但取指端根本不等这个加载——它直接信 RAS(Return Address Stack,返回地址栈)顶上的预测值继续取指,加载结果稍后用于校验,细节见 返回地址栈 RAS。所以一条 RET 在理想的推测路径上几乎是「零成本」的:RSP 由栈引擎调,目标由 RAS 猜,两个专用硬件各管一半。
| 指令 | 栈引擎吸收的部分 | 下发到乱序引擎的部分 | 配套专用硬件 |
|---|---|---|---|
| PUSH reg | RSP 减 8 | 一个存储微操作 | 无 |
| POP reg | RSP 加 8 | 一个加载微操作 | 无 |
| CALL rel | RSP 减 8 与返回地址存储的地址计算 | 存储微操作与跳转 | BTB |
| RET | RSP 加 8 | 加载微操作与间接跳转校验 | RAS |
这张表也说明了为什么栈引擎常被拿来和 RAS 放在一起讲:它们一个管「栈指针」、一个管「栈内容」,合起来把 CALL/RET 这对指令的全部开销摊到推测路径上。和 move 消除与零惯用法 对比就更清楚——那篇讲的是重命名阶段消化「寄存器搬家」,本篇讲的是重命名阶段消化「栈指针算术」,都是把执行从关键路径挪到前端特例逻辑。
四、推测的代价:同步微操作与恢复
栈引擎的偏移追踪是推测性的,而推测总会遇到要「对账」的时刻。
第一种时刻:非栈指令显式读 RSP。比如 MOV rax, rsp 或 LEA rax, [rsp+16]。这时逻辑 RSP 必须是「物理寄存器值加当前偏移」的准确结果。处理办法是栈引擎在重命名阶段插入一个同步微操作(sync uop):用那枚专用加法器把累计偏移真正结算进 RSP 的物理寄存器,偏移清零,后续指令直接读物理寄存器。这个微操作要真下发射行一次,所以「栈指令中间夹一条读 RSP」的代码会打断连续的快路径——编译器通常把序言里的栈指令聚拢排放,就是为了少触发同步。
第二种时刻:分支误预测冲刷。栈指令流被冲刷时,偏移寄存器里可能还挂着没结算的增量。恢复靠重命名阶段的检查点(checkpoint)机制:每次分支预测都会给 RAT 拍快照,栈引擎的累计偏移也在快照里,误预测时随 RAT 一起回滚,见 重命名检查点与分支恢复。这也是为什么栈引擎必须和 RAT 紧挨着——它的状态就是 RAT 状态的一部分。
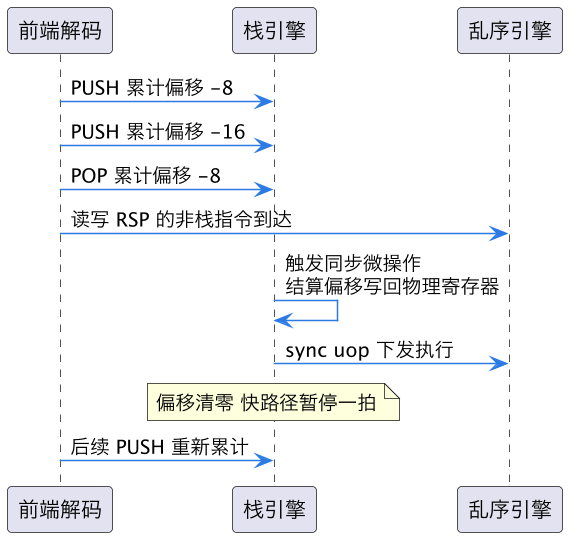
上图画出了同步微操作的触发点:非栈指令读 RSP 的瞬间,推测必须落地。理解了这个机制,就能解释一个实测现象——把 PUSH x3; MOV rax, rsp; POP x3 和 PUSH x3; POP x3; MOV rax, rsp 两种写法在循环里各跑一亿次,后者稳定快出几个百分点,差的就是那一拍结算。
五、收益量化与观测方法
栈引擎的收益集中在两类代码上:函数调用密集(小函数、深调用链)和寄存器压力高(序言尾声保存恢复大量 callee-saved 寄存器)。量级感受:
- 一条
PUSH在没有栈引擎的假设下约占「1 拍加法串行 + 1 个 ALU 微操作」;有栈引擎后只剩 1 个存储微操作。一个保存 6 个寄存器的序言,省下的就是 6 拍串行链和 6 个端口发射机会。 - 调用密集的解释器、递归解析器这类负载里,栈指令能占动态指令数的 10% 以上,栈引擎对 IPC 的贡献在个位数百分点,但在「本来会被串行化卡死」的极端序言块里局部收益可以翻倍。
观测手段上,PMU 没有直接叫「stack engine」的计数器,但有两个间接窗口:一是 UOPS_EXECUTED 与 UOPS_ISSUED 类事件对比——栈引擎吸收掉的 RSP 调整微操作不会出现在执行端口计数里,序言重的代码里这两个值的差异有栈引擎一份功劳;二是用 TopDown 方法定位前端重命名带宽占用,见 TopDown 分析方法 与 PMU 性能计数器编程。想做微基准验证,可以对比 PUSH/POP 密集循环与等价的「手动 RSP 调整 + MOV」循环的每迭代周期数——前者每个栈操作约 1 周期吞吐,后者在 RSP 真依赖链上会被打回串行。
还有一个容易踩的坑:栈引擎只认 PUSH、POP、CALL、RET 这四个「官方」栈指令。手写汇编里用 SUB rsp, 8 加 MOV [rsp], rax 模拟压栈,栈引擎完全帮不上忙——SUB 走的是普通 ALU 路径,照常在 RSP 上制造真依赖。同样的道理,RSP 之外的寄存器(比如用 RBP 当帧指针做 PUSH 式操作)也不在它的管辖范围内。快路径的门票只发给最标准的那几种写法,这也是编译器始终坚持用官方指令的原因之一。
| 写法 | 微操作下发 | RSP 依赖链 | 每迭代吞吐 |
|---|---|---|---|
| PUSH x4 / POP x4 | 4 存 + 4 载 | 被栈引擎消除 | 受存储端口限制 |
| SUB RSP,32 + MOV x4 | 1 ALU + 4 存 + 4 载 | MOV 之间无依赖 | 相近 |
| 逐条 SUB/MOV 交替 | 4 ALU + 4 存 | 真依赖串行 | 明显更慢 |
六、对写代码和读汇编的启示
对普通开发者,栈引擎的结论很朴素:放心用 PUSH/POP,编译器生成它们是正确选择,手工改成 MOV 加 SUB 通常没收益还可能更糟。真正值得记住的是两条。一,栈指令尽量聚拢,中间少插读 RSP 的指令,少触发同步微操作——好在编译器布局序言尾声时天然就是这么做的。二,CALL/RET 的开销大头不在栈指针,而在 RAS 预测是否命中:调用约定规范(CALL 与 RET 配对、不用 JMP 跳回)保住 RAS 精度,比纠结栈指令本身重要得多,展开见 返回地址栈 RAS。
对读反汇编做性能分析的人,栈引擎提供了一把标尺:看到连续 PUSH/POP 时,不要再按「每条一串行依赖」的心智模型估算耗时;它们在现代核心里是零依赖并行的存储/加载。真正要警惕的是 ENTER/LEAVE 这类复杂栈指令——它们走微码序列,不进栈引擎快路径,慢得多,编译器也早就不生成了。
这一篇在知识体系里的位置
本篇位于微架构模块「乱序执行与前端特例优化」的交叉点。同哲学下的姊妹篇是 move 消除与零惯用法(重命名阶段消化寄存器搬家);配套硬件见 返回地址栈 RAS(栈内容的预测)。上游基础是 寄存器重命名 与 乱序重命名与退休,恢复机制依赖 重命名检查点与分支恢复。前端相邻优化还有 宏融合与微融合,观测方法见 TopDown 分析方法。全景见 CPU 微架构总览。
总结
栈引擎是挂在重命名阶段的一枚专用加法器加一个推测偏移寄存器,专门吸收 PUSH/POP/CALL/RET 的 RSP 加减:连续栈指令的指针更新在前端就被算完并结算进重命名表,栈指令之间从「逐条排队的真依赖链」变成「地址确定的并行存储/加载」,不占用任何执行端口;代价是两类对账动作——非栈指令读 RSP 时插入同步微操作结算偏移、分支误预测时随 RAT 检查点回滚偏移;它和 RAS 一个管栈指针一个管栈内容,合起来让函数调用与序言尾声在现代 x86 核心里近乎免费,也是「把执行挪到前端特例逻辑」这一设计哲学(与 move 消除同源)的经典案例。