流水线与超标量 —— CPU 提吞吐的两个正交手段:纵向重叠 vs 横向加宽
承微架构导读 cpu-microarch-overview。很多人把"流水线""超标量""乱序"混着说,其实它们是层层叠加、各自解决不同瓶颈的手段。本篇是"流水线 + 超标量"这一层的导读:一句话讲清两者的正交关系,再路由到三个子篇——流水线基础、超标量设计、IPC 瓶颈。乱序执行、分支预测都是建在这个底座上的(见 cpu-out-of-order / branch-prediction)。
一句话认知
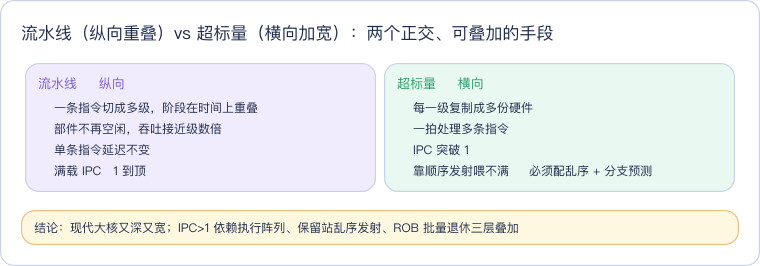
流水线是"纵向"的——把一条指令切成多级,让不同指令的不同阶段在时间上重叠;超标量是"横向"的——把每一级都加宽成多份硬件,一拍处理多条指令。 两者正交、可叠加,是现代 CPU"一拍退休好几条指令(IPC>1)"的底座。
- 标量 CPU 一条指令从头走到尾才取下一条,每个部件 5 拍里只忙 1 拍——浪费的是部件空闲。
- 流水线把阶段重叠:部件不再空闲,吞吐接近级数倍,但单条指令延迟不变。
- 流水线满载 IPC≈1 到顶,超标量把每级复制成多份:一拍多条,IPC 突破 1。
- 横向加宽的硬件靠顺序发射喂不满(紧邻指令常有依赖),于是必须配乱序执行挖 ILP(cpu-out-of-order),遇分支再靠分支预测跨过去(branch-prediction)。
三线速览
线一:流水线——纵向重叠(pipelining-basics)
把一条指令切成 6 级(取指 IF / 译码 ID / 发射 IS / 执行 EX / 访存 MEM / 写回 WB),让指令 1 在执行时、指令 2 在译码、指令 3 在取指——像洗衣店,第一批烘干时第二批开始洗。关键区分:它改吞吐(满载每拍退休 1 条),不改延迟(单条指令仍要走完全部级)。更深的流水线(超流水线 15~20 级)能拉高频率,代价是分支误预测惩罚 = 流水线深度。六级部件里 IS 级埋着 RAW 冒险(保留站)、WB 级埋着 WAW/WAR(寄存器重命名)——这正是数据冒险(data-hazards)和乱序执行的引子。子篇里有 6 条指令流过 6 级流水线的序列图 + 填充/满载/排空三阶段逐拍拆解。
线二:超标量——横向加宽(superscalar-design)
流水线 IPC≈1 到顶,突破 1 只有一条路:每一级放多份硬件。现实超标量核是三段式:前面共享(取指译码不分指令类型,每拍 4~6 条并行译成 µop)→ 中间分流(按操作码分进 INT 集群:8 ALU + 2 分支;FP 集群:4 FMA + 4 SIMD ALU,各带保留站乱序发射)→ 后面汇合(全部结果汇入共享 LSU 和 ROB)。为什么前面共享:取指时不知道指令类型,按类型分家要两套 I-Cache 面积翻倍;为什么后面分流:整数 1 拍、浮点 4~5 拍,混在一起短延迟被长延迟堵死,且物理上 ALU 和 FMA 晶体管规模差一个数量级。汇合处的 LSU(AGU×3~4 决定访存 IPC 上限)和 ROB(乱序执行、顺序退休)是全部指令的两个碰头点。
线三:IPC 为何到不了理论值(ipc-bottlenecks)
IPC > 1 靠五个加宽点:取指 4~6 条/拍、译码 4~6 µop/拍、发射 INT 4 + FP 4、执行 18 单元、退休 4~8 µop/拍。但真实 IPC = min(前端带宽、保留站可发射数、执行端口数、ROB 退休带宽、访存延迟)——最小项卡住,其他加得再宽也没用。最常见瓶颈在发射层:依赖链捆住候选 µop(A→B→C→D 只能一拍一条),端口冲突互相抢槽位;执行单元反而大量闲置(18 个只用到 1 个是常态)。所以 -O0 IPC 0.61、-O2 1.68 都远低于理论 4~6——不是硬件不够宽,是软件 ILP 和访存延迟不够。子篇里还有一个"6 条无依赖加法"的时序片段:发射宽度限制下 IPC=4,两两依赖则掉到 2——依赖链长度直接吃掉一半宽度。
极易混淆的概念,一次划清
| 概念 | 是什么 | 和超标量的区别 |
|---|---|---|
| 超流水线(superpipelining) | 流水线切得更深(级更多、每级更短),提频率 | 深≠宽。超流水是纵向切更细,超标量是横向加更宽 |
| VLIW | 超长指令字:编译器在编译期把多条打包成一条宽指令,硬件不做动态调度 | 超标量是硬件运行时动态找并行;VLIW 把这活推给编译器(如安腾、部分 DSP) |
| SIMD(如 AVX) | 一条指令处理多份数据(数据级并行 DLP) | 超标量是多条不同指令并行(ILP);SIMD 是一条指令、一个操作、多路数据 |
| 多核 / SMT | 多个核 / 一核跑多线程(线程级并行 TLP) | 超标量是单线程内的并行;多核是跨线程并行。层次完全不同 |
记忆锚点:超标量=同一拍多条不同指令(ILP);SIMD=一条指令多份数据(DLP);多核/超线程=多个线程(TLP);超流水=同一条指令切更多级(提频率)。 四者可以同时存在于一颗现代 CPU 上。
三篇速览与关系
| 子篇 | 内容 | 外部引用锚点 |
|---|---|---|
| pipelining-basics | 标量基线 → 六级部件 → 6 条指令序列图 → 填充/满载/排空逐拍拆解 | uop-pipeline-walkthrough 的译码器、reservation-station 的 IS 级 |
| superscalar-design | 三段式布局图 + 设计原理 + 功能单元阵列 + LSU/ROB 共享后端 | rob / lsu 的"初步介绍"引用 |
| ipc-bottlenecks | 五级加宽全览 + 各点详细限制 + 三层并行抽象 + IPC 公式 + 正交对比 + 观测 | perf-case-studies 的 §三.3.5 锚点引用 |
和本仓库其他文档的关系:
- 导读:cpu-microarch-overview——CPU 变快的演进链(标量→流水线→超标量→乱序→投机),本篇是其中"流水线 + 超标量"两层的展开。
- 超标量关键部件独立分析:
- reservation-station——保留站:解耦译码与执行,乱序发射的发生地
- rob——ROB:顺序退休、精确异常、对头阻塞
- lsu——LSU:AGU、store buffer、store→load forwarding
- register-renaming——寄存器重命名:消除假依赖
- 下一层:cpu-out-of-order——超标量喂不饱的问题靠乱序执行解决。
- 控制冒险的解:branch-prediction——深流水线遇分支的解法。
- IPC 掉下来的常见外因:cache-organization、tlb、mesi(伪共享)。
- 观测:perf(IPC、frontend/backend 停顿)。
- 流水线引起的冒险:data-hazards——RAW/WAW/WAR 三类数据冒险的根源、硬件解法与 L1 miss 场景的时序走读。
- 纵切面走读:uop-pipeline-walkthrough——一条指令从 L1 取指到退休的完整 µop 级路径,包含各部件交互时序。
总结
流水线和超标量是 CPU 提吞吐的两个正交手段:流水线"纵向"把一条指令切成多级、让不同指令的不同阶段在时间上重叠(部件不空闲,IPC 逼近 1,但不改单条延迟);超标量"横向"把每一级复制成多份、一拍处理多条(IPC 突破 1)。现代大核二者兼用(又深又宽),IPC > 1 依赖三层并行叠加——执行单元阵列(物理基础)、保留站乱序发射(调度填满)、ROB 多端口批量退休(出口不卡)——每一层都被设计成与前端发射宽度对称匹配,不存在"所有结果汇入 ROB 就退化成串行"的单入口瓶颈。但横向加宽的硬件靠顺序发射喂不满(紧邻指令常有依赖),所以超标量几乎必然配乱序执行去挖 ILP、配分支预测跨过控制冒险——这条"加宽→喂不饱→乱序→遇分支→预测"的因果链就是微架构演进主线。综合成效看 IPC:低了就去查 cache/TLB miss、分支误预测、或依赖链。别把超标量和超流水(切更深)、SIMD(一指令多数据)、多核(多线程)搞混。