DRAM bank 并行:channel/rank/bank group/bank 四级并行结构如何撑起内存带宽
承 dram-controller-frfcfs-scheduling——那一篇讲的是内存控制器怎么用 FR-FCFS 策略在请求队列里挑顺序、最大化行缓冲命中率,但它把一个更底层的问题略过了:为什么"换一行""换一列"会有快慢之分,为什么调度器手里同时能有几十个请求在飞? 答案在 DRAM 芯片自己的物理结构里。一颗 DRAM 颗粒的内部不是一个"大数组",而是一棵 channel → rank → bank group → bank 的并行树,DRAM bank 并行就是把访存请求沿着这棵树摊开、让几十个小存储阵列同时各干各的,用空间并行换时间。单看任何一个 bank,它都慢得可怜——一次完整的"开行读数关行"要 45ns 上下;但 32 个 bank 轮着做,带宽就堆出来了。调度器手里能同时有几十个请求在飞,还依赖一个前提:上游得有这么多并发 miss 送下来。CPU 侧靠 MSHR 撑起内存级并行,DRAM 侧靠四级结构消化它们,两边是"供给与消化"的接力——任何一边浅了,带宽都跑不满。理解这棵树,是理解一切内存带宽现象(为什么随机访问掉速、为什么多线程反而跑不满、为什么插满内存条有讲究)的钥匙。微架构全景见 cpu-microarch-overview。
本文要回答的问题
- DRAM 从一根内存插槽到一颗颗粒内部,channel/rank/bank group/bank 这四级到底各是什么、各自提供多少并行度?
- 单个 bank 为什么不能连续工作,tRC、tFAW、tCCD 这些时序约束各自卡的是什么?
- 内存控制器调度器是怎样靠 bank 级并行把这些"冷却时间"藏起来的?
- 地址比特是怎么映射到各级结构的,为什么这个映射决定了访存模式的快慢?
- 写代码和做性能分析时,bank 并行暴露了哪些可观测、可利用的规律?
一、问题的起点:一个 bank 为什么慢得离谱
先把单个 DRAM bank 的工作过程钉死。一个 bank 是一个二维阵列(行 × 列),配一行行缓冲(row buffer)——一次只能有一行处于"打开"状态。读一个缓存行要三步:
- ACT(Activate,开行):把目标行整个读进行缓冲,代价 tRCD 约 14~18ns;
- RD/WR(读写列):从行缓冲里取需要的列,CAS 延迟约 14ns;
- PRE(Precharge,关行):如果下一次要访问的是另一行,得先关掉当前行给位线充电,tRP 约 14ns。
三个时间加起来,对"开行 → 读 → 换另一行"这种最不利的序列,同一 bank 两次 ACT 之间必须间隔 tRC(Row Cycle time)≈ 45ns。也就是说单个 bank 每秒最多发起约 2200 万次行访问——64B 一行满打满算 1.4GB/s。而一根 DDR5-4800 通道的标称带宽是 38.4GB/s。中间这将近 30 倍的差距,就是 DRAM bank 并行要填的坑:带宽不是靠把单个 bank 做快,而是靠堆并行单元同时工作。
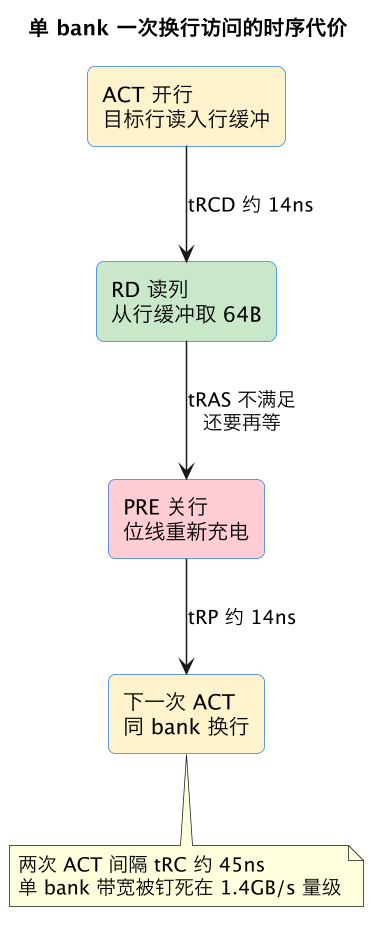
这张图的核心是:PRE 之后这个 bank 就进入了"冷却期",冷却期间它一个字节也吐不出来。如果系统里只有这一个 bank,内存带宽就是冷却时间除以传输时间的除法结果——惨不忍睹。DRAM 的全部工程智慧,就是在冷却期里让别的单元接着干活。
二、四级并行结构:从插槽到阵列的并行树
真实的内存子系统是一棵四层树,每一层都提供独立的并行能力:
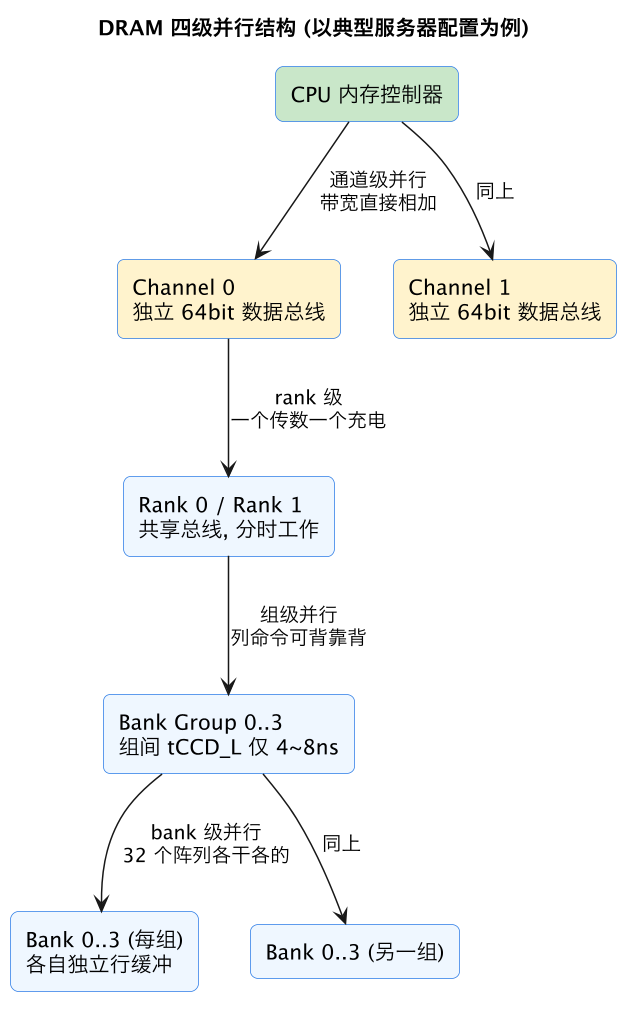
逐层说清每一级并行的是什么、代价是什么:
- Channel(通道)级:每个通道有完全独立的数据总线和命令通道,带宽直接相加。8 通道服务器就是 8 份带宽,没有任何时序上的相互牵制。这是最"干净"的并行。
- Rank 级:同一条内存条正反面(或双面颗粒)构成不同 rank,共享同一通道的数据总线。rank 之间不能同时传数据,但可以一个 rank 在总线上跑数据、另一个 rank 在后台 ACT/PRE——等于用 rank 间切换隐藏冷却时间。
- Bank Group(组)级:DDR4 引入的结构。同一 bank group 内的两个连续列命令要隔 tCCD_L(约 8ns),不同 bank group 之间只需 tCCD_S(约 4ns)——组间切换比组内切换快一倍,等于给调度器提供了一条"快车道"。
- Bank 级:每个 bank 有独立行缓冲,一个 bank 冷却时别的 bank 照常工作。DDR4/DDR5 每颗颗粒 16~32 个 bank,这是数量最多、最常用的一级并行。
顺带解释一个常见困惑:为什么 DRAM 带宽一代代翻倍,延迟却几十年徘徊在 60~100ns。因为 JEDEC 标准每一代都在堆并行度——bank 数从 DDR3 的 8 涨到 DDR5 的 32,通道越切越细——而单个存储单元的充放电物理过程几乎没变快。带宽 = 单单元速率 × 并行度,延迟只取决于前者。所以"加带宽"和"降延迟"是两笔独立的账,本篇讲的四级结构只对前一笔负责。
把这棵树乘起来:一颗 DDR4 颗粒 4 组 × 4 bank = 16 个 bank,单 rank;通道上 2 rank 就是 32 个可并行激活的 bank。DDR5 翻倍到 32 bank/颗粒,还把单条 DIMM 拆成两个独立 32bit 子通道。标称带宽 = 单 bank 传输能力 × 并行度,这句话至此有了具体含义。
三、时序约束清单:调度器要绕着走的三道墙
四级结构给了并行度,但每一级都挂着自己的时序约束。调度器的全部工作就是在满足这些约束的前提下把命令排出去。核心约束一览:
| 约束 | 含义 | 典型值 (DDR4-3200) | 卡的是什么 |
|---|---|---|---|
| tRC | 同 bank 两次 ACT 最小间隔 | ~45ns | bank 级并行的冷却周期 |
| tFAW | 任意窗口内最多 4 次 ACT 的窗口宽度 | ~25~35ns | 全颗粒级激活速率上限 |
| tRRD_L/S | 同组/跨组两次 ACT 最小间隔 | ~6ns / ~4ns | 激活命令的组内/组间间隔 |
| tCCD_L/S | 同组/跨组两次列读写最小间隔 | ~8ns / ~4ns | 数据总线背靠背切换 |
| tRP | PRE 到下次 ACT | ~14ns | 单个 bank 的重启时间 |
| tRCD | ACT 到首个列命令 | ~14ns | 开行到可用 |
| tRTW / tWTR | 读转写 / 写转读的总线翻转 | ~10ns+ | 数据总线方向切换 |
这里最阴险的是 tFAW(Four Activate Window):它是一个滑动窗口约束——任意 tFAW 宽度的时间窗内,整个颗粒最多只能发 4 次 ACT。注意它不区分 bank:就算 32 个 bank 全闲着、全访问不同 bank,激活速率也被 tFAW 封顶在 4/tFAW ≈ 每 8ns 一次。这就是为什么"随机访问不同 bank"并不能无限提速——bank 并行度有 32,但 ACT 令牌发放速率是全局受限的,tFAW 是整个内存子系统的隐藏节流阀。
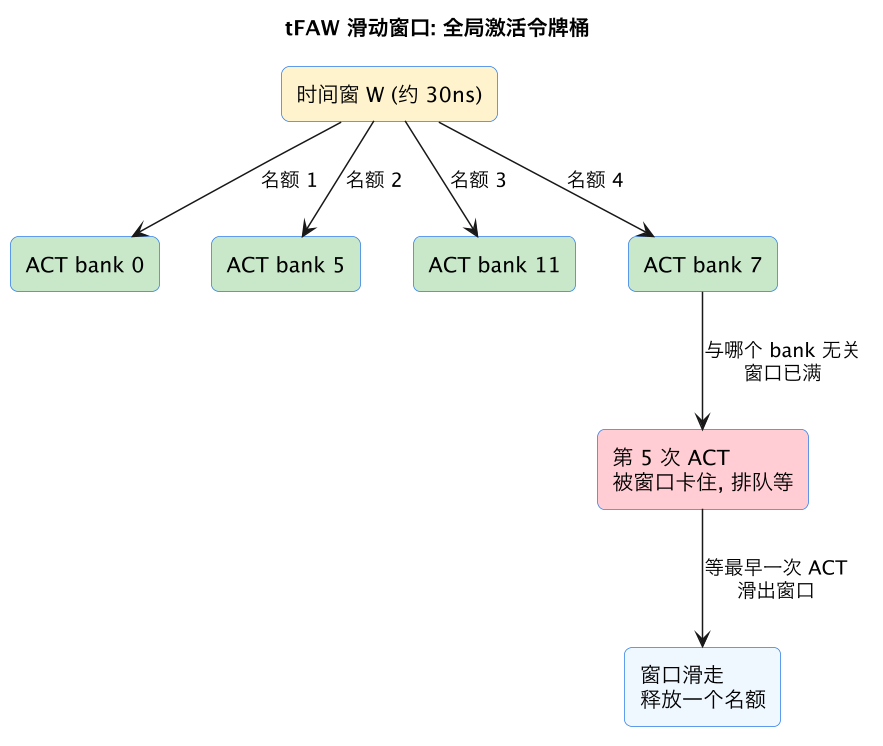
注意这张图里 4 次 ACT 打向 4 个不同的 bank——tFAW 照样卡第 5 次。新手常以为"换 bank 就万事大吉",其实换 bank 只解决 tRC,解决不了 tFAW。真正的高效序列是在 tFAW 允许的激活速率下,让每个 ACT 之后尽量多读几列(行缓冲命中),摊薄激活成本。
四、调度器的把戏:用并行隐藏冷却
有了结构和约束,调度器的策略就顺理成章了——本质上是个三维装箱问题:命令队列里几十个请求,每个请求落在某个 (rank, bank group, bank) 上,调度器按优先级挑,目标让数据总线 100% 占满。具体的 FR-FCFS 算法见 dram-controller-frfcfs-scheduling,本篇只看它和四级结构的配合:
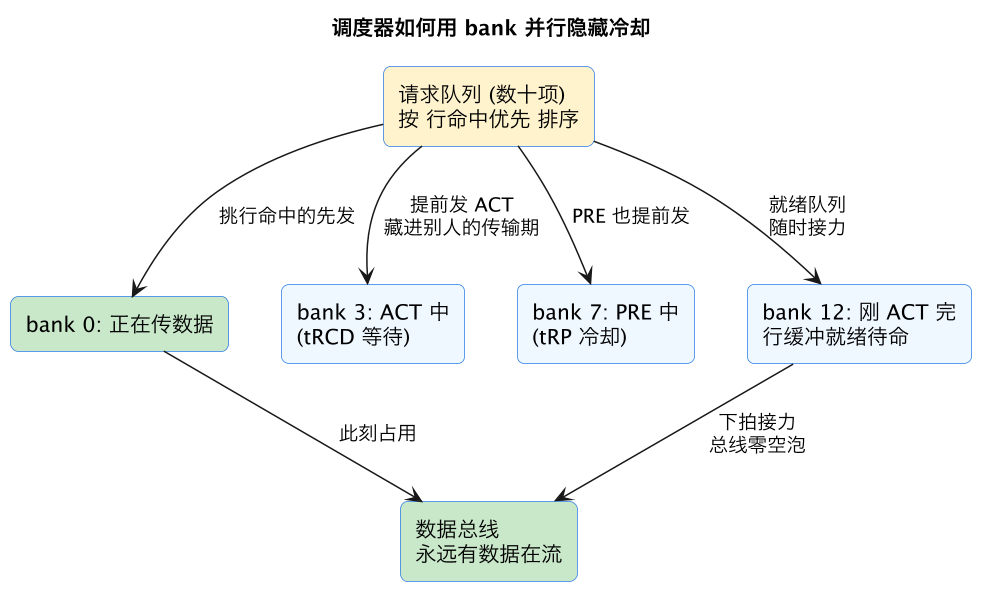
调度器的三板斧,每一板斧对应一级并行:
- 预激活(pre-issue ACT):bank 3 的 ACT 不等到要用数据才发,而是趁 bank 0 占总线传数据时提前发出——tRCD 的 14ns 藏在别人的传输时间里。这是 bank 级并行最直接的用法。
- bank group 交替:连续两个突发如果落在不同 bank group,列命令只隔 tCCD_S(4ns),总线几乎无缝接力;落同组就要 8ns,调度器会优先挑跨组的。
- rank 交错:一个 rank 在总线上跑、另一个 rank 在后台充电,切换 rank 时数据流不断。代价是 rank 切换本身有总线翻转开销,所以只在大流量时划算。
这套机制的净效果:只要请求队列够深、地址分布够散,冷却时间完全不暴露在关键路径上,数据总线利用率可以推到 90% 以上。反过来说,带宽跑不满只有两种原因——队列不够深(没有足够并发请求喂给调度器,这正是 mshr-miss-status-register 里 MLP 那一套),或者地址分布太集中(所有请求砸在同一 bank 上,下一节展开)。
五、地址映射:决定快慢的隐形哈希
一个物理地址的比特是怎么切给 channel/rank/bank group/bank/row/column 的,直接决定了你的访存模式落在并行树的哪个位置。典型的映射思路(各代平台细节不同,逻辑一致):
| 地址段(从高到低) | 映射到 | 这样放的理由 |
|---|---|---|
| 高位比特 | row | 同一行的局部性聚在相邻地址 |
| 中间比特 | channel / rank | 让连续地址散开喂满所有通道 |
| 中低位比特 | bank / bank group | 让顺序流扫过不同 bank,冷却互不阻塞 |
| 低位比特 | column(行内偏移) | 一个缓存行 64B 落在行缓冲里 |
关键在中间几层用的是异或哈希而不是连续比特切片:Intel/AMD 都把若干地址高位比特异或折叠进 channel/bank 选择比特里,目的就是防止"stride 等于 bank 周期"的坏模式——如果直接切连续比特,stride 恰好是 2 的幂的访问会把所有请求砸在同一个 bank 上,tRC 立刻把你锁死在 1.4GB/s 量级。哈希让 stride 模式也能散开,但哈希不是万能的:足够"坏"的访问模式(如精心构造的 bank 冲突序列、row hammer 式激活风暴)仍然能让 32 个 bank 退化成 1 个。
对性能分析者,地址映射的三个直接推论:
- 顺序流天然友好:连续地址扫过不同 bank、不同 channel,预取器(见 hardware-prefetcher-stride-stream)再叠一层,冷却时间全被藏掉——这就是 memcpy 能跑到标称带宽 90%+ 的原因。
- 指针追逐是 bank 并行的天敌:链表随机跳,每次访存的地址不可预测、请求无法批量入队,调度器手里没牌可打,延迟就是赤裸裸的 tRCD+CAS 串行和。
- 多线程不一定加带宽:多线程让队列变深是好事,但如果各线程访问的地址段哈希后挤在少数 bank,冲突照样把 tRC/tFAW 打满。用
perf stat看uncore_imc的 ACT 命令计数和总线利用率,ACT 频率逼近 tFAW 上限而数据带宽不涨,就是典型的"激活受限"——病在地址分布,不在请求数。
NUMA 多插槽下还有一层放大:远端内存访问的队列更深、延迟更长,bank 冲突的惩罚被跨插槽延迟进一步放大,观测方法见 cache-numa-locality。
六、工程清单:把四级并行用起来的五条纪律
收束成可执行的几条:
- 插满通道是第一位。8 通道平台只插 4 根,带宽先砍一半,软件上任何优化都补不回来——channel 级并行是唯一"零时序代价"的并行。
- 顺序优先于随机,批量优先于单发。让访问模式给调度器留足队列深度(多 outstanding miss),它才有空间做预激活和 bank 交替。
- 警惕 2 的幂 stride。大数组按 4KB/2MB 步长跳着访问是教科书级的 bank/channel 冲突场景,步长错开一个缓存行往往立刻见效。
- 读多就摊薄 ACT。提高行缓冲命中率(数据按 DRAM 行大小 1~2KB 聚合访问)等于把 tFAW 的每个激活令牌榨出更多字节。
- 看计数器定位约束层。带宽跑不满时分辨是总线利用率低(队列浅)还是 ACT 频率顶格(tFAW/冲突)——前者加并发,后者改数据布局,药方完全不同。
这一篇在知识体系里的位置
本篇是内存子系统"硬件结构"层,向上承接调度策略、向下支撑一切带宽分析:
- dram-controller-frfcfs-scheduling:调度算法本身;本篇提供的四级结构和时序约束是它的输入参数。
- mshr-miss-status-register:MLP 决定调度器队列深度,与本篇的 bank 并行度是"供给与消化"的关系。
- hardware-prefetcher-stride-stream:预取器制造顺序流,正是 bank 并行最喜欢的负载形态。
- cache-numa-locality:四级并行在 NUMA 跨节点下的延迟放大效应。
- 上游导读:cpu-microarch-overview 的微架构全景。
总结
DRAM bank 并行是内存带宽的真正来源:单个 bank 被 tRC≈45ns 的冷却周期钉死在 1.4GB/s 量级,系统靠 channel(总线独立、带宽相加)、rank(共享总线、轮流充电)、bank group(组间切换比组内快一倍)、bank(16~32 个阵列各自独立行缓冲)四级结构把请求摊开同时做;调度器以预激活和跨组交替把 tRCD/tRP 藏进别人的传输期,但 tFAW 滑窗给全颗粒的激活速率上了硬顶——所以带宽跑不满的病只有两种:队列不够深,或地址全挤在少数 bank 上,前者加并发、后者改布局,先用 uncore 计数器分清是哪一种再下药。