重命名检查点恢复:分支误预测时,重命名表怎么一键回到"分支之前的世界"
承 register-renaming 与 ooo-renaming-retirement——那两篇讲了重命名表 RAT 怎么把架构寄存器映射到物理寄存器、指令退休时怎么回收旧映射。但留了一个尖锐问题没展开:乱序核心里投机执行是常态,分支预测器每猜错一次,后端已经沿着错误路径重命名了几十上百条指令,这些错误映射怎么清掉? 答案有两种路线——逐条倒带回滚,或者在分支处预先拍快照、错了直接整体回写。后者就是重命名检查点恢复(rename checkpoint recovery),现代高性能内核几乎清一色走这条路。分支预测本身见 branch-prediction,ROB 侧的精确异常与 flush 全貌见 precise-exception-pipeline-flush,本篇只聚焦"重命名表这一格"怎么恢复。
本文要回答的问题
- 分支误预测发生时,重命名表里到底"脏"了什么?不恢复会怎样?
- 逐条回滚(walk-back)怎么做,为什么流水线一深它就撑不住?
- 重命名检查点恢复怎么工作:什么时候拍快照、快照里存什么、恢复时做什么?
- 检查点数量是有限的,"快照槽用完"会发生什么?为什么这限制了分支密度?
- 恢复延迟是多少拍,它在 IPC 账本上占多大分量?
一、误预测之后,RAT 里"脏"了什么
先把舞台搭清楚。重命名的正向流程(详见 register-renaming):每条指令进重命名级时,查 RAT(Register Alias Table,寄存器别名表)拿到两个源操作数的物理寄存器号,再为目的寄存器从空闲列表里申请一个新物理寄存器,把"架构寄存器 → 新物理寄存器"写进 RAT。投机执行意味着:分支还没出结果,它后面的指令已经在改 RAT 了。
现在假设一条 jcc 预测跳、实际不跳。到执行级发现猜错时,错误路径上可能已经有几十条指令完成了重命名:它们占用了物理寄存器、覆盖了 RAT 里好端端的映射、还往 ROB 和发射队列里塞了一堆不该存在的 µop。ROB 和发射队列的清空相对粗暴——按 ROB 序号一刀切,比分支年轻的全部作废(机制见 rob 与 precise-exception-pipeline-flush)。但 RAT 不能一刀切:RAT 里既有错误路径指令写的新映射,也混着分支之前的正确映射和更老但还没退休指令的映射,它没有"年龄"这个维度可以拿来切。不重命名表层面做专门恢复,正确的旧映射就永远找不回来了——后续指令会拿着错误路径留下的物理寄存器号去读,数据彻底错乱。
所以恢复的本质任务是:把 RAT 精确地变回"分支指令刚重命名完那一刻"的样子,同时把错误路径占用的物理寄存器还回空闲列表。怎么做,分成两大流派。
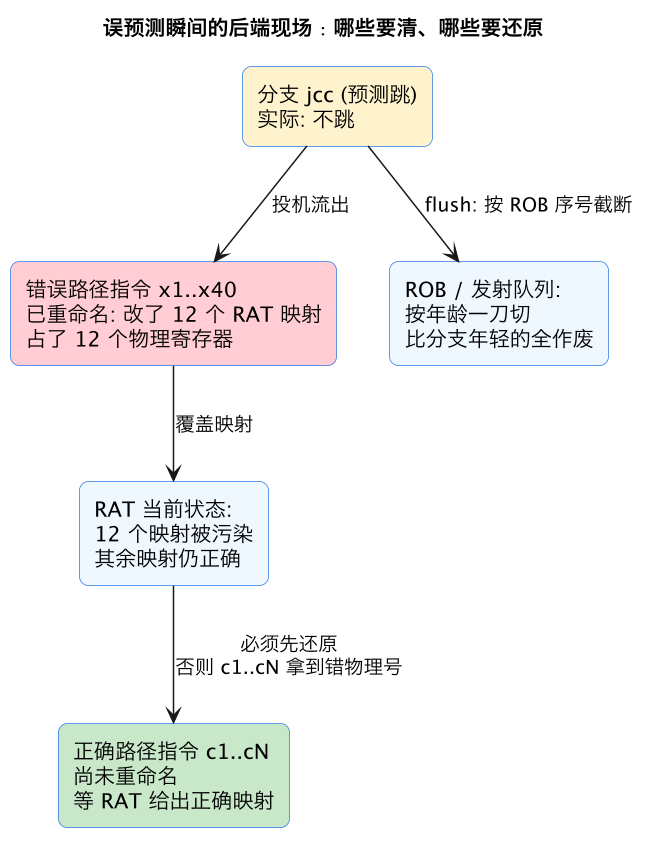
这张图要传达的核心不对称是:队列类结构(ROB、发射队列、load/store 队列)天生带年龄序,flush 是"砍尾巴";RAT 是个无年龄的全局状态表,flush 是"时光倒流"。砍尾巴一拍就能做完,时光倒流需要额外机制——这正是检查点存在的理由。
二、路线一:逐条回滚,简单但慢
最直觉的恢复方法是利用 ROB 里已有的信息倒着走。每条指令进 ROB 时本来就记录了"我改了哪个架构寄存器、它的旧物理寄存器是谁"(这是退休时回收旧映射用的)。恢复时从 ROB 尾部往分支方向逐条走:每走一条,把 RAT 里该架构寄存器的映射改回旧物理寄存器,同时把错误分配的新物理寄存器还回空闲列表。走到分支指令为止,RAT 就精确复原了。
这个方案硬件成本极低——不增加任何存储,纯复用 ROB 的既有字段。它的致命伤在时间是"每条一拍"的串行过程:错误路径上重命名了 40 条指令,就要 40 拍才能把 RAT 倒回去,期间重命名级完全停摆,正确路径的指令在译码级前排长队。
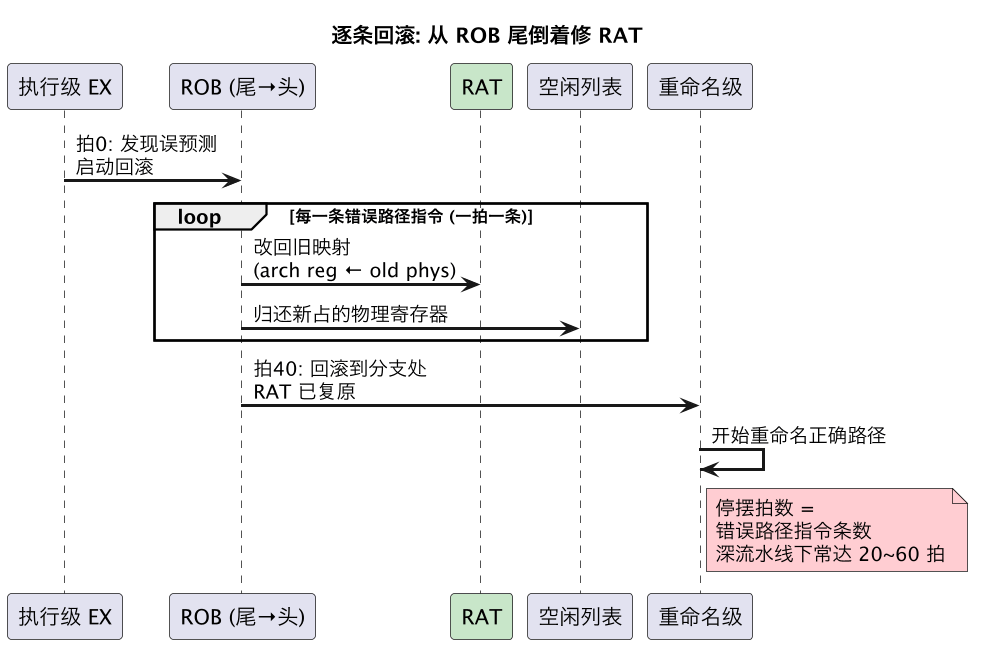
算术很残酷。现代核心 ROB 容量 200~500 条,误预测发现时错误路径上有 20~60 条已重命名指令是家常便饭,也就是说逐条回滚一次就要吃掉 20~60 拍的前端加 rename 供给。按误预测率 1%~5%、每千条指令 15~25 条分支估算,CPI 会被这一项硬生生抬高一截。早期流水线浅(Pentium Pro 那一代 ROB 才 40 条)还能忍,流水线一深就完全撑不住。于是有了第二种路线。
三、路线二:重命名检查点恢复,拍快照、一键回写
重命名检查点恢复的思路是把"事后倒带"改成"事前快照":每当重命名级遇到一条分支指令,就把当前整个 RAT 的内容复制一份存进检查点槽位。分支猜对,槽位释放;分支猜错,把对应槽位里的快照一次性写回 RAT——理想情况下一拍(或少数几拍)完成,不管错误路径有多长。
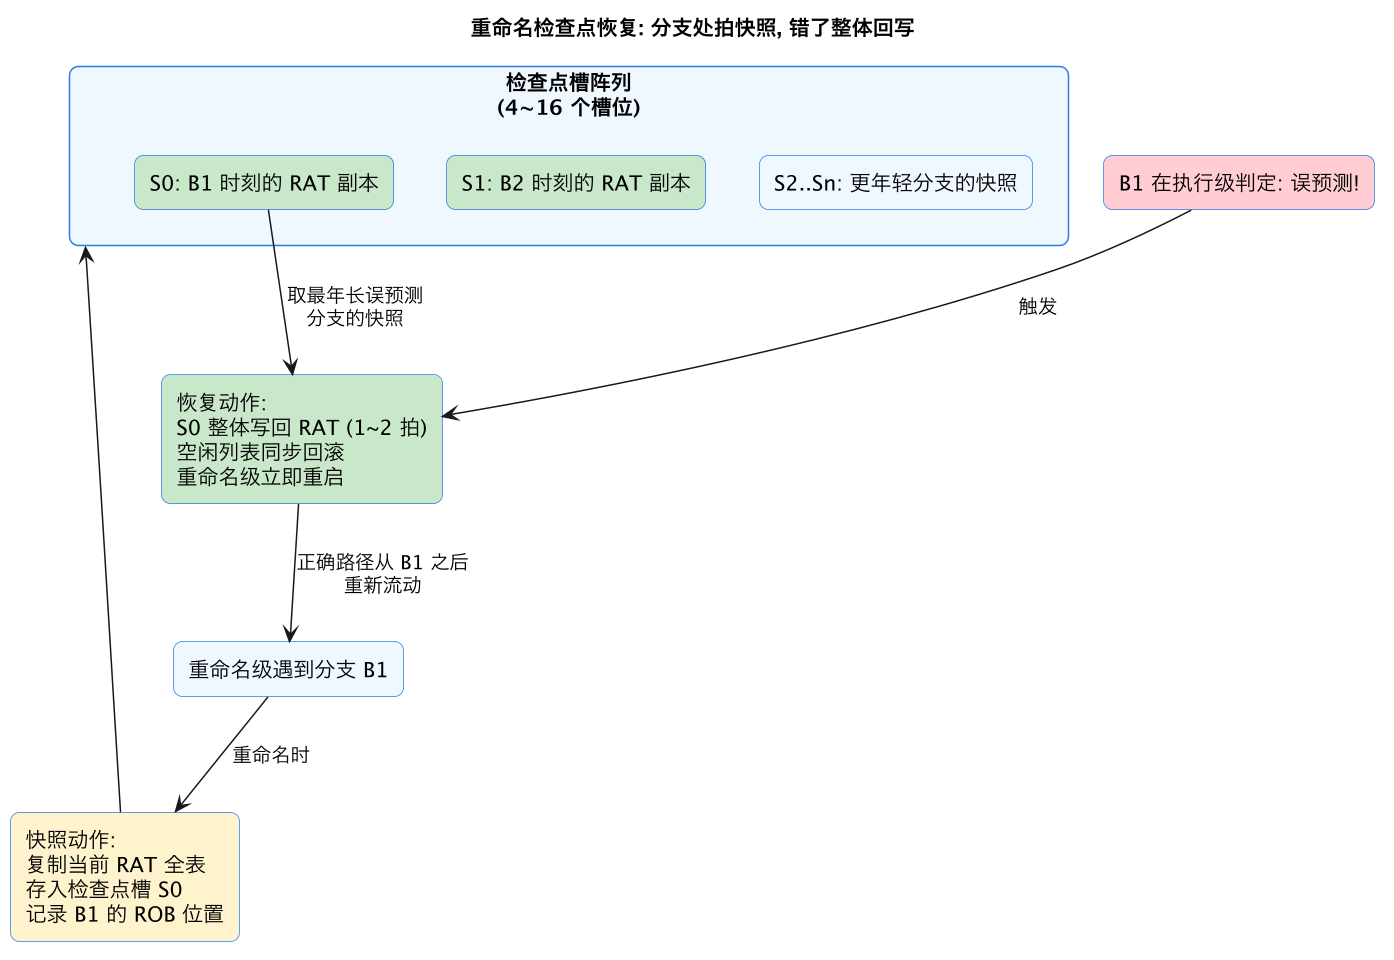
这张图里有三个值得停顿的细节。其一,快照是在重命名分支指令那一刻拍的,内容是"分支之后第一条指令应该看到的 RAT"——所以恢复后正确路径指令拿到的映射天然正确,不需要任何修补。其二,恢复时选的是"最年长的那个误预测分支"的快照:多条分支同时在飞、可能不止一条猜错,先恢复最老的,更年轻的快照槽一并作废,因为那些分支本身可能就是错误路径上的幻影。其三,只回写 RAT 不够,空闲列表也要回滚——错误路径申请的物理寄存器得还回来。空闲列表通常也随分支做简化版检查点(或记录分配位图增量),恢复时一并还原;而"哪些旧物理寄存器该释放"仍靠 ROB 退休时的正常回收逻辑兜底,不会泄漏。
和逐条回滚对比,账面上的差距:
| 维度 | 逐条回滚(walk-back) | 重命名检查点恢复 |
|---|---|---|
| 恢复延迟 | 与错误路径指令数成正比,20~60 拍 | 常数级,1~数拍 |
| 额外存储 | 零(复用 ROB 字段) | 每槽一份完整 RAT 副本(如 16 槽 × 48 项 × 8 bit ≈ 6 Kbit) |
| 快照时机 | 无快照 | 每条分支重命名时占一个槽 |
| 恢复期间重命名级 | 全程停摆 | 几乎不停摆 |
| 分支密度约束 | 无 | 在飞分支数 ≤ 检查点槽数 |
| 适用世代 | 浅流水线(ROB ≤ 百条级) | 深流水线、宽发射现代核 |
代价很清楚:检查点方案拿面积换时间。一份 RAT 副本说大不大,但乘上 4~16 个槽位、再加上多端口布线,是实打实的物理开销。这也是为什么槽位数量给得很克制——而"克制"本身又引出了下一节的结构性约束。
四、检查点槽是有限的:分支密度天花板
检查点槽位是一个硬资源:同时在飞(已重命名、未判定)的分支数不能超过槽数。典型桌面级核心给 8~16 个槽,苹果 Firestorm 一类以宽著称的设计也在这个量级上下。一旦槽位占满,又来一条新分支,重命名级只有一个选择:停摆,等最老的分支判定、释放槽位。
槽位耗尽时的流水线状态用一张结构图看更直观:
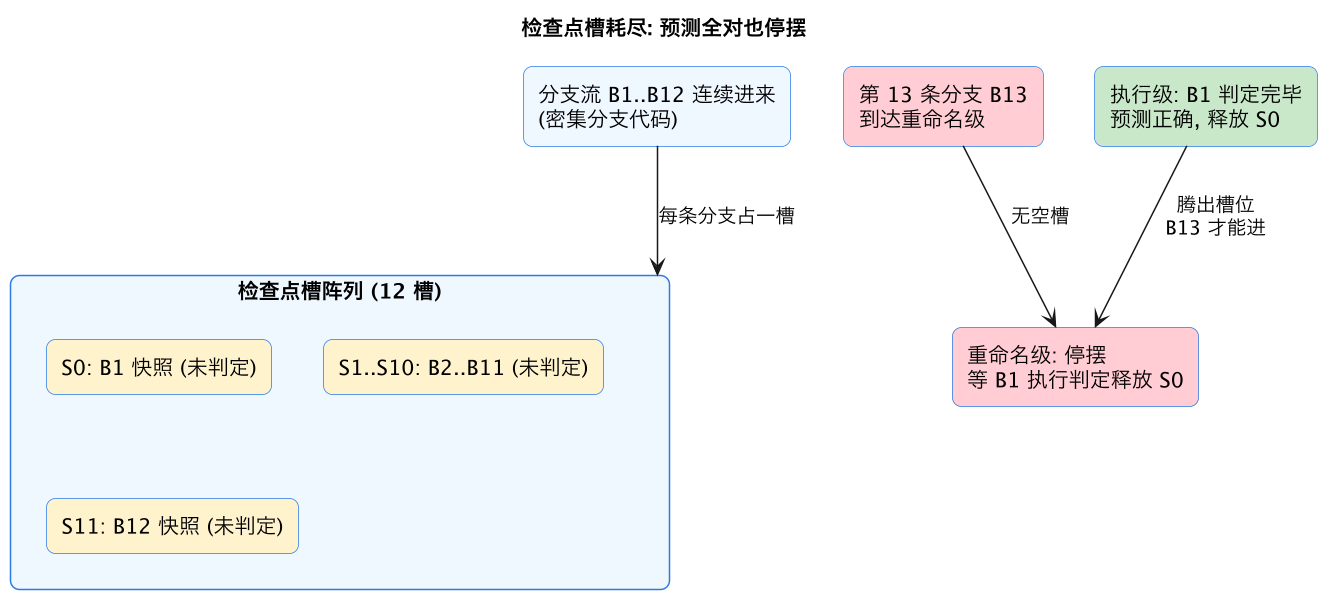
注意图里所有快照的主人预测全部正确——没有任何误预测,重命名级照样停摆。这带来一个反直觉的性能结论:即使分支预测 100% 准,分支太密本身也会卡流水线。一段代码平均每 4 条指令就有一条分支(解释器分发循环、密集的条件赋值),12 个检查点槽只够容纳 48 条指令的窗口——远小于 ROB 的两三百条容量,乱序窗口被检查点槽数"提前封顶",后端再宽也只能小步快跑。这就是微架构文献里说的 checkpoint-limited window。
工程上的缓解有几路:
- 选择性快照:不是所有分支都值得占槽。对"几乎板上钉钉"的分支(如循环回边,历史 strongly taken),有的设计跳过快照、赌它不会错,错了再走慢速逐条回滚兜底。等于给检查点槽做了"缓存替换策略"。
- 合并连续分支:取指块级预测一次带来 1~2 条分支(见 branch-target-buffer-btb),重命名侧可以为同一取指块的多条分支只拍一份快照,粒度从"每条分支一槽"放宽到"每块一槽"。
- 增量检查点:不复制全表,只记录"自上一个快照以来改动的映射清单",恢复时逆向回放增量。省面积,但恢复延迟从常数级退回与改动条数成正比——本质上是两条路线的折中。
对写代码的人来说,这一节的 actionable 结论其实就一条:热路径上无意义的密集分支不只会增加误预测,还会挤占检查点槽、压缩乱序窗口。用条件移动(cmov)、无分支查表把可消的分支消掉,收益比"少了几次误预测"看起来大。
五、恢复延迟与 IPC:这笔账怎么算
把误预测的总代价拆开,重命名检查点恢复只占其中一段,但它是"恢复段"里唯一可优化的变量:
| 阶段 | 典型拍数 | 说明 |
|---|---|---|
| 分支流出到执行判定 | 0~15 拍 | 取决于分支操作数何时就绪,与恢复机制无关 |
| flush 信号广播 + 队列截断 | 1~2 拍 | ROB/发射队列按年龄砍尾 |
| 重命名表恢复 | 1~2 拍(检查点)/ 20~60 拍(回滚) | 本篇主角 |
| 前端重定向、重取指 | 3~10 拍 | 沿正确目标重新灌满前端 |
| 流水线重新填满 | 数十拍 | 宽度 × 深度的隐性损失 |
误预测总惩罚常说 15~20 拍起步,指的就是这条链。检查点恢复把"重命名表恢复"这一段从几十拍压到一两拍,是它存在的全部意义。反过来看一个容易忽略的事实:恢复得再快,已经损失的前端带宽也追不回来——flush 期间前端供不上 µop,后端空转的槽位是永久损失。所以性能工程的第一优先级永远是"少猜错"(提高预测准确率、降低分支密度),检查点恢复只是让每次猜错的账单小一点。
观测侧,误预测及其恢复代价落在 perf 的 br_misp_retired.all_branches 与 Topdown 的 bad_speculation 桶里:
# Topdown 第一层: bad_speculation 占比
perf stat -M TopdownL1 ./app

# 更细的误预测事件
perf stat -e br_misp_retired.all_branches,\
br_inst_retired.all_branches,\
cycles ./app
# 误预测率 = br_misp / br_inst
# 每千条指令误预测次数 (MPKI) 越高, 恢复机制越在火上烤经验判断:bad_speculation 超过 10% 且误预测率高于 2% 时,说明程序在给整条恢复链路频繁交税——这时去优化代码布局、消分支、上 PGO,比纠结任何后端参数都有用。瓶颈定位的系统方法见 ipc-bottlenecks。
这一篇在知识体系里的位置
本篇是微架构"乱序执行"环节里重命名机制的纵深补篇,与既有文章互补不重复:
- register-renaming:重命名的正向流程——RAT 怎么查、物理寄存器怎么分配;本篇讲的是这套状态在"世界线收束"时怎么还原。
- ooo-renaming-retirement:重命名与退休的完整生命周期,旧映射回收的主场;检查点恢复是其中"异常分支"的展开。
- rob:ROB 的年龄序与按序退休;本篇解释了为什么队列能一刀切而 RAT 不能。
- branch-prediction:方向预测器的主场,"怎么少猜错";本篇是"猜错之后怎么办"的重命名侧答案。
- precise-exception-pipeline-flush:flush 与精确异常的全景机制,检查点恢复在其中只占一格。
- 下游影响:恢复延迟在 IPC 账本上的位置见 ipc-bottlenecks,乱序全景见 cpu-out-of-order。
总结
重命名检查点恢复是乱序核心给分支误预测买的"时光机保险":每重命名一条分支就给整张 RAT 拍一份快照,猜错时把快照整体写回、一两拍复原,取代了逐条回滚几十拍的停摆;代价是检查点槽位有限——在飞分支数被槽数硬封顶,分支太密即使全猜对也会卡死乱序窗口,所以消分支的收益从来不只是"少猜错几次"。