ARM MTE 内存标记:lock/key 锁钥机制如何用硬件加速内存安全检测
更新时间:2026-10-05。内存安全漏洞——堆溢出、use-after-free、越界读——长期占据各大厂商高危 CVE 的半壁江山,Chrome 与 Android 的公开统计都指向约 70% 的严重漏洞源于内存安全。软件侧的应对是 ASan(AddressSanitizer)这类编译期插桩:给每次内存访问前后插入影子内存检查代码,检测能力强,但 2 倍上下的运行时开销和 1.5 倍以上的内存膨胀让它只能活在测试机与灰度里,上不了生产。ARM 在 Armv8.5-A 引入的 MTE(Memory Tagging Extension,内存标记扩展)换了一条路:把「这次访问合不合法」的判断下沉到硬件,给内存上锁、给指针配钥匙,load/store 路过时顺手比对。本篇讲透 ARM MTE 内存标记的 lock/key 机制、同步与异步两种检测模式的取舍、真实开销,以及它在 Android 生态的部署现状。同属硬件内存防护阵营的还有 x86 侧的 MPK 内存保护密钥,两者的设计哲学对比会在文末展开。
本文要回答的问题
- ARM MTE 内存标记的 lock/key 机制到底是什么?锁和钥匙各存在哪?
- 4 位标签只有 16 个值,随机碰撞的概率怎么算,够不够用?
- 同步模式与异步模式有什么区别?为什么性能差一倍?
- MTE 相对 ASan 省在哪里?生产环境开销到底多少?
- 部署现状如何:哪些芯片、哪些系统、哪些代码已经吃上 MTE?
一、lock/key 机制:内存上锁,指针配钥匙
MTE 的核心抽象一句话可以说完:把物理内存按 16 字节粒度(granule,标记颗粒)划分,每 16 字节挂一把 4 位的「锁」(lock tag,存在内存系统侧的隐藏存储里);指针在被分配出来时,高 4 位被写入一把 4 位的「钥匙」(key tag,存在指针自身的 top byte 里)。之后每一次 load/store,硬件同时读出目标 16 字节颗粒的锁和指针里的钥匙,两者相等放行,不等即违规。
这个设计能成立,依赖一个已有的铺垫:AArch64 的 64 位指针实际只用 48 到 52 位,最高字节长期闲置,ARM 早就有 TBI(Top Byte Ignore,顶字节忽略)特性让硬件在寻址时屏蔽顶字节——Linux 内核的 hwasan、指针认证 PAC 都打过这 8 位的主意。MTE 占用其中 4 位放钥匙,剩下 4 位仍可给别的特性用。
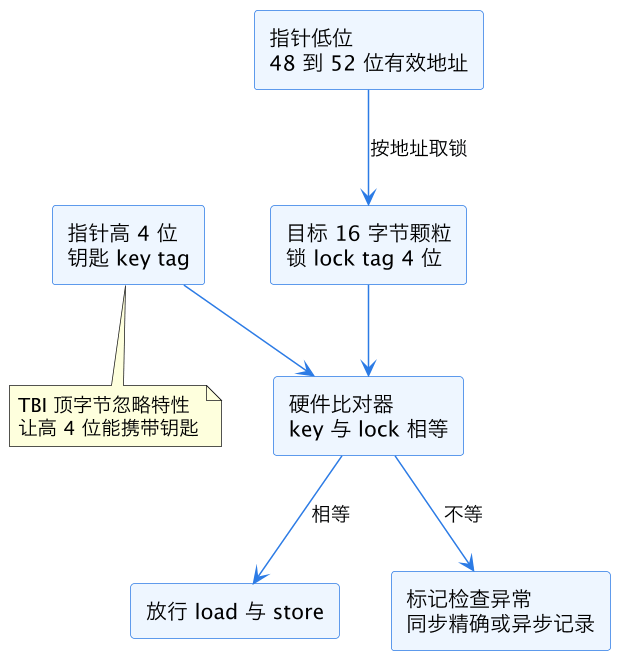
上图是 lock/key 机制的全貌。注意三点:第一,锁不在普通内存里,它在内存控制器侧一块专用的小容量 tag 存储中,普通指令读写不到,防止攻击者直接改锁;第二,比对由硬件在每次访存时完成,不需要任何插桩指令,这是 MTE 相对 ASan 省掉大头开销的根源;第三,钥匙跟着指针走,指针被拷贝、被传递给其他函数,钥匙一起流动,访问权限随指针天然传播。
配套的新指令其实很少:irg(生成带随机钥匙的指针)、addg/subg(给指针上的钥匙加减并调整地址)、stg/stzg(给颗粒写锁,stzg 顺便清零数据)、ldg(读回某地址的锁),外加 st2g、stgp 等批量变体。glibc 或 Android 的 bionic 分配器在 malloc 里做的事就是:irg 出一把新钥匙,用 stg 把这块内存的所有颗粒上同一把锁,返回带钥匙的指针。
二、分配与回收全流程:锁的生成、轮换与悬空指针
光看一次访问的比对还不够,锁的生命周期管理才是检测能力的来源。完整流程分四步。
第一步是分配。malloc(48) 拿到 3 个颗粒,分配器调 irg 生成一把与邻居不同的钥匙(比如 0x5),把 3 个颗粒的锁都设成 0x5,返回 0x5xxx...addr 形式的指针。此时任何不带钥匙 0x5 的指针访问这 48 字节都会触发违规。
第二步是邻居隔离。相邻的另一次分配会刻意选一把不同的钥匙(分配器维护简单的轮换或随机策略),于是第一个缓冲区向右溢出 1 字节,落到邻居的颗粒上,钥匙对不上邻居的锁,当场被抓。这解决了 ASan 靠 redzone(红区填充字节)才能做到的溢出检测,而 MTE 不需要额外内存——16 字节粒度本身就是天然红区。
第三步是释放。free 时分配器把这 48 字节的锁全部改成另一把「废弃钥匙」(比如 0x0 或一把 quarantine 专用值)。旧指针的钥匙还是 0x5,之后任何 use-after-free 访问立即违规。
第四步是复用。这块内存下次被重新分配时换上新钥匙 0x9,旧指针的 0x5 依然对不上。也就是说,MTE 对 use-after-free 的检测不依赖 quarantine 延迟复用(ASan 要靠隔离区推迟复用才能抓 UAF,代价是内存膨胀),锁的轮换本身就保证了「旧钥匙永远开不了新锁」。
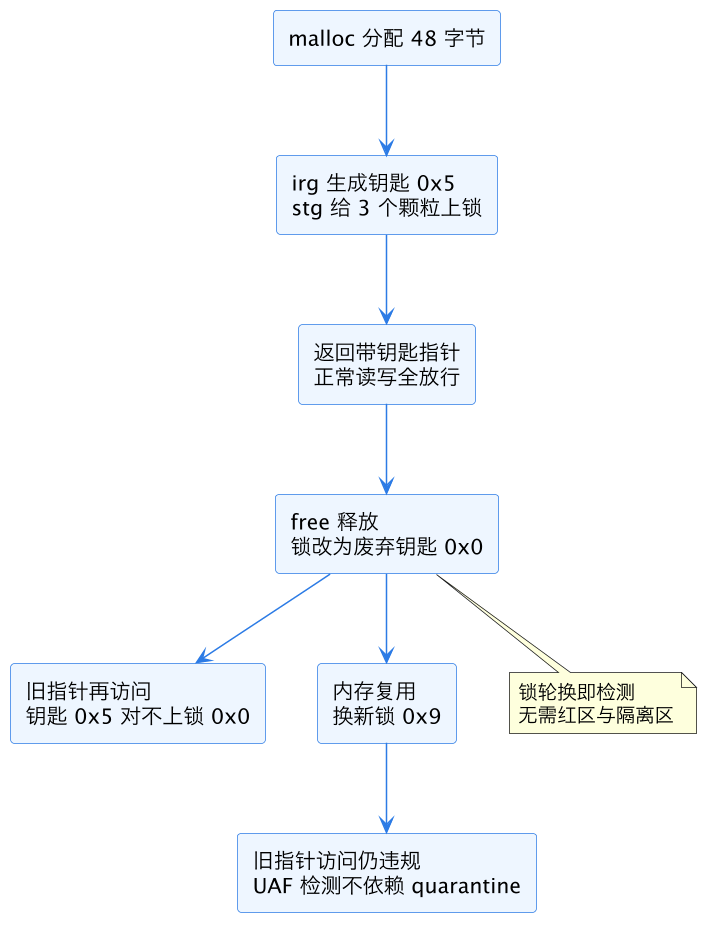
上图里最能体现 MTE 价值的是右下那条路径:释放与复用两步锁轮换,让悬空指针在任何时刻都开不了锁。当然 4 位标签的天花板也在这里——只有 16 个钥匙值,攻击者反复尝试有 1/16 的碰撞概率,相邻分配错开钥匙后,溢出恰好落进同钥匙邻居的概率也是 1/16 量级。所以 MTE 的定位是「概率性检测」而不是「确定性防护」:对随机触发的野生 bug 检出率约 93.75%(15/16),对刻意构造的定向攻击则要靠多次尝试时的异常噪声来放大暴露面。想靠增加标签位数提升安全性,就会挤压 TBI 仅剩的位并推高 tag 存储开销,4 位是工程上的平衡点。
| 检测能力 | ASan 软件插桩 | ARM MTE 内存标记 |
|---|---|---|
| 堆溢出 | 红区加影子内存,确定性 | 邻居钥匙错开,16 字节粒度,约 93.75% |
| use-after-free | quarantine 隔离区,内存膨胀 | 锁轮换,不依赖隔离区 |
| 栈溢出 | 栈对象插桩 | MTE 不覆盖栈(栈有 PAC 与栈保护) |
| 全局变量 | 插桩红区 | 不覆盖全局变量 |
| 检出确定性 | 确定 | 概率性,16 值随机 |
三、三种模式:同步精确、异步低开销、不对称折中
MTE 的硬件检测可以配置成三种模式,差异在「发现违规后怎么办」,直接决定性能与可调试性。
同步模式(synchronous,内核里 TCF_SYNC):load/store 触发比对失败的指令当场被拦住,CPU 抛同步异常,内核收到的 ESR(异常综合寄存器)里带着精确的出错地址、出错指令地址和是读还是写。定位信息完整,崩溃现场就是案发第一现场,调试体验与 ASan 相当。代价是每次访存的比对要在访存指令退休前完成,锁的读取必须在关键路径上——尽管 ARM 在实现里给 tag 配了类似 cache 的 tag cache 加速,同步模式下热路径仍有可测开销。
异步模式(asynchronous,TCF_ASYNC):比对失败不拦指令,硬件只是把「某条指令在某个带错钥匙的地址上踩了雷」记录进一个只写一次的系统寄存器(TFSR_EL1),由内核定期或在中断上下文里检查,发现置位后给进程发 SIGSEGV。访问路径完全不等待比对结果,流水线零停顿,开销最低;代价是崩溃点离案发点已经跑远了,TFSR 里只有受害地址没有凶手指令地址,调试价值大幅下降,更适合生产环境的「抓到就行、崩溃样本回传」场景。
不对称模式(asymmetric,ARM 后来补的 TCF_ASYMM):读用异步、写用同步。理由是写违规(溢出写、UAF 写)是真正造成破坏的动作,值得同步抓现行;读违规更多是信息泄露,异步记录已够。这是手机厂商在「安全收益」与「性能预算」之间拧出来的折中档。
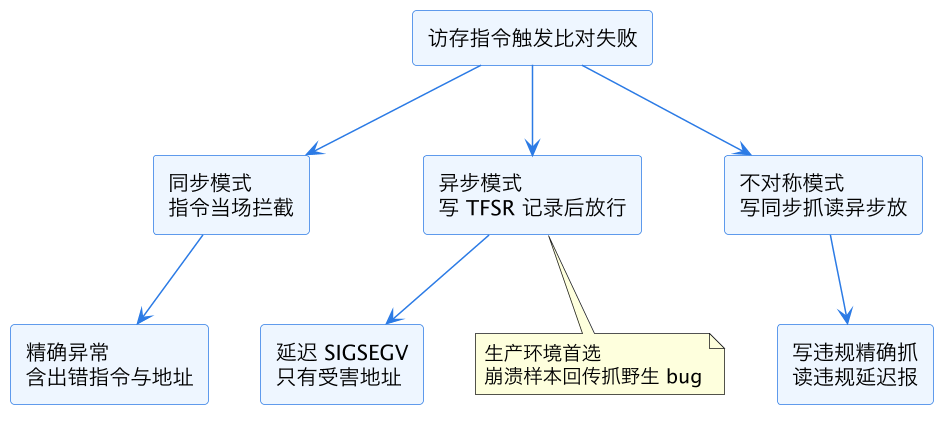
上图把三种模式的判定路径并排摆开,可以看到它们的差异不在「检不检测」而在「何时收网」。工程实践里的常见搭配是:开发与内测用同步模式追求可调试性,生产灰度用异步或不对称模式把开销压进预算。
四、性能开销:省掉插桩之后还剩什么
MTE 相对 ASan 的节省来自三处:不需要每条访存前后插入影子内存检查代码(指令数不膨胀)、不需要影子内存(省约 1/8 到 1/6 的地址空间映射与对应 cache 流量)、不需要红区与强制 quarantine(内存占用回落)。剩下的开销主要在四个地方。
第一是 tag 存储本身的内存税。每 16 字节配 4 位锁,等于固定 3.1% 的内存膨胀(4bit/128bit)。ARM 的实现把 tag 放在内存控制器侧专用 SRAM 或借 ECC 位(服务器上常见做法),对可用物理内存的占用比 ASan 的影子内存小一个量级。
第二是分配与释放路径变长。malloc 要 irg 加一串 stg 上锁,free 要重新上废弃锁,大对象按 16 字节逐颗粒写锁。分配器普遍用 stzg(上锁同时清零)合并掉 calloc 的 memset,把两步并一步,缓解了不少。
第三是同步模式下访存路径多等一拍 tag 读取。ARM 在核内给 tag 配了 tag cache(与数据 cache 并行的小表),热数据命中时开销很小;冷数据要去内存系统取 tag,同步模式下这一拍就在关键路径上。
第四是页表与内核的配套管理成本:带标记的页要设置对应的页面属性,fork 时 tag 随内存复制,换页时 tag 也要随页换出换入(内核把 tag 存进 swap 槽位的元数据)。
实际数字方面,Google 在 Pixel 设备上公开的评估是:异步模式下多数真实负载开销在 1% 以内到个位数百分比,同步模式在访存密集负载上可到 10% 量级;这与 ASan 动辄翻倍形成代差,也是「MTE 能进生产、ASan 不能」的分水岭。
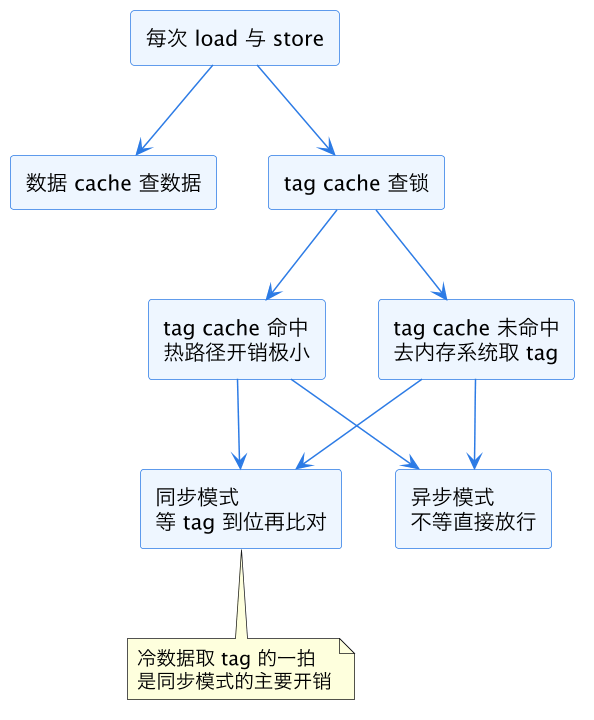
上图解释了为什么同是 MTE、模式不同开销差一截:同步模式的代价集中在 tag cache 未命中时「等 tag」的那一拍,异步模式干脆不把这拍放进关键路径。性能分析时如果在 ARM 平台上看到访存密集循环的开销异常,先确认进程跑在哪种 TCF 模式下(/proc/<pid>/status 或 prctl 状态可查),观测手段与通用计数器方法见 PMU 性能计数器编程。
五、部署现状与选型:谁在用、怎么用、和 MPK 怎么分工
芯片侧,ARM 从 Armv8.5-A(2019 年发布)定义 MTE,真正量产落地等到 2023 年前后的旗舰手机 SoC——联发科天玑 9200 系列率先开启,Google Pixel 8 起的 Tensor G3 是知名度最高的 MTE 商用载体,ARMv9 架构把 MTE 列为标准特性后,中高端芯片逐步跟进。服务器侧进展慢一些,Neoverse 平台把 MTE 纳入路线图,但服务器更关心 ECC 与 RAS,MTE 的优先级排在后面,相关背景见 Memory RAS 与 ECC 巡检擦除。
系统侧,Android 是最积极的:AOSP 的 Scudo 分配器原生支持 MTE,Pixel 8 起开发者选项里可以全局开启,部分厂商默认给系统服务与浏览器进程开异步模式,第三方应用通过 manifest 标记 android:memtagMode 自行声明。Linux 主线内核从 5.10 起合入 MTE 支持,用户态通过 prctl(PR_SET_TAGGED_ADDR_CTRL) 开启,glibc 提供 mallopt 级别的开关。Chrome 渲染进程、Android 媒体编解码服务这类攻击面最大的组件是优先受益者。
对开发者的接入成本很低:多数 C/C++ 代码重编译即可获益,因为分配器内部完成了上锁;真正需要改代码的是「手工内存池」「绕过 malloc 直接 mmap 自己管理」的组件,以及那些本来就在顶字节藏私货(比如自己实现 tagged pointer)的老代码——它们的顶字节被钥匙占了,行为会变。
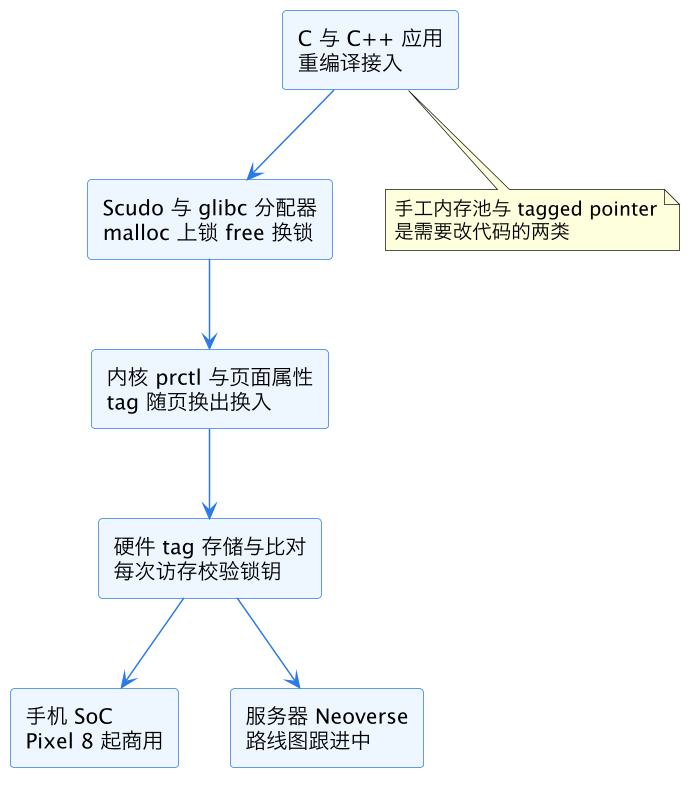
上图是自顶向下的部署栈:应用只负责重编译,锁的生成与轮换由分配器接管,内核管理 tag 的页级生命周期,硬件做最终比对。这个分工让 ARM MTE 内存标记成为近十年对开发者最友好的硬件安全特性之一。
最后和 x86 阵营的 MPK 内存保护密钥 做个定位对比,两者常被混淆:MPK 是「域隔离」——以页(4KB)为粒度,用 4 位 pkey 把进程的页划分成最多 16 个保护域,靠一条 WRPKRU 指令切换当前可访问域,目标是防「越权组件读隔壁数据」(典型场景是 OpenSSL 把私钥页锁起来);MTE 是「对象级错误检测」——以 16 字节为粒度,在每次访存时校验指针与对象的匹配,目标是抓野生的越界与 UAF。粒度、触发方式、防护目标都不同,可以互补共存:同一进程里既用 MPK 分域、又用 MTE 检错。ARM 自己的域隔离对应物则是另一组特性(POE、以及 PAC 管指针完整性),共同构成 ARM 的内存安全组合拳。
| 维度 | ARM MTE 内存标记 | Intel MPK/PKU |
|---|---|---|
| 粒度 | 16 字节颗粒 | 4KB 页 |
| 位数 | 4 位标签 | 4 位 pkey |
| 校验时机 | 每次访存自动比对 | 域切换后按域权限判定 |
| 防护目标 | 堆溢出与 UAF 检错 | 组件间域隔离 |
| 部署方式 | 重编译加分配器支持 | 手工 pkey_alloc 与 WRPKRU |
这一篇在知识体系里的位置
本篇是微架构模块「硬件内存安全线」的 ARM 篇。同线的 x86 对照篇是 MPK 内存保护密钥——域隔离思路的硬件实现,与本篇对象级检错思路互补。服务器内存可靠性侧的背景见 Memory RAS 与 ECC 巡检擦除;瞬态执行侧的硬件防护见 CET 影子栈与 IBT 与 Spectre 与 Meltdown 瞬态执行原理。MTE 开启后的性能观测方法沿用 PMU 性能计数器编程。全景地图见 CPU 微架构总览。
总结
ARM MTE 内存标记把内存安全检测从软件插桩搬进硬件:内存按 16 字节颗粒上 4 位的锁、指针高 4 位携带钥匙,malloc 时 irg 出钥匙并用 stg 上锁、free 时换废弃锁,此后每次 load/store 硬件自动比对锁钥,邻居溢出约 93.75% 概率当场被抓、use-after-free 因锁轮换不依赖隔离区即可检出;同步模式给精确现场但访存密集负载开销到 10% 量级,异步模式只记 TFSR 寄存器延迟收网、生产开销压进 1% 到个位数,正是这个开销档位让 MTE 继 Pixel 8 起的手机 SoC 之后真正走进生产环境,成为 ASan 这类 2 倍税软件方案够不着的那格——与 MPK 的页级域隔离互补,一个抓对象级错误、一个防组件越权,共同构成硬件内存安全的两条腿。