扇区缓存:把 cache line 切成扇区管理的有效位粒度、带宽收益与整行分配的取舍
更新时间:2026-10-04。我们都知道缓存以 cache line(缓存行,通常 64 字节)为最小分配单位:哪怕只读一个字节,未命中时也要从下一级存储拉回整行 64 字节。这条「整行搬运」的铁律简单好用,但当工作集的空间局部性差、或者内存带宽成为瓶颈时,它就显得浪费——拉回来的 64 字节里可能只有 8 字节被真正用到,其余 56 字节白占了宝贵的带宽和容量。扇区缓存(sectored cache,也叫子块缓存 sub-block cache)就是对这条铁律的松动:标签仍按整行管理,但有效位、脏位乃至数据搬运的粒度下沉到「扇区」(sector,常见 16 或 32 字节),未命中时只取回真正需要的那一段。它是 GPU 缓存的标准设计,在 CPU 的某些层级也屡有出现。上游背景见 CPU 微架构总览 与 缓存替换策略 LRU 家族,相干的写策略见 写分配与写回策略。
本文要回答的问题
- 扇区缓存到底把什么「切小」了?标签、有效位、脏位、数据搬运各自的粒度分别是多少?
- 为什么扇区化能省内存带宽?省的是哪一段流量?
- 扇区化对失效率和缓存容量利用率有什么影响,为什么会同时有利和有弊?
- 有效位按扇区、标签按整行的「一标签多有效位」结构,硬件上要付出什么代价?
- 扇区缓存与整行分配策略各自适合什么负载?软件能观测和利用吗?
一、扇区缓存的组织:一个标签,多个扇区有效位
普通缓存的组织是「一标签一数据块」:每一路(way)上一个标签项对应一整行 64 字节数据、一个有效位、一个脏位(假设写回)。扇区缓存把它改成「一标签多扇区」:标签项还是按整行地址匹配,但数据阵列被切成 S 个扇区(比如 4 个 16 字节扇区或 2 个 32 字节扇区),每个扇区有自己独立的有效位和脏位。
这意味着一个标签项可以处于「部分有效」状态:标签命中了,但你访问的那个扇区的有效位是 0——这叫扇区级未命中(sector miss),硬件只去下一级取这个扇区,而不是整行。反过来,整行标签未命中(tag miss)时,可以只为新行分配标签并取回触发访问的那一个扇区,其余扇区保持无效。
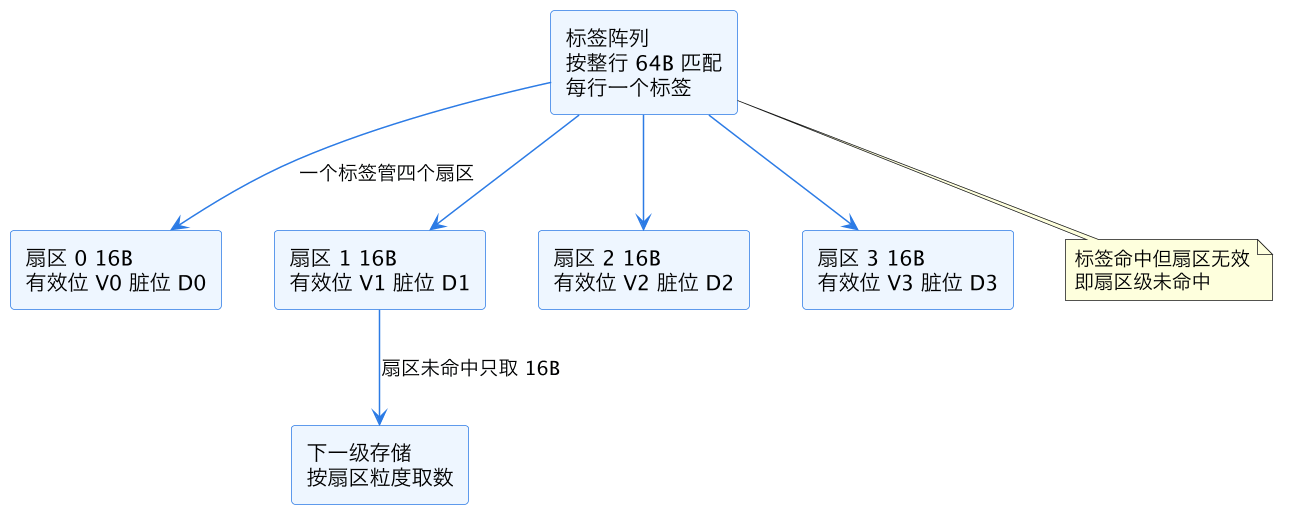
上图是一个 4 扇区行的结构:标签按整行匹配,四个扇区各自带 V/D 位,未命中时只有被访问的扇区走向下一级的取数路径。注意标签的匹配粒度没变,所以组相联结构、替换策略都照常工作——变的是「行内部的有效性状态」从一比特变成了一排比特。
这里有个容易混淆的点:扇区不是更小的 cache line。更小的 cache line 意味着每个 16 字节块都有自己的标签,标签阵列的存储开销翻四倍;扇区缓存的精髓恰恰是标签不复制,只复制几个状态位。下面这张表把三种组织摆在一起。
| 组织方式 | 标签粒度 | 有效位粒度 | 取数粒度 | 标签开销 |
|---|---|---|---|---|
| 64B 整行缓存 | 64B | 64B | 64B | 基准 |
| 16B 小行缓存 | 16B | 16B | 16B | 4 倍标签位 |
| 4 扇区 64B 行 | 64B | 16B | 16B | 只多 3 个有效位加脏位 |
扇区缓存用极少的硬件代价拿到了小行缓存的大部分带宽收益,这就是它存在的原因。
二、有效位与脏位的粒度变化:状态位怎么管
粒度下沉之后,状态管理多了几个普通缓存不存在的细节。
第一,扇区的填与换可以不同步。整行替换时,某些扇区可能还是干净的,直接丢弃;某些扇区是脏的,要按扇区写回。于是写回缓冲里流动的也是扇区级数据,写回流量同样被扇区粒度削小。
第二,一致性协议的事务粒度。监听(snoop)还是按整行地址来的,但数据供给可以按扇区做——多核间转发只转被请求的那个扇区。这与 缓存一致性协议 MESI 到 MOESIF 里的状态机并不冲突:状态位仍可挂在行级,扇区级有效位是行内部的细化。有些设计把协议状态也部分下沉到扇区(比如目录里记录行的哪些扇区在谁手里),进一步压缩片上互连的传输量。
第三,预取器与扇区的互动。硬件预取器(见 硬件预取器步长与流)在扇区缓存里可以只预取预测会用的扇区,误预取的代价从 64 字节降到 16 字节——预取激进度因此可以调高,预取覆盖率的账更好算,量化方法见 预取准确率与覆盖率。
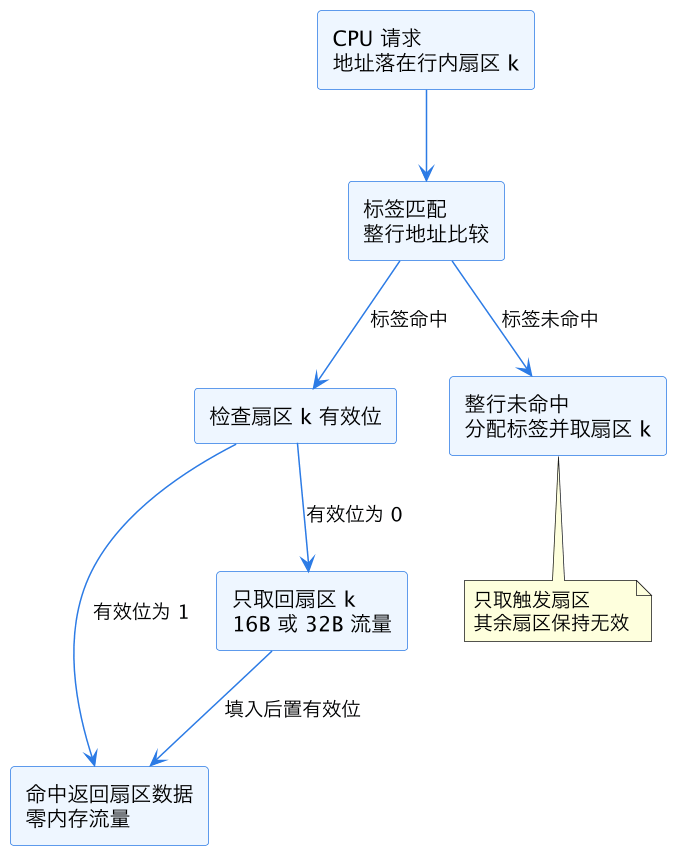
上图是扇区缓存的命中判定流程:比普通缓存多了「标签命中后再查扇区有效位」这一层。这条两级判定是全部收益的来源——第二层为 0 时,流量被精确裁剪到扇区大小。
三、带宽收益:省的到底是哪段流量
扇区化最直接的好处体现在带宽上。算一笔账:假设负载是随机访问 8 字节字段(典型的指针追逐、哈希表探测),整行缓存每次未命中从下一级拉 64 字节,扇区缓存(16B 扇区)只拉 16 字节。同样一次未命中,内存侧流量降到四分之一。在带宽饱和的场景——比如大并发随机读、GPU 的离散 gather——有效吞吐直接翻几倍。
省的是两段流量:
- 填充流量:未命中时的取数从整行变成扇区。
- 写回流量:脏位按扇区后,被替换的行只需要写回脏扇区。对写局部性差的负载(分散更新大数组),写回流量同样按扇区比例下降。
还有一个间接收益:对 DRAM 更友好。一次只取 16 字节时,内存控制器可以更灵活地调度突发,把省下的总线周期让给其他请求,行缓冲利用模式也更紧凑,背景见 DRAM 行缓冲命中策略。
| 负载特征 | 整行缓存流量 | 扇区缓存流量 | 带宽收益 |
|---|---|---|---|
| 纯顺序流 | 64B 每次未命中 | 全部扇区最终都取 | 几乎没有 |
| 8B 随机字段访问 | 64B | 16B | 约 4 倍 |
| 32B 跨度步长访问 | 64B | 16B 或 32B | 约 2 到 4 倍 |
| 分散写加替换 | 64B 写回 | 只写回脏扇区 | 视脏扇区比例 |
注意第一行:顺序流下扇区缓存不占便宜——空间局部性完美时,整行的每个字节迟早都会被用,分批取只是增加了请求次数,没有任何带宽节省。扇区化的收益与负载的空间局部性成反比,这是理解它的总开关。
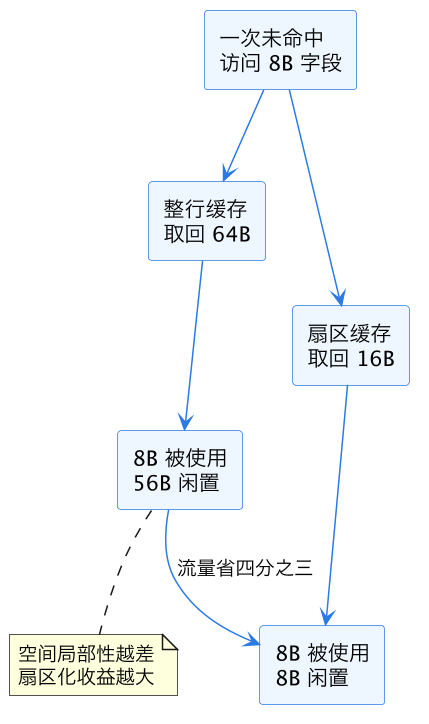
上图把两种组织下「取回来的字节里有多少真被用上」画了出来:整行缓存的闲置部分就是扇区缓存省下的带宽。GPU 的 L1/L2 普遍扇区化(常见 32B 扇区、128B 行),正是因为图形与通用计算负载的 warp 内访存常常只覆盖行的一部分。
四、失效率与容量:一枚硬币的两面
扇区化对失效率的影响是双向的,这也是取舍最微妙的地方。
有利的一面是容量利用率。整行缓存里,一行只要被取回来就占满一个 way 的全部 64 字节,即使程序只碰其中 8 字节,其余 56 字节也在占坑——这些「死字节」挤压了其他行的驻留空间,间接抬高容量性未命中。扇区缓存里,无效扇区不存有效数据,同样的 SRAM 里能容纳更多「真正被使用的字节」。对于工作集由大量稀疏小字段构成的负载(图计算的顶点属性、稀疏矩阵的非零元),等效容量明显变大,失效率下降。
不利的一面有三处。
第一,空间局部性红利被放弃。整行搬运本质上是一次「免费的空间预取」:顺序扫描下一个 64 字节块时直接命中。扇区缓存把这次预取撤了,顺序扫描变成每 16 字节一次未命中——未命中次数翻四倍,虽然每次只取 16 字节,总流量不变,但未命中处理的开销(MSHR 占用、流水线停顿)按次数计,不按字节计。MSHR(未命中状态保持寄存器)是跟踪在途未命中的硬件条目,数量有限,见 MSHR 未命中状态寄存器:扇区化让同样一段顺序流消耗四倍的 MSHR 项,内存级并行度(MLP)反而可能先被 MSHR 耗尽卡住。
第二,部分有效行的替换尴尬。替换算法看到的是「行」,但一行可能只有一个扇区有效。踢掉一个「四分之三无效」的行很划算,踢掉一个全有效的行代价大——标准 LRU 不区分这两者,需要扇区感知的替换策略才能吃到容量红利,否则红利打折扣。
第三,标签开销变相摊薄。扇区缓存的标签仍按整行存,如果负载只用到每行一个扇区,相当于用整行的标签预算服务四分之一的有效数据——与真正的 16B 小行缓存相比,标签利用率低了。好在标签位在缓存总面积里占比不大,这一刀通常可以接受。
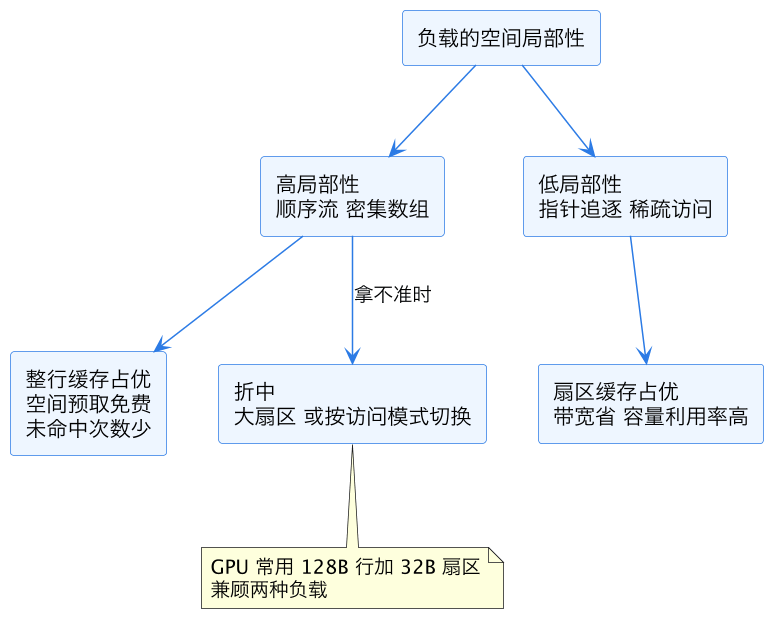
上图把「选整行还是选扇区」的决策轴画了出来:轴心只有一个变量——负载的空间局部性。拿不准时的折中方案也很常见:用大扇区(32B 而不是 16B),或者保留整行搬运但只给被访问扇区置脏(混合策略)。
五、与整行分配的取舍:硬件实例与工程考量
把前几节的账汇总成决策表。
| 维度 | 整行分配 | 扇区分配 |
|---|---|---|
| 未命中填充流量 | 整行 64B | 扇区 16B 或 32B |
| 顺序流未命中次数 | 少(空间预取内建) | 多(每扇区一次) |
| MSHR 压力 | 低 | 高 |
| 容量利用率 | 死字节占坑 | 无效扇区不占有效数据 |
| 写回流量 | 整行写回 | 只写回脏扇区 |
| 硬件复杂度 | 一个 V/D 位 | 每扇区 V/D 位加两级判定 |
| 典型采用者 | 主流 CPU 各级缓存 | GPU L1/L2、部分 CPU 的特殊缓存 |
CPU 侧的主流选择是整行分配,原因是 CPU 负载里顺序与准顺序访问占比高,MSHR 只有 10 到 16 项(见 MSHR 未命中状态寄存器),经不起扇区化带来的未命中次数翻倍。填充路径的缓冲(Intel 的 Line Fill Buffer,见 Line Fill Buffer 结构)也是按整行组织的。GPU 侧相反:一条 load 指令 32 个线程各自离散访问,整行搬运会放大 32 倍浪费,所以 GPU 缓存清一色扇区化,并配远超 CPU 的在途未命中容量。还有些设计走中间路线:整行取回但允许「关键扇区优先」(critical sector first),先满足触发请求的扇区再继续填其余扇区——这是整行缓存对扇区思想的折中吸收,本质是把扇区化的延迟收益拿过来、放弃它的带宽收益。
六、软件能做什么:观测与数据结构侧的利用
软件无法切换缓存的扇区组织,但能顺着它的脾气写代码。
- 字段对齐到扇区边界:把热字段聚在同一个 16B 或 32B 扇区内,冷字段挪走(structure splitting),让每次扇区取数都物有所值。
- 指针密集型结构主动按扇区裁剪节点大小:哈希表桶、树节点如果一个扇区装得下,就比跨扇区省一半未命中。
- 观测侧用 PMU 区分:用
MEM_LOAD_RETIRED类事件估算未命中次数,再对比内存控制器的实际字节流量(见 PMU 性能计数器编程)。如果「平均每未命中字节数」远小于 64,说明硬件已经在按扇区搬数,或者你的整行取回大量浪费——前者是扇区缓存在干活,后者提示数据结构该重排了。 - 在 GPU 上反过来做:尽量让 warp 内访问合并到最少的扇区数,coalescing 的量化单位就是扇区而不是行。
这一篇在知识体系里的位置
本篇是微架构模块「缓存组织线」上专讲行内粒度的一篇。上游是 缓存替换策略 LRU 家族(替换看的是行,扇区化后行内状态更丰富)与 写分配与写回策略(脏位粒度决定写回流量)。同线相邻的还有 缓存一致性协议 MESI 到 MOESIF(协议状态与扇区有效位的分层)、MSHR 未命中状态寄存器(扇区化放大未命中次数的直接约束)、Line Fill Buffer 结构(整行填充路径的对照组)与 硬件预取器步长与流(扇区级预取的互动)。全景见 CPU 微架构总览。
总结
扇区缓存把 cache line 的「标签匹配」与「有效性管理」解耦:标签仍按整行 64 字节比较,有效位和脏位下沉到 16 或 32 字节扇区,未命中时只从下一级取回触发访问的那一个扇区——它用小行缓存几分之一的硬件代价(只多几个状态位、标签不复制),换来低空间局部性负载下最高约 4 倍的内存带宽节省和更高的容量利用率,代价是放弃了整行搬运内建的免费空间预取:顺序流下未命中次数成倍上涨、MSHR 压力加大、替换策略需要扇区感知才能吃到容量红利;于是 CPU 主流坚守整行分配(负载顺序性好、MSHR 金贵),GPU 全面拥抱扇区化(离散访问、在途未命中容量大),软件侧则通过热字段扇区对齐、结构拆分与 PMU 流量比对,顺着硬件的粒度脾气把这笔账算到自己这边。