瞬态执行侧信道:Spectre 与 Meltdown 的微架构机理、攻击链与缓解措施性能代价
更新时间:2026-09-30。2018 年初 Spectre 与 Meltdown 的公开,把「微架构优化」这个原本只属于性能工程师的话题变成了安全界的头条:过去二十年里为了让 CPU 跑得更快而做的乱序执行、分支预测、推测加载,每一项都在体系结构状态之外留下了一份「影子账本」,而这份账本可以被对手读出来。本站的微架构系列已经把零件逐个讲透了:CPU 乱序执行 讲 ROB 与推测窗口,分支预测 和 间接分支预测 讲预测器怎么被训练,精确异常与流水线冲刷 讲错误推测怎么回滚,MESI 缓存一致性协议 讲缓存行的状态机。这一篇是枢纽:把这些零件拼成一条完整的攻击链,回答「瞬态执行侧信道为什么存在、怎么打、怎么防、防了要付多少性能税」。
本文要回答的问题
- 瞬态执行(transient execution)和体系结构执行之间那条缝是怎么产生的?
- Meltdown 和 Spectre 分别利用哪个硬件机制,攻击链各分几步?
- 为什么缓存侧信道能把「不可见的推测结果」变成可读的数据?
- 缓解措施(KPTI、retpoline、微码、lfence)各自堵住哪个环节,性能代价多大?
- 作为性能工程师,怎么评估自己的系统是否该开、开哪些缓解?
一、瞬态执行:体系结构状态与微架构状态的两本账
现代高性能 CPU 的核心矛盾是:指令流是串行语义,硬件执行是并行乱序。为了在语义上维持「一条一条按序执行」的假象,硬件把执行拆成两本账——体系结构状态(architectural state,寄存器、内存、PC,程序员可见)和微架构状态(microarchitectural state,缓存内容、预测器历史、TLB、store buffer,程序员原则上不可见)。乱序执行引擎让指令提前跑,ROB(重排序缓冲)按序退休,发现推测错了就冲刷流水线、回滚体系结构状态,就像什么都没发生过——这套机制的完整细节见 ROB 重排序缓冲 和 寄存器重命名。
问题在于:回滚只回滚体系结构状态,微架构状态不回滚。一条被冲刷的推测加载,它从内存读进缓存的那一行不会因此被踢出去;一次错误的路径推测,分支预测器里训练出来的历史位不会倒带。在安全边界内这无所谓——反正都是同一个进程自己的数据。但一旦推测路径上访问了「本不该被读到」的数据,并且推测代码把这个数据的值编码进微架构状态(比如用它当索引去摸不同的缓存行),那么即使整条推测路径被冲刷,编码的信息依然留在缓存里,等待被侧信道读出。这就是瞬态执行侧信道的本质:执行是瞬态的,痕迹是持久的。
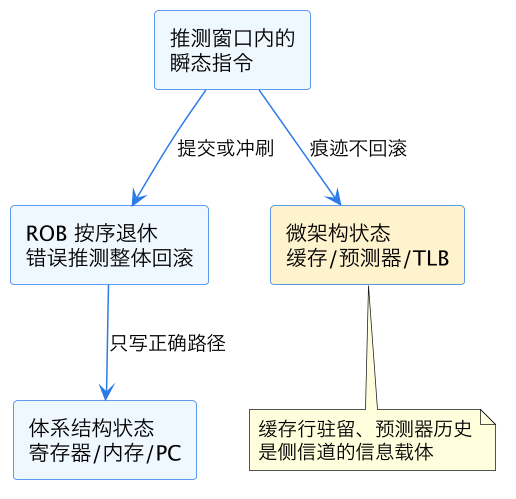
上图画出了两本账的关系。瞬态指令向下同时触碰两条路径:走向 ROB 的那条会被精确异常机制严格裁决——对就退休,错就抹掉;走向微架构状态的那条没有任何裁决机制,摸到什么都留下指纹。Spectre 和 Meltdown 的全部变体,差别只在「瞬态指令是怎么被诱发的」和「读到的是什么数据」,而「痕迹不回滚」这一环是共同的。
二、Meltdown:乱序执行越权读内核数据
Meltdown(CVE-2017-5754, Rogue Data Cache Load)打的是乱序执行与权限检查之间的竞态。x86 的页表项里有 U/S 位标记用户态是否可访问,内核页映射在为用户态预留的页表里但标为 supervisor。体系结构语义上,用户态指令访问内核地址必然触发 page fault。但硬件实现上,权限检查在流水线中比数据读取到得晚——乱序引擎在 fault 被确认之前,就已经把内核数据从缓存里取回来,并且让依赖它的后续瞬态指令继续执行了。
攻击链分四步:
- 布置:攻击者准备一块自己可控的探测数组
probe[256 * 4096],提前把它全部驱逐出缓存(clflush或靠 eviction set)。 - 触发:执行一条指向内核地址的加载
x = *kernel_addr。这条加载注定 fault,但 fault 要在 ROB 退休点才被确认。 - 编码:在 fault 被确认前的几十到几百拍窗口里,后续瞬态指令
y = probe[x * 4096]已经执行,把机密的字节值x编码成「探测数组里哪一页被摸进缓存」。 - 读出:fault 落地、异常处理返回后,攻击者逐页测量探测数组的访问延迟,最快的那一页的下标就是
x的值——这一步就是经典的 Flush+Reload 缓存侧信道,其延迟测量的原理与 缓存访问流水线与时序 里讲的命中/未命中延迟差完全同源。
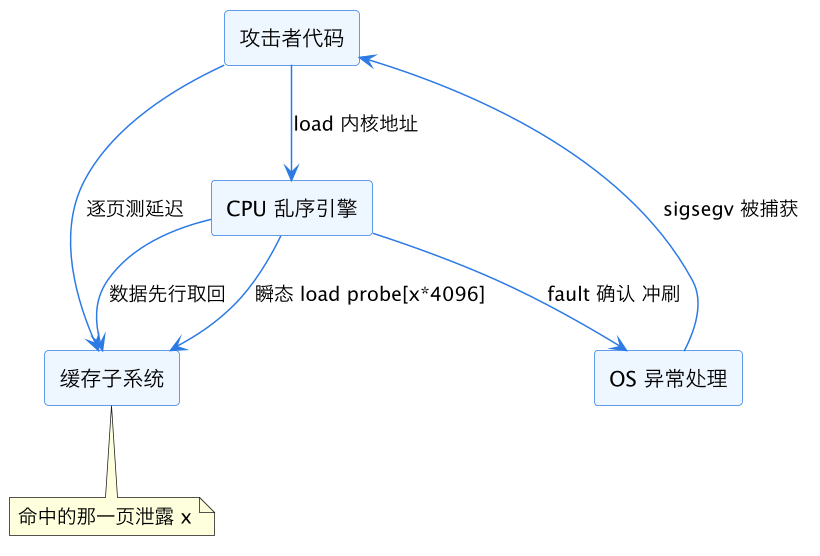
上图的关键在时序错位:数据取回在前,fault 确认在后。架构师当年的假设是「fault 会冲刷一切,所以前面跑了什么无所谓」——在功能正确性上这个假设成立,在信息安全上它漏掉了缓存这个旁路。Meltdown 影响面集中在 Intel(因为 AMD 和多数 ARM 核在 load 级就做权限拦截),但它率先证明了「瞬态窗口 + 微架构痕迹」这个攻击范式可行,后来的变体(Foreshadow、ZombieLoad、RIDL)都是同一范式在 store buffer、fill buffer 等其他微架构部件上的复制,与 store buffer 和 store-to-load forwarding 这些优化机制直接相关。
瞬态窗口有多大,直接决定攻击的可靠性。窗口的长度取决于 fault 从发生到在 ROB 退休点被确认之间隔着多少拍:如果 fault 地址的页表项要走路径较长的页遍历,窗口可以拉长到几百拍,足够跑完编码加载;如果一切都在缓存里,窗口可能只有几十拍,编码指令未必来得及发射。攻击者的工程化手段是「异常抑制」:不用等 fault 真的抛出来,而是用事务内存(TSX)把整段攻击代码包进一个注定回滚的事务里,事务回滚本身不产生异常、不打断控制流,攻击循环可以全速跑;没有 TSX 的机器则注册 SIGSEGV 处理器或者用 setjmp/longjmp 接住异常。这些细节解释了一个反直觉的现象:Meltdown 的 PoC 在某些机器上字节错误率不低,需要多次采样投票,本质上就是在和瞬态窗口的长度赛跑。
三、Spectre:训练分支预测器替你干活
Meltdown 是「自己的乱序引擎越权」,Spectre(CVE-2017-5753 v1 边界检查绕过、CVE-2017-5715 v2 分支目标注入)更进一步:不需要自己的代码出异常,而是诱导受害者的代码在错误推测路径上泄露数据。它的杠杆是分支预测器——一个为了减少控制相关停顿而存在的硬件,其训练接口对同核上的一切代码开放。
以 Spectre v1 为例,受害者代码里有这种极其常见的模式:
if (index < array_len)            // 边界检查
y = probe[array[index] * 4096];攻击分三个阶段。第一阶段训练:攻击者反复用合法的 index 调用这段代码,让模式历史表学到「这个分支几乎总是 taken」,分支预测器的训练机制见 分支预测。第二阶段触发:喂一个越界的 index。此时 array_len 恰好不在缓存里(攻击者可提前驱逐),边界检查的比较要等内存延迟,预测器按历史直接猜 taken,推测路径上 array[index] 从越界地址读出一个字节,probe[...] 把它编码进缓存。第三阶段读出:等处理器发现 array_len 真值、确认误测、冲刷流水线时,缓存里已经留下痕迹,攻击者照旧用 Flush+Reload 解出机密字节。
Spectre v2 更狠:它污染的是间接分支的目标预测。受害者里一句 call *func_ptr,目标地址由 BTB 分支目标缓冲 预测。攻击者在同核上精心布置间接跳转,把 BTB 里对应槽位训练成指向受害者地址空间里的一段「gadget」——一段恰好能把机密编码进缓存的既有指令序列。这和 ROP 的思路神似,只不过拼接的媒介从栈换成了预测器。返回地址栈 RAS 同理可被污染(retpoline 出现前的 ret 推测)。
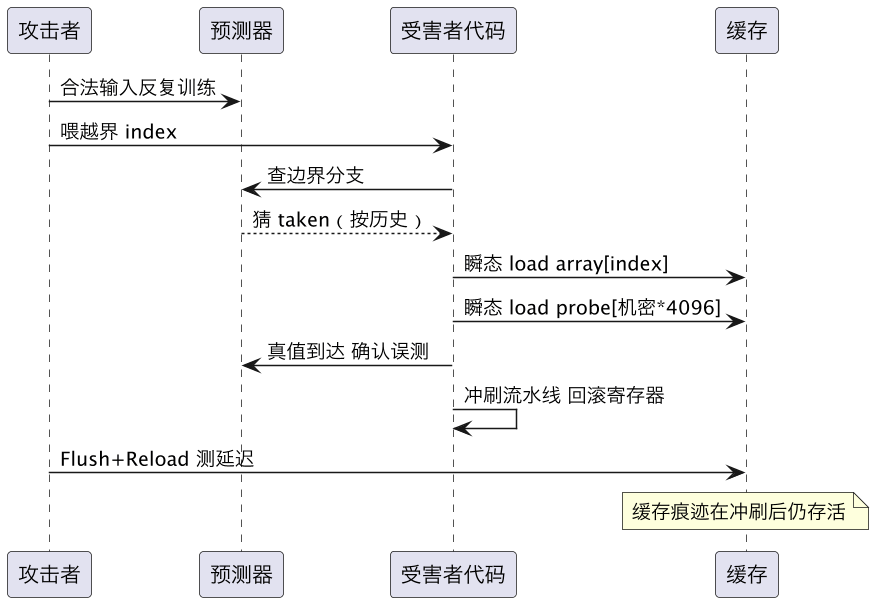
这张时序图标出了攻击里唯一的「静默存活点」:受害者自己冲刷了自己的流水线,体系结构状态干净如初,从受害者视角看没有任何异常发生过——这正是 Spectre 比传统漏洞更难检测的原因,入侵检测看的是体系结构行为,而泄露全程发生在体系结构视野之外。
Spectre 之所以让业界真正头疼,在于它不修一处而处处在。边界检查模式的代码在所有语言、所有二进制里俯拾皆是,任何一段带数组访问的代码理论上都能被改造成泄露 gadget;预测器又无法按进程完美隔离——它的索引哈希本来就是为了复用而设计的。这也是为什么 Spectre 公开后没有出现「一个补丁终结一切」:v1 要靠逐点插 lfence 或编译器的推测屏障(如 MSVC 的 /Qspectre、后来的 SLH 技术),v2 靠 retpoline 加微码,整个软件生态花了好几年才把主流攻击面压住。2019 年之后学术界又陆续给出了 netspectre(远程版,无需本地代码执行)、Speculative Store Bypass(v4,利用内存消歧推测,机制见 内存依赖预测)、以及 2022 年针对 retpoline 本身的 Retbleed——每一代防御都在被下一代研究重新审视,这条线的攻防至今没有画上句号。
四、缓存侧信道:把痕迹变成字节
无论 Meltdown 还是 Spectre,最后一英里都是同一件事:从缓存状态里把信息解出来。主流手段有三种,按攻击者条件选:
| 侧信道 | 前提条件 | 时间分辨率 | 典型带宽 | 对抗手段 |
|---|---|---|---|---|
| Flush+Reload | 与受害者共享内存页(库/页去重) | 高 | 高 | 禁用共享、打乱映射 |
| Prime+Probe | 只需同核或同 LLC,无需共享内存 | 中 | 中 | 缓存划分(CAT)、随机化映射 |
| Evict+Time | 只需让受害者产生可测时延差 | 低 | 低 | 常数时间编程 |
三者共同的物理基础是命中与未命中的延迟差:L1 命中约 4 拍,LLC 命中约 40 拍,主存 200 拍以上,这个量级差让纳秒级计时器(rdtsc)足以分辨,延迟数据的完整谱系可参考 内存各级延迟数据来源。Prime+Probe 不需要共享内存,靠的是缓存组相联的冲突驱逐——攻击者先用自己的数据占满目标缓存组(prime),受害者访问过的组会被挤出去(conflict),攻击者再访问一遍测哪些组变慢(probe);组相联映射的原理见 缓存组相联映射。
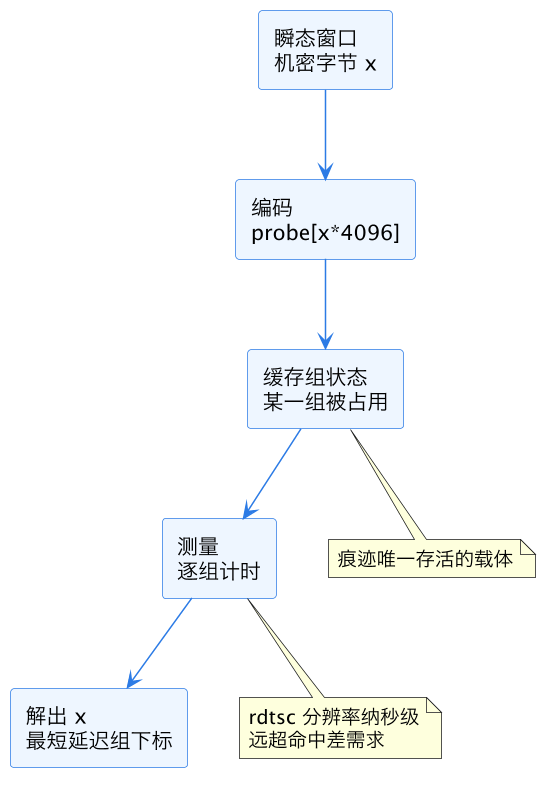
值得强调的是,缓存不是唯一的痕迹载体。后续研究证明执行端口占用、分支预测器状态、TLB、甚至功耗轨都能做侧信道——缓存只是信噪比最高、最容易远程复现的一个。学术界后续提出的禁用高精度计时器的浏览器对策(降低 performance.now() 精度)只是抬高门槛,Prime+Probe 类攻击用计数器放大的办法依然能恢复时钟,这一回合的攻防结论是:只堵测量端堵不住,必须堵痕迹的产生或跨安全域的共享。
从工程实践角度补充两个读出端的细节。第一,探测数组为什么要乘 4096 而不是乘缓存行大小 64:相邻字节的探测行会落在相邻缓存组,硬件预取器(其机制见 硬件预取器 stride 与 stream)会把邻近行一起拉进缓存,污染测量结果;乘以一个页的大小让 256 个候选值各占一个页,预取完全无法跨界,信噪比最高——但这也把探测数组撑到 1MB,在 LLC 较小的机器上需要更精细的驱逐策略。第二,多次采样投票不是锦上添花而是必需品:单次测量受中断、频率漂移、SMT 兄弟干扰影响,误码率可能高达几个百分点,工程化的攻击实现会对每个字节采样数百次取众数,把有效带宽和误码率压到可用区间。这两个细节再次说明,侧信道攻击的天花板往往不是原理而是测量工程学。
五、缓解措施全景:每一环都有补丁,每个补丁都有价签
瞬态执行侧信道的防御沿着攻击链的四个环节展开,每一环对应一类缓解,代价各不相同。
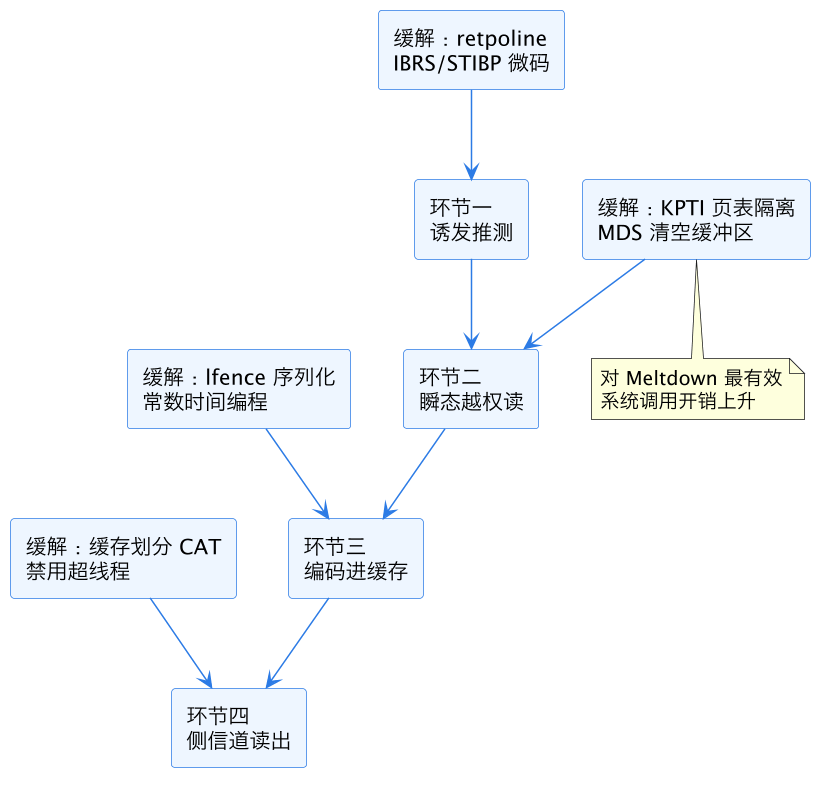
逐项展开:
KPTI(内核页表隔离,KAISER) 治 Meltdown。思路是不再依赖硬件权限位,而是把内核页从用户态页表里物理摘走:用户态运行时页表里几乎不含内核映射,只在进内核的系统调用入口切到完整页表。没映射就没有可瞬态读取的目标,Meltdown 釜底抽薪。代价是每次系统调用多两次 CR3 切换加 TLB 压力——好在 PCID 特性让带标签的 TLB 项不必全清,把开销从早期 benchmark 的 30% 压回个位数;系统调用密集负载(perf-bench 的 syscall 微基准、高 PPS 网络服务)仍然能看到 5–15% 的回退,观测方法见 perf bench kernel。
retpoline(return trampoline) 治 Spectre v2。编译器把间接调用改写成一段「先压返回地址、再 pause 自旋、最后 ret」的蹦床,让推测执行进入一个无害的死循环而不是 BTB 预测的目标。它不动硬件,纯软件绕开 BTB,但把一次间接跳转从约 2 拍拉长到 20 拍以上,间接调用密集的负载(解释器、虚函数热点、内核协议栈)损失明显。
微码级开关(IBRS、STIBP、SSBD) 是 Intel 后来给的硬件旋钮:IBRS 直接禁止跨权限级共享分支预测,STIBP 隔离 SMT 兄弟线程之间的预测器——这对防御「同核超线程兄弟是攻击者」的场景至关重要,因为预测器是两个硬件线程共享的,共享模型的细节见 SMT 同时多线程。代价同样实在:IBRS 全开在某些内核负载上测出过 20% 以上的回退,所以现代发行版倾向 retpoline 加按需 IBPB(上下文切换时清预测器)的组合。
lfence 与常数时间编程 治 Spectre v1。lfence 序列化指令流,让边界检查之后的指令必须等检查落定才能执行,直接在代码里掐死推测窗口——但它也把该处的乱序收益清零,只能点状用在真正处理机密的边界上。密码学库的终极答案是不让机密参与任何地址计算和分支条件,即常数时间编程。
缓存划分与禁用 SMT 治侧信道读出端。Intel CAT 可以把 LLC 按路划给不同安全域,让 Prime+Probe 摸不到对方的缓存组;云厂商的极端做法是对跨租户场景直接关 SMT,用一半的硬件线程换隔离强度。
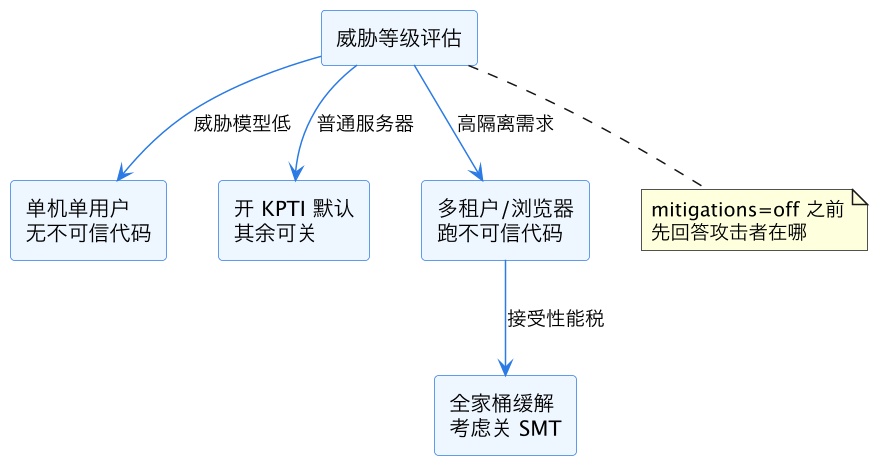
上图是实务决策路径。Linux 内核的 mitigations= 启动参数、各家 CPU 的漏洞披露页(/sys/devices/system/cpu/vulnerabilities/)是评估的起点,但真正的判据是威胁模型:你的机器上会不会跑别人的代码?浏览器里会不会跑别人的 JavaScript?答案决定你该付多少税。
六、性能工程师视角:怎么量化这笔税
缓解措施的性能代价不是一个数,而是一个分布,形状由负载的三个特征决定:系统调用频率、间接分支密度、缓存工作集大小。syscall 越密 KPTI 越疼,间接跳转越密 retpoline/IBRS 越疼,工作集越大 TLB 与缓存划分的边际损失越明显。评估方法论和普通的性能回归没有区别:固定基准、逐项开关、归因到具体机制。
实操上推荐三步。第一,用 perf stat 看缓解前后的 IPC、分支误测率、TLB miss、系统调用次数的差值,指标解读见 perf stat 指标深入 和 IPC 瓶颈。第二,用 分支误测分析 的流程确认 retpoline 是不是把某个热点的误测率打高了。第三,对系统调用密集型服务,直接对比开关 KPTI 的 QPS 曲线,内核侧观测可用 perf trace 追踪系统调用。一个常见误判是把 5% 的整体回退平均摊到所有缓解上——实际往往 80% 来自其中一项,定位到那一项后可以考虑用更精细的开关(比如只对含机密数据的进程开 SSBD)把税减下来。
长期看,硬件在补课:新一代 CPU 把权限检查提前到 load 流水线早期、给预测器加域标签、让冲刷连微架构痕迹一起清。但「性能优先、隔离后补」是过去三十年微架构演进写进骨子里的取舍,瞬态执行侧信道不会是最后一个从这条缝里长出来的漏洞类别——对性能工程师来说,理解两本账的存在,比记住任何一个 CVE 编号都更有用。
再给一组感性的数字锚点,帮助在评审会上快速对齐预期。一台 syscall 密集的 Nginx 反向代理,开关 KPTI 的 QPS 差距常见在 5% 上下;纯计算型负载(视频编码、科学计算)几乎无感,因为用户态几乎没有系统调用也没有多少间接分支要过 retpoline;受影响最重的是系统调用和间接跳转双高的负载——Redis 这类单线程高 QPS KV、内核协议栈路径深的网络转发、以及解释器型运行时,业界公开数据里出现过两位数百分点的回退。这组数字的含义是:「开不开缓解」从来不该是全机房一刀切的决定,而应该按负载画像分级——同一集群里计算池和网关池的 mitigations= 配置完全可以不同,省下的性能就是省下的机器。把缓解代价当成容量规划的一个输入变量,而不是安全团队下发的一个开关,是性能工程师在这个议题上能提供的最大价值。
这一篇在知识体系里的位置
本篇是微架构系列的安全向枢纽:上游依赖 CPU 乱序执行、精确异常与流水线冲刷、分支预测、间接分支预测 提供的机制底座;同层与 内存依赖预测、缓存一致性 MESI、TLB 与页遍历缓存 互为印证——每一个性能优化点都是潜在的侧信道载体;下游接性能评估方法 perf stat 指标、IPC 低排查流程,以及缓存观测的 缓存性能计数器测量。读完本篇,再回头看 微架构总览 里的每一张优化图,你会多一双「这在安全上意味着什么」的眼睛。
总结
瞬态执行侧信道的全部秘密就一句话:CPU 为了性能让指令先跑后审,回滚只擦体系结构状态不擦微架构痕迹,Spectre 与 Meltdown 分别从分支预测和乱序越权两个口子把机密送进这条擦不掉的痕迹里,再用缓存时序把它读出来——而所有缓解措施的本质,都是在攻击链的某一环上重新把「先跑后审」改回「先审后跑」,性能税就付在这里。