内存级访问延迟与数据源剖析
更新时间:2026-10-01。想知道程序慢是缓存还是远端内存,可直接采样每笔 load 的真实延迟和来源层级。
一、记录什么
支持的平台上 perf mem record(底层 PEBS mem / IBS)对每个采样 load 记录:地址、符号、使用延迟(use latency,拍)、数据源(命中 L1/L2/LLC,还是本地/远端 DRAM、MMIO)。
二、怎么用
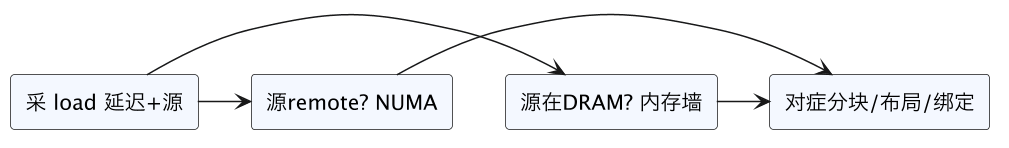
延迟短且源在 L1/L2 → 健康;大量样本延迟高、源在 DRAM → 内存墙;源是 remote DRAM → NUMA 配置问题(见 NUMA 局部性)。看分布尾部,定位具体结构体/数组后用分块、布局、就近分配解决。
三、常见坑
- 只看平均 miss,不看每 load 真实延迟。
- 忽略数据源里的 remote。
- 平台不支持 mem 采样时误以为事件坏。
小结
perf mem 把“延迟 + 来源层级”落到每笔 load,能区分缓存、内存墙与 NUMA,是数据侧最直接证据。下一篇 perf lock 锁剖析深入。
总结
想知道程序慢在缓存还是远端内存,可在支持的平台用 perf mem record(底层 PEBS mem/IBS)对每个采样 load 记录地址、符号、使用延迟和数据源(L1/L2/LLC、本地/远端 DRAM、MMIO):延迟短且源在 L1/L2 为健康,大量高延迟样本源在 DRAM 是内存墙,源在 remote DRAM 则是 NUMA 配置问题;别看平均 miss,要盯每笔 load 的真实延迟分布和尾部,定位到具体结构体/数组后用分块、布局优化、就近分配解决。