量化交易中的 FPGA 架构设计导读
1. 核心问题:为什么量化交易需要 FPGA
1.1 延迟是量化策略的第一性竞争力
在量化交易(尤其是高频交易 HFT)中,"快"本身就是阿尔法 —— 谁先看到行情、谁先执行订单,谁就吃掉价差。
tick-to-trade 延迟的定义:
bash
交易所撮合引擎发出行情报文 → 光纤 → 量化公司NIC → 行情解码 →
订单簿更新 → 策略计算 → 风控 → 订单打包 → NIC发出 → 光纤 → 撮合引擎
这个链条的任何一段延迟都直接折损策略收益。
1.2 软件优化的物理天花板
| 方案 | tick-to-trade 典型延迟 | 延迟抖动(jitter) |
|---|---|---|
| 普通 Linux 内核协议栈 | 30-100 μs | 数十微秒 |
| DPDK 用户态旁路 | 6-12 μs | 1-3 μs |
| Solarflare EF_VI 高端软件 | 3-6 μs | 数百纳秒 |
| FPGA 全硬件流水线 | 300-700 ns | 数十纳秒 |
软件方案在微秒级就碰壁的根本原因:
- 中断处理:即使 busy-poll,NIC 收包到用户态仍有 PCIe DMA + 上下文开销
- CPU 分支预测失败:行情数据不规律,预测成功率低
- 缓存缺失:订单簿状态散落在内存中,cache miss 带来数十纳秒惩罚
- OS 调度器抖动:即使 isolcpus,仍有 tick、RCU 回调等不可消除的干扰
FPGA 解决的不是某一环,而是从根本上消除了这些不确定性。
1.3 FPGA 的确定性延迟优势
| 特性 | CPU(冯·诺依曼) | FPGA(空间计算) |
|---|---|---|
| 执行模型 | 指令流顺序/乱序执行 | 硬件流水线,每个时钟确定 |
| 延迟可预测性 | 受缓存/分支/调度影响 | 精确到时钟周期 |
| 并行度 | 受限于核心数 | 无限制的细粒度并行 |
| 上下文切换 | 数十微秒 | 零(无需切换) |
| 中断 | 不可消除 | 不存在此概念 |
| 每周期处理的行情条数 | 1(SIMD 可并行少量) | 1(流水线每级同时处理不同条) |
2. CPU + FPGA 混合架构设计哲学
2.1 分工边界:"FPGA 做硬件化的触发器+路由器"
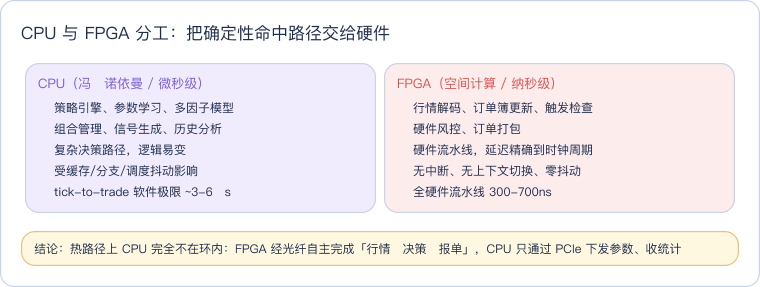
核心原则:FPGA 负责纳秒级的"确定性命中"路径,CPU 负责微秒级的"复杂决策"路径。
bash
┌─────────────────────────────────────────────────────────┐
│                         CPU 域                          │
│  ┌──────────┐  ┌──────────┐  ┌──────────┐              │
│  │ 策略引擎  │  │ 组合管理  │  │ 历史分析  │              │
│  │ 参数学习  │  │ 信号生成  │  │ 反馈回路  │              │
│  └─────┬────┘  └─────┬────┘  └─────┬────┘              │
│        │              │              │                   │
│        └──────────────┼──────────────┘                   │
│                       │ PCIe (参数/统计/控制)             │
├───────────────────────┼─────────────────────────────────┤
│                       ▼              FPGA 域             │
│  ┌──────────────────────────────────────────────────┐   │
│  │              硬件流水线 (100-300ns)               │   │
│  │  MAC → 解码 → 订单簿 → 触发 → 风控 → 打包 → MAC  │   │
│  └──────────────────────────────────────────────────┘   │
│         ▲                                      │        │
│         │           光纤                        │        │
│    ┌────┴────┐                          ┌──────┴─────┐  │
│    │  交易所  │                          │   交易所    │  │
│    │ 行情源  │                          │  订单网关   │  │
│    └─────────┘                          └────────────┘  │
└─────────────────────────────────────────────────────────┘
2.2 CPU 与 FPGA 的信息交换
| 方向 | 内容 | 频率 | 延迟要求 |
|---|---|---|---|
| CPU → FPGA | 策略参数(阈值、数量、开关) | 参数变更时 | 毫秒级 |
| CPU → FPGA | 风控限额更新 | 盘前/盘中 | 微秒级 |
| FPGA → CPU | 命中统计(成交量、PnL) | 实时流 | 微秒级 |
| FPGA → CPU | 异常告警 | 事件触发 | 微秒级 |
CPU 通过 PCIe MMIO 或共享内存(DMA buffer)与 FPGA 交换数据。热路径上 CPU 完全不在环内——FPGA 自主完成"行情→决策→报单"全链路。
2.3 策略迭代开发流程
bash
阶段一:纯软件验证
  C++/Rust 策略代码 → 回测 → 模拟盘 → 小资金实盘
  (确保策略逻辑正确和有利可图)
阶段二:软件优化
  内核旁路(DPDK/EF_VI)→ busy-poll → 无锁数据结构 → CPU 隔离
  (将延迟从 50μs 压缩到 5μs)
阶段三:部分 FPGA 化
  行情解码放入 FPGA → CPU 做策略 + 报单
  (延迟降到 1-3μs)
阶段四:全 FPGA 化
  解码+决策+风控+报单 全部硬件化
  (延迟压到 300-700ns)
3. 国内量化公司的四种典型 FPGA 架构模式
3.1 模式一:全硬件流水线(Full Hardware Pipeline)
bash
光纤 → MAC/PHY → 解码模块 → 订单簿模块 → 触发模块 → 风控模块 → 打包模块 → MAC/PHY → 光纤
         └─────────────────── FPGA 全在内部 ───────────────────────┘
                                     │ PCIe (仅参数与统计)
                                     ▼
                                   CPU
(旁观 + 监控)| 维度 | 说明 |
|---|---|
| 延迟 | 300-700 ns(业界最低) |
| 灵活性 | 低,策略变更需重新综合(数小时) |
| 开发周期 | 6-12 个月(RTL 开发 + 验证) |
| 适用场景 | 做市商、跨市场套利等对延迟极致的策略 |
| 国内典型用户 | 头部量化私募的自营做市系统 |
3.2 模式二:混合流水线(Hybrid Pipeline)
bash
光纤 → MAC/PHY → 解码模块 → 订单簿模块 ──┐
         └──── FPGA ────┘                  │
                                           │ PCIe DMA
                                           ▼
                                      CPU 策略引擎
                                      (C++/Rust 策略计算)
                                           │
                                           │ PCIe MMIO
                                           ▼
                             打包模块 → MAC/PHY → 光纤
└─── FPGA ───┘| 维度 | 说明 |
|---|---|
| 延迟 | 1-5 μs(FPGA 解码 + CPU 策略 + FPGA 报单) |
| 灵活性 | 高,策略在软件中可快速修改 |
| 开发周期 | 3-6 个月(FPGA 只做 I/O,C++ 做策略) |
| 适用场景 | 中高频策略、多因子、需要频繁调参的策略 |
| 国内典型用户 | 量化私募的 alpha 策略、CTA 策略 |
3.3 模式三:旁路加速(Bypass Acceleration)
bash
光纤 → MAC/PHY → 解码模块 → 策略引擎(软核 MicroBlaze/ARM) → 打包 → MAC/PHY
└────────────────── FPGA(内嵌软核CPU) ──────────────┘| 维度 | 说明 |
|---|---|
| 延迟 | 2-10 μs(取决于软核 CPU 性能) |
| 灵活性 | 中,C/C++ 运行在 FPGA 内嵌处理器 |
| 开发周期 | 2-4 个月(HLS 高级综合) |
| 适用场景 | 中小团队快速验证、策略频繁迭代阶段 |
| 国内典型用户 | 中小量化私募的研发阶段 |
3.4 模式四:流水线协处理(Pipeline Coprocessor)
bash
              ┌─ 行情解码 FPGA-1 (沪深)
光纤 ─┬──────┤
      │      └─ 行情解码 FPGA-2 (中金所)
      │
      ▼
   CPU 聚合引擎 (多源汇聚 + 跨市场策略)
      │
      ▼
FPGA-3 (订单路由 + 风控) → 光纤 → 各交易所| 维度 | 说明 |
|---|---|
| 延迟 | 3-10 μs(跨市场时需等待多源行情) |
| 灵活性 | 最高,CPU 做全部策略逻辑 |
| 开发周期 | 4-8 个月 |
| 适用场景 | 跨市场套利、多品种配对交易 |
| 国内典型用户 | 大型量化私募、券商自营多市场线 |
3.5 四种模式对比
bash
延迟 (更低 →)
──────────────────────────────────────────────────────►
  300ns        1-3μs         3-5μs         5-10μs
    │            │             │              │
  模式一       模式二        模式三         模式四
 全硬件       混合流水线     旁路加速      流水线协处理
    │            │             │              │
  灵活性最差 ←───────────────────────────→ 灵活性最高
    │            │             │              │
  适合:       适合:        适合:        适合:
  做市/套利    alpha策略     快速迭代      多市场策略
4. 延迟预算的工程经济学
4.1 各段延迟的可压缩性
| 环节 | 软件典型值 | FPGA 可达值 | 压缩倍数 | 工程代价 |
|---|---|---|---|---|
| 光纤传输(50m) | ~250 ns | ~250 ns | 1×(物理极限) | 换更短线/直插 |
| NIC 接收 | 1-2 μs (DPDK) | 50-100 ns | 10-20× | FPGA MAC IP |
| 行情解码 | 800-1500 ns | 100-200 ns | 5-10× | FPGA 解码流水线 |
| 本地簿更新 | 200-500 ns | 50-100 ns | 2-5× | 片上 BRAM |
| 策略决策 | 500-1500 ns | 20-50 ns | 10-75× | 硬件化触发规则 |
| 订单打包发送 | 500-800 ns (DMA) | 50-150 ns (PIO) | 3-10× | FPGA TX 流水线 |
4.2 边际收益递减曲线
bash
PnL 增益
  ▲
  │     ████████
  │   ██
  │  █
  │ █   ← 软件优化阶段:单位投入产出极高
  │█
  │
  │          ██
  │            ██
  │              ██  ← FPGA 化阶段:投入大,天花板低
  │                ██
  │                  ███
  │
  └──────────────────────────────► 延迟压缩量
     50μs→5μs      5μs→500ns
(10倍,低成本) (10倍,高成本)决策原则:
- 先把软件优化做到极致(DPDK/busy-poll/isolcpus/无锁数据结构)
- 软件到天花板后,评估 FPGA 化的边际收益
- 考虑:FPGA 开发 6-12 个月的人力成本 vs 延迟每降 1μs 的 PnL 增量
5. 国内市场的特殊性
5.1 沪深交易所行情协议
| 交易所 | 协议 | 特点 | 解码复杂度 |
|---|---|---|---|
| 上交所 | FAST (FIX Adapted for STreaming) | 模板 + 字段编码,可变长 | 高 |
| 深交所 | STEP (Securities Trading Exchange Protocol) | 类似 FIX,二进制 | 中高 |
| 中金所 | FIX/自定义 | 标准 FIX 或衍生 | 中 |
| 大商所/郑商所/上期所 | FTD 等 | 各交易所自定义 | 中 |
上交所 FAST 解码的 FPGA 挑战:
- 模板驱动的可变长编码,存在图(Presence Map)控制哪些字段出现
- 需要硬件状态机跟踪模板上下文
- 部分重配置(Partial Reconfiguration)允许运行时切换模板,无需重新综合全部逻辑
5.2 国内 Colocation 环境
- 各交易所在上海/深圳/大连/郑州机房提供托管机柜
- 光纤长度受限(通常 5-50 米),每米约 4.9 ns
- 微波/毫米波链路可用于跨城市传输(上海→深圳约 8-10 ms,但对期货跨市场有优势)
- FPGA 板卡需满足交易所机房功耗/散热限制(通常单卡 ≤ 75W)
5.3 监管合规要求
- 事前风控必须硬件化或内核级实现(不能有软件绕过可能)
- 报单速率限制(每秒最大报单数)需在 FPGA 内硬件计数
- 自成交检查需在订单簿中硬件比对
6. 技术栈选型参考
| 层级 | 技术选项 | 适用场景 |
|---|---|---|
| FPGA 芯片 | Xilinx Virtex UltraScale+ / Alveo | 顶级性能,头部机构 |
| Xilinx Kintex / Zynq | 性价比,中型机构 | |
| Intel Agilex / Stratix 10 | 替代方案 | |
| 开发语言 | Verilog / SystemVerilog | 时序关键路径 |
| VHDL | 传统团队 | |
| C/C++ HLS (Vivado HLS) | 快速原型,非关键路径 | |
| 开发板/加速卡 | Xilinx Alveo U200/U250/U280 | 标准 PCIe 加速卡 |
| Solarflare X2 系列 (带 FPGA) | 网卡集成方案 | |
| Silicom FB2/FB4 | 可编程智能网卡 | |
| NIC 集成 | FPGA 内嵌 MAC + PHY (SFP+) | 延迟最低(省去独立 NIC) |
| 独立 Solarflare NIC + FPGA | 灵活性高 | |
| CPU 侧 | C++17/20 (低延迟线程) | 策略引擎 |
| Rust (无 GC、零成本抽象) | 新一代替代方案 | |
| FPGA- CPU 通信 | PCIe Gen3/4/5 DMA | 标准方案 |
| CXL (未来方向) | 缓存一致性共享内存 |
7. 总结
7.1 量化FPGA的核心价值
bash
量化FPGA ≠ 万能银弹
量化FPGA = 在"延迟敏感度 × 硬件可表达性"的交叉区域找到最佳投入产出比- 延迟敏感的操作(行情解码、订单簿更新、触发检查)→ 放入 FPGA
- 逻辑复杂的操作(策略参数学习、多因子模型、组合优化)→ 留在 CPU
- FPGA 与 CPU 的边界通过 PCIe MMIO/DMA 交换参数和统计
7.2 国内量化FPGA实践现状
| 机构类型 | FPGA 采用率 | 主要应用 | 典型延迟目标 |
|---|---|---|---|
| 头部量化私募 | 高 | 做市/套利的全硬件流水线 | 300-700 ns |
| 中型量化私募 | 中 | 混合流水线(解码在FPGA) | 1-3 μs |
| 券商自营 | 中高 | 多市场协处理 | 3-10 μs |
| 小型私募/创业 | 低 | 旁路加速/DPDK过渡 | 5-10 μs |
7.3 开源与商业生态
| 类别 | 代表 |
|---|---|
| FPGA 开发框架 | Xilinx Vitis / Vivado, Intel Quartus |
| 开源 HFT FPGA 参考 | HFT-Orderbook-FPGA, HFT-FPGA-System |
| 商业 IP 核 | Magmio (C++→FPGA 编译), Design Gateway (ITCH/OUCH IP) |
| FPGA 加速卡供应商 | Xilinx, Intel, BittWare, Silicom, Solarflare |
总结
FPGA 量化不是银弹,而是在「延迟敏感 × 硬件可表达」的交叉区找投入产出比:HFT 里"快"本身就是阿尔法,软件栈在内核协议栈 30-100μs、DPDK 6-12μs、EF_VI 3-6μs 逐级碰壁,而 FPGA 空间计算把行情解码→订单簿→触发→风控→打包做成时钟级确定的硬件流水线,做到 300-700ns、抖动仅数十纳秒,且无中断、无上下文切换。分工原则是热路径上 CPU 完全不在环内——纳秒级确定性命中路径放 FPGA,复杂、易变的策略决策留 CPU,两者只经 PCIe MMIO/DMA 交换参数与统计。落地要按"纯软件验证→软件优化到天花板→部分 FPGA 化→全硬件流水线"递进,并认清边际收益递减(50μs→5μs 低成本、5μs→500ns 高成本),同时满足事前风控硬件化、报单速率硬件计数等国内监管要求。
参考资料
- 《高频交易架构:低延迟、内核旁路、FPGA概览》—— quant67.com (2026)
- 《FPGA行情解码 + Rust策略引擎:超低延迟系统架构》—— 腾讯云开发者社区 (2026)
- 《金融实时决策引擎:FPGA计算加速与数据流优化实践》—— 21ic电子网 (2025)
- 《基于FPGA的超低延迟量化金融计算平台研究》—— CSDN (2023)
- 上交所 LDDS 低延迟数据分发系统技术白皮书 (2024)
- 《High-Frequency Trading FPGA System》—— GitHub/muditbhargava66
- 《Ultra-Low-Latency FPGA Trading with Nasdaq ITCH/OUCH》—— Design Gateway (2025)
- 《FPGA Based Low-Latency Market Data Feed Handler》—— Springer (2018)