如何分析 perf 的图:从一张火焰图读到具体指令
更新时间:2026-09-08
很多人能照着教程敲出 perf record + flamegraph.pl,生成一张花花绿绿的 SVG,但真要他指出"该优化哪个函数、改完有没有效",就卡住了。这篇只讲一件事:perf 产出的图,到底怎么读、怎么据以下手优化、怎么验证优化生效。
和其它讲"命令怎么用"的文档不同,本篇用一份真实跑出来的实验数据贯穿始终。所有数字、占比、汇编行、SVG 都来自一台 4 核 CentOS 7 云主机(内核 3.10),不是杜撰。配套源码和一键复现脚本在 perf-read-flamegraph 动手实验。(公开仓库镜像:derekzhuo/geek-doc.cn)
前置阅读:如果你还不会生成火焰图,先看 火焰图生成指南;命令字段含义看 perf-record / perf-report。本篇默认你已经有一张图。
一、读图前先建立的 4 个心智模型
读图错误,十有八九是把"火焰图"当成了普通的柱状图或调用时序图。先把下面四句话刻在脑子里,后面全是它们的展开。
- 火焰图是采样统计,不是精确计时。 它不记录"函数跑了多少纳秒",而是每隔固定时间打断 CPU 一次,看当时栈停在哪。某函数越宽,只代表"被抓现行的次数越多",统计上约等于占用 CPU 时间越多。样本越少,抖动越大。
- 横轴宽度 = 抽样命中占比,与时间先后无关。 左右排列只是把相同调用链的样本聚合在一起,不代表左边先执行、右边后执行。不要在横轴上找"执行顺序"。
- 纵轴是调用栈深度,从下往上是调用关系。 底下是祖先(
_start → main → …),顶上是"采样瞬间正在 CPU 上跑的叶子函数"。纵轴高低本身不代表开销。 - 要看就看"又宽又平的顶",不是看"又细又高的尖"。 平顶宽 = 叶子函数自己在烧 CPU;宽基座 + 窄尖 = 开销分散在多个子调用里,根因在更上层。
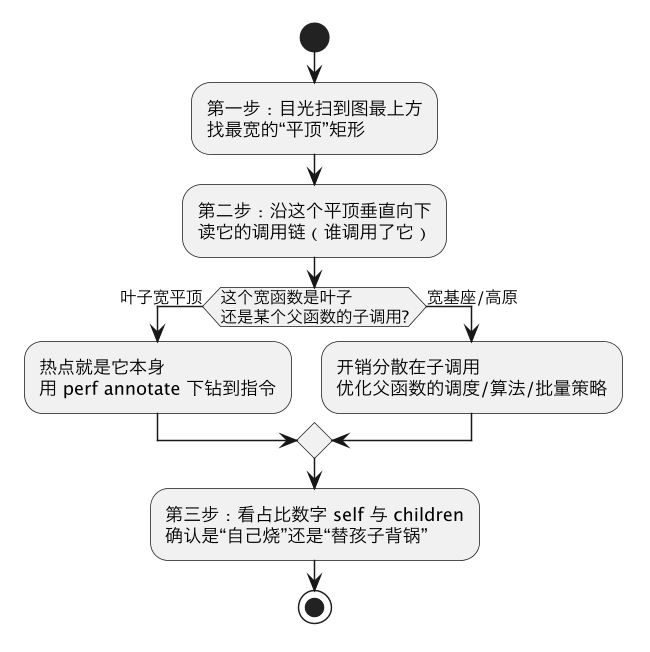
一张图的标准读法只有三步,记住这个动作流:
二、实验对象:一个故意埋了三种形态的程序
为了让图上同时出现典型的几种形状,我们写了一个约 90 行的 C 程序 hotspot.c,里面有三个工作量可切换的函数:
| 函数 | 干什么 | 预期火焰图形态 | 能不能优化 |
|---|---|---|---|
hash_djb2 | 对 65536 个字符串反复算 djb2 哈希,每轮重算 | 宽平顶(叶子热点) | 能,把哈希结果缓存成查表 |
walk_array | 顺序遍历 8MB int 数组做累加 | 中等宽度的高原 | 难,已是顺序访存 |
deep_chain → level_a…d → leaf_spin | 5 层调用后在叶子空转 | 又高又窄的尖塔 | 只能减少调用次数 |
程序接受一个参数:./hotspot base 每轮都重算哈希;./hotspot opt 只算一次哈希、之后查缓存表。除哈希外其余逻辑两版完全一致,于是 leaf_spin 和 walk_array 充当"对照组",让我们能清楚看出优化到底动了谁。
编译命令(保留符号和帧指针,是能读到函数名的前提):
gcc -O2 -g -fno-omit-frame-pointer -std=gnu99 hotspot.c -o hotspot环境信息(真实):
Linux VM-0-17-centos 3.10.0-1160.108.1.el7.x86_64 x86_64
4 核,load average 0.01(基本空闲),gcc 4.8.5,perf 3.10
/proc/sys/kernel/perf_event_paranoid = -1 # 普通用户即可采样第一个真实的坑(权限):很多机器
perf_event_paranoid默认是 2,普通用户perf record会报Permission error。这台是-1(不限制)所以能直接跑。你在自己机器上若遇到权限报错,要么sudo,要么请管理员sysctl kernel.perf_event_paranoid=-1。
三、第一步:perf stat 先量"慢不慢",别急着画图
读图的入口不是火焰图,而是 perf stat。火焰图回答"时间花在哪个函数",但回答不了"程序到底慢不慢、慢在计算还是访存"。先 stat 建立整体印象。
我们最初在这台云主机上跑标准的硬件事件组合:
perf stat -e cycles,instructions,cache-references,cache-misses ./hotspot base得到的却是:
          1,411.74 msec task-clock
   <not supported>      cycles
   <not supported>      instructions
   <not supported>      cache-misses
   ...
第二个真实的坑(云主机没有 PMU 透传):
cycles / instructions / cache-misses全部<not supported>。这在 KVM/虚拟机里极常见——宿主机没有把硬件性能监控单元(PMU, Performance Monitoring Unit)虚拟给客户机,来宾就只能用软件事件。很多教程直接写-e cycles,你在云上照抄就会得到一串 not supported。
降级到软件事件后,拿到真实可用的统计:
perf stat -e task-clock,context-switches,cpu-migrations,page-faults,minor-faults ./hotspot base Performance counter stats for './hotspot base':
577.47 msec task-clock # 0.999 CPUs utilized
4 context-switches # 0.007 K/sec
11 cpu-migrations # 0.019 K/sec
3,088 page-faults # 0.005 M/sec
0.577832867 seconds time elapsed这张表读三点就够:
CPUs utilized = 0.999:单核跑满一个核。如果这里是 0.25,说明程序 75% 时间没在 CPU 上(在等 IO/锁),那 CPU 火焰图只会覆盖四分之一的真相,得改做 Off-CPU 图。context-switches = 4、cpu-migrations = 11:几乎不被调度、也很少跨核迁移,说明这是个纯 CPU 密集负载,CPU 火焰图正合适。page-faults = 3088且全是minor-faults:主要是malloc后首次触碰页面的匿名缺页,不是磁盘 IO,可忽略。
结论:这是 CPU-bound 程序,该上 CPU 火焰图。这一步看似多余,但它决定了你该看哪种图——对一个阻塞在锁上的程序画 CPU 火焰图,会什么都看不出来。
四、第二步:perf record 采样,dwarf 回栈避免断链
对两个版本分别采样。注意我们用的是 --call-graph dwarf 而不是更省事的 --call-graph fp,原因稍后用数据说明:
perf record -F 999 -g --call-graph dwarf,16384 -o perf_base.data -- ./hotspot base
perf record -F 999 -g --call-graph dwarf,16384 -o perf_opt.data  -- ./hotspot opt
[ perf record: Captured and wrote 10.633 MB perf_base.data (671 samples) ]
[ perf record: Captured and wrote 5.240 MB perf_opt.data (331 samples) ]参数怎么读:
| 参数 | 含义 | 为什么这么选 |
|---|---|---|
-F 999 | 采样频率约 999Hz(每毫秒约 1 个样本) | 程序只跑 0.5s 左右,999Hz 才能攒到几百个样本;长跑服务用经典的 -F 99 即可 |
-g | 记录调用栈 | 火焰图必须有栈,否则只有一堆孤立叶子 |
--call-graph dwarf,16384 | 用 DWARF 调试信息回溯,每样本转储 16KB 栈 | 不依赖帧指针,遇到省略帧指针的库也不断链 |
-o ... | 输出文件 | base/opt 分开存,便于 diff |
第三个真实的坑(样本数和占比可信度):base 只有 671 个样本,opt 只有 331 个。单个样本在 base 里约值
1/671 ≈ 0.15%,在 opt 里约0.30%。所以图上任何小于 ~0.5% 的矩形都可能是噪声,不要拿着 0.3% 和 0.6% 的差别大做文章。占比要读到哪一位,取决于样本量。 生产环境通常采 30 秒、几万到几十万样本,置信度高得多。
第四个真实的坑(fp 回栈会断):我们第一次用的是
--call-graph fp,结果折叠栈里出现大量这种行:hotspot;[unknown];[unknown];[unknown];... 10101010深调用链
deep_chain → level_d → leaf_spin中间好几帧退化成[unknown],火焰图上表现为从根部直接戳出一根孤塔,看不到中间的level_*。换成dwarf后,调用链完整恢复成:hotspot;_start;__libc_start_main;main;deep_chain;level_d;leaf_spin 272272272代价是 perf.data 体积明显变大(dwarf 要转储用户栈)。二选一原则:你的二进制能全程保证
-fno-omit-frame-pointer(且依赖的 .so 也保留帧指针)用fp,快;否则老实用dwarf。
五、第三步:perf report 读出精确占比(self vs children)
火焰图好看,但精确数字要回到 perf report。这一步有个新手最容易栽的概念:self(自身)与 children(含子调用)两列占比。
5.1 self 视角:谁自己在烧 CPU
perf report -i perf_base.data --stdio --no-children -g none--- base ---
56.63% hotspot [.] leaf_spin.constprop.4
21.16% hotspot [.] hash_djb2
19.23% hotspot [.] walk_array
0.45% hotspot [.] main
0.45% libc [.] __strchrnul
...(其余单项均 < 0.5%,归入噪声/初始化)--no-children 只统计采样瞬间 PC 正落在该函数体内的次数,即"它自己烧的时间"。读法:
leaf_spin 56.63%:超过一半的 CPU 时间停在最底层那个空转循环——对应火焰图上最宽的那片平顶。hash_djb2 21.16%:五分之一时间在算哈希。walk_array 19.23%:近五分之一时间在遍历数组。[.]表示用户态指令;[k]表示内核态(报告里偶发的0xffffffff91…是内核地址,因为非 root 读不到kallsyms符号,显示为地址,可忽略)。
5.2 children 视角:谁在"替整个子树背锅"
perf report -i perf_base.data --stdio --children -g none 99.85% 0.45% [.] main # 含所有子调用 99.85%,自己仅 0.45%
99.85% 0.00% [.] __libc_start_main
56.63% 56.63% [.] leaf_spin.constprop.4
56.63% 0.00% [.] deep_chain # 自身 0%,但整条链占 56.63%
40.54% 0.00% [.] level_d (inlined)
21.16% 21.16% [.] hash_djb2
21.16% 0.00% [.] hash_all
19.23% 19.23% [.] walk_array第一列(children/包含式)与第二列(self/自身式)的对比是读图的关键:
deep_chain自身 0.00%,但 children 56.63%——它自己一行指令都不烧,只是个"过路"的包装函数。在火焰图上它表现为一个自己几乎没有宽度、但头顶扛着一大片的基座。leaf_spin两列都是 56.63%——它是叶子,没有子调用,两列必然相等。mainchildren 99.85%、self 0.45%——所有业务都在它的子树里,这很正常,不要看到 main 占 99% 就去优化 main。
读图第一纪律:下手优化前,先分清高占比来自 self 还是 children。self 高 = 函数体本身慢(算法/指令问题),值得下钻 annotate;children 高、self 低 = 它只是入口,要沿着调用栈往下找真正宽的子孙。
5.3 优化后再看一次
--- opt(self)---
    56.50%  [.] leaf_spin.constprop.4
    36.56%  [.] walk_array
     0.30%  [.] hash_djb2      # ← 从 21.16% 跌到 0.30%
     1.51%  [.] main
哈希热点从 21.16% → 0.30%,基本消失;没动过的 leaf_spin 稳定在 56.5%(对照组成立,说明变化确实来自我们的改动,而不是测量漂移)。
但注意 walk_array 的占比从 19.23% 升到了 36.56%。这是读图最经典的陷阱。
第五个真实的坑(分母变小,占比反升):百分比是"占本次总样本的比例"。优化把哈希这块工作删没了,总 CPU 时间变短、分母变小;数组遍历的绝对工作量一点没增加,但它在剩下的时间里占的相对比例自然升高。绝对时间下降、某个占比反而上升,不是回归,是分母效应。 要判断 walk_array 有没有真的变慢,看绝对值(下一节)或差分图,而不是单看百分比。
六、第四步:真正读火焰图 SVG
生成流程就是标准四连(原理见 火焰图生成指南):
perf script -i perf_base.data > out_base.perf
~/FlameGraph/stackcollapse-perf.pl out_base.perf > folded_base.txt
~/FlameGraph/flamegraph.pl --title "hotspot (base) CPU flame graph" \
    --countname samples folded_base.txt > flame_base.svg
本次产物规模:base 4877 行 perf script、归并为 16 条唯一调用栈、SVG 22KB;opt 2365 行、同样 16 条栈、SVG 21KB。因为程序结构简单,整张图只有寥寥几片,特别适合教学。
6.1 优化前(base)
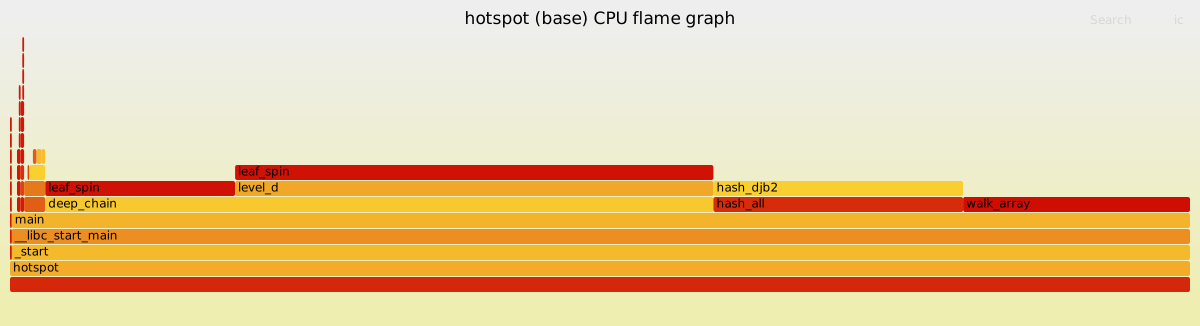
在浏览器里打开这张 SVG(它是可交互的:鼠标悬停显示精确样本数和占比、点击放大某个子树、Ctrl-F 搜索函数名)。读图动作:
- 扫顶部找最宽平顶:最宽的一条写着
leaf_spin.constprop.4,约 56%——与 report 的 self 数字吻合,这是头号热点。 - 垂直向下读它的基座:这条平顶坐在
level_d → deep_chain → main → __libc_start_main → _start之上,说明空转是被deep_chain那条深调用路径反复触发的。图上这片是"又高又宽"的高原,根因是deep_chain的循环次数,不在中间那些只传参的level_*。 - 找第二宽:旁边
walk_array约 19%,它直接坐在main上(中间没有包装函数),是个矮胖块。 - 找第三宽:
hash_djb2约 21%,坐在hash_all → main上——注意它自己是叶子(上面不再有东西),宽就是它自己一行行算哈希烧出来的。
从折叠栈能直接看到这几片的"血缘"和权重(每行末尾是该完整栈的样本数):
hotspot;_start;__libc_start_main;main;deep_chain;level_d;leaf_spin   272272272
hotspot;_start;__libc_start_main;main;deep_chain;leaf_spin           108108108
hotspot;_start;__libc_start_main;main;hash_all;hash_djb2             142142142
hotspot;_start;__libc_start_main;main;walk_array                     129129129
折叠栈末尾的大整数是"该调用链的样本数 × 采样周期"的累加权重,不同机器、不同频率下绝对值不可直接横比,但同一文件内各行的相对比例就是火焰图的宽度。读图只比相对宽度,不纠结这个绝对数字。
6.2 优化后(opt)
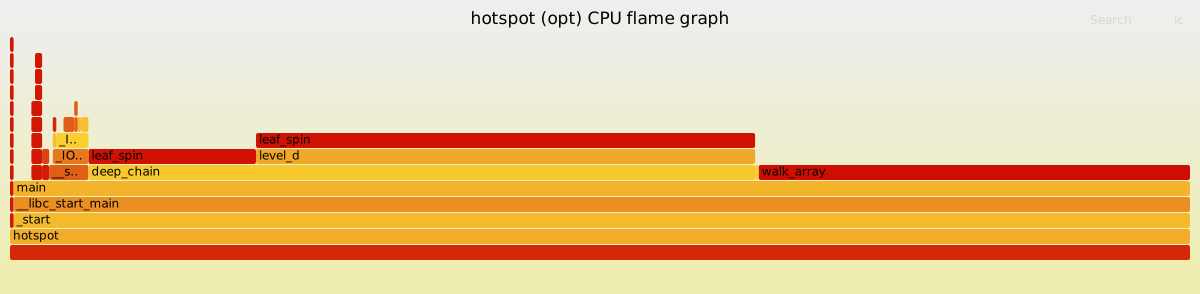
再看优化后的图,最直观的变化:原来 hash_all 顶上那片 21% 的 hash_djb2 几乎塌没了(只剩 0.3%,退化成一条细线,还变成直接挂在 main 下——因为热路径已不走 hash_all 重算)。leaf_spin 依旧是最宽的一片(56% 没变),walk_array 视觉上变宽——这正是第五节说的分母效应。
两张图并排,眼睛先抓住的"塌下去的那片"就是被优化干掉的工作量。 这是火焰图相比纯数字报表最大的价值:变化一眼可见。
七、第五步:perf annotate 下钻到指令
火焰图告诉你"哪个函数热",但当一个函数无法靠算法/缓存优化、必须抠指令时,要进一步问"热在这个函数的哪条指令"。用 perf annotate,它把采样百分比标在反汇编每一行旁:
perf annotate -i perf_base.data --stdio --stdio-color never -s hash_djb2 Percent | Source code & Disassembly of hotspot for cpu-clock (142 samples)
| 00000000004007c0 <hash_djb2>:
| static uint64_t hash_djb2(const char *s) {
| uint64_t h = 5381;
2.11 : mov $0x1505,%eax # 5381
| while ((c = (unsigned char)*s++))
| test %dl,%dl
| h = ((h << 5) + h) + c; /* h*33 + c */
2.11 : shl $0x5,%rsi # h<<5
21.83 : add %rsi,%rdx # (h<<5)+c
40.85 : add %rdx,%rax # 累加回 h
26.06 : movzbl -0x1(%rcx),%edx # 取下一个字符(访存)
3.52 : test %dl,%dl
1.41 : jne 4007d8 # 循环回跳读法:
- 循环体里两条
add合计 62.68%、movzbl取字符 26.06%——热点高度集中在"读一个字节 + 两次加法"这个紧循环。循环外的初始化、ret全是 0%。 - 这说明
hash_djb2的开销不是函数调用、不是栈操作,而是被调用了海量次(65536 × 120 轮)且每次都逐字节读串。所以最有效的优化不是手写汇编去省那两条 add(它们已经是最朴素的整数指令),而是减少调用次数——这正是 opt 版做缓存的依据。annotate 帮我们排除了"抠指令"这条性价比低的路。 - 若这里出现的是大量 cache-miss 型访存指令占比高,方向才是改数据布局/预取;若是
div/sqrt等高延迟指令占比高,方向才是向量化或换近似算法。annotate 的价值是指导优化方向,而不是盲目抠汇编。
八、第六步:差分火焰图,量化"谁增谁减"
单图能看趋势,要严谨地回答"优化到底让哪条栈变多/变少",用差分火焰图。参数顺序很关键(Brendan Gregg 的约定:后面的文件是基准,前面的是被比较对象,图中红色 = 基准里更多/相对回归,蓝色 = 被优化消除):
~/FlameGraph/difffolded.pl folded_opt.txt folded_base.txt > diff.txt
~/FlameGraph/flamegraph.pl --title "opt vs base differential" \
    --countname delta diff.txt > flame_diff.svg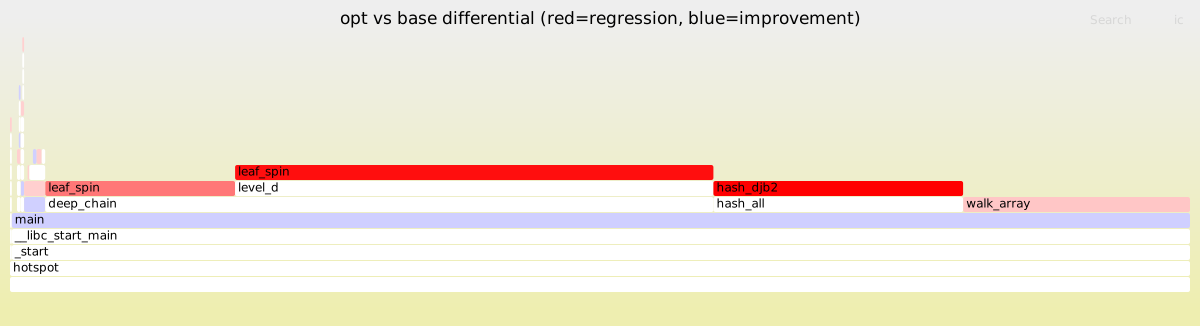
读图:
hash_all → hash_djb2那片呈蓝色(负向),表示 base 里的这块样本在 opt 中消失——被优化干净利落地拿掉了。这就是我们想要的结果。walk_array、leaf_spin若呈暖色,不代表它们变慢,仍是分母变化带来的相对占比差异;差分图同样受总样本归一化影响,绝对结论要结合 wall time。- 真正的性能回归(比如你改完算法,某条本不该变的栈变红变宽)会在差分图上非常刺眼——这正是它在 code review / 上线前对比时的用途。
九、别忘了绝对时间:采样占比会骗人,wall time 不会
前面全是"占比",而占比回答不了最朴素的问题:优化后到底快了多少? 必须用绝对计时收口。我们对两版各跑 7 次 time(这台共享云主机有明显调度噪声):
base 墙钟时间(s): 0.44 0.76 0.45 0.65 0.70 0.44 0.73
opt 墙钟时间(s): 0.73 0.32 0.71 0.83 0.61 0.31 0.82第六个真实的坑(单次计时不可信):两版数据高度重叠,甚至各跑一次时 opt(0.79s)看起来比 base(0.58s)还慢——这是共享 VM 被邻居抢占导致的,绝不能拿一次结果下结论。在抖动环境里,看最小墙钟时间(最接近"无干扰下的真实计算量"):base 最好 0.44s、opt 最好 0.31s,哈希缓存优化带来约 29% 的端到端提速;更严谨的做法是固定 CPU 亲和、提优先级、跑几十到上百次取中位数/最小值并报离散度。
把三种证据串起来,优化结论才闭环:
| 证据来源 | base | opt | 结论 |
|---|---|---|---|
perf report hash_djb2 self | 21.16% | 0.30% | 哈希热点被消除 |
| 对照组 leaf_spin self | 56.63% | 56.50% | 未受影响,排除测量漂移 |
| 差分火焰图 | — | hash 片蓝色塌缩 | 直观确认减少的就是哈希栈 |
| 最小墙钟时间 | 0.44s | 0.31s | 端到端提速约 29% |
perf stat task-clock | 577ms | (噪声下波动) | 与墙钟一致,单核 CPU-bound |
只看占比可能被分母误导,只看一次墙钟可能被噪声误导;占比定位 + 差分确认方向 + 多次绝对计时收口,三者一致才敢说优化有效。
十、常见火焰图形状速查表
拿到一张陌生的图,先用这张表对号入座:
| 看到的形状 | 含义 | 下一步动作 |
|---|---|---|
| 顶部一条又宽又平的矩形 | 叶子函数自身烧 CPU,头号热点 | perf annotate -s <函数> 看热点指令 |
| 一片又宽又高的高原 | 某子树整体都热,开销可能分散 | 进入子树逐层点开,找其中最宽的叶子 |
| 一根又细又高的尖塔 | 调用链很深,但每层自身不热 | 优化调用次数/批量,而非中间包装函数 |
| 宽基座、children 高但 self≈0 | 只是调用入口,在替子调用背锅 | 别优化它,沿栈向下找 self 高的子孙 |
大片 [unknown] / 纯地址 | 缺符号或调用栈回溯断裂 | 加 -g 重编译;fp 换 dwarf;装 debuginfo |
图整体很矮、大量 futex/epoll/[k] | 程序在等锁/IO,不是 CPU-bound | 改做 Off-CPU 图、perf sched、perf lock |
| 图很碎、没有明显宽块 | 样本太少或热点真的很均匀 | 加大采样时长/频率,攒够样本再下结论 |
| 优化后某块变窄、其它块变宽 | 分母效应(总时间变短) | 用绝对时间/差分图确认,勿判回归 |
| 差分图里某块变红变宽 | 该栈在新版本样本增多 | 重点排查,可能是真正的性能回归 |
十一、完整读图 SOP(可直接照做的执行步骤)
把前面的流程压成一份可复用的检查单,排查任何 CPU 性能问题都按这个顺序:
- 定边界:
perf stat ./prog,看CPUs utilized、上下文切换、缺页。判断是 CPU-bound 还是阻塞型,决定画哪种图。 - 备符号:确认二进制带
-g;不确定帧指针是否完整就直接用--call-graph dwarf。 - 采样:CPU-bound 用
perf record -F 99 -g --call-graph dwarf -o a.data -- ./prog;在线服务-p <PID>或-a采 30 秒以上,保证上万样本。 - 看全局:
perf report --stdio --no-children取 self Top N,找最宽叶子;再--children看调用归属,排除 main 这类假热点。 - 画图:
perf script | stackcollapse-perf.pl | flamegraph.pl出 SVG,肉眼找最宽平顶与高原,必要时点击下钻、Ctrl-F 搜索。 - 下钻指令:对 self 最高且无法靠算法优化的函数
perf annotate -s <fn>,判断热点是计算、访存还是分支。 - 动手优化:优先减少调用次数/改算法/加缓存/改数据布局,而不是上来就抠汇编。
- 重采对比:同参数采优化后版本,生成两张图 + 一张
difffolded.pl差分图,确认目标栈塌缩、对照组不动。 - 绝对收口:绑核、多次跑取最小/中位墙钟,给出可信的提速百分比和离散度。
- 留档:保存两份
perf.data、两张/三张 SVG、stat 与计时输出,写清内核/CPU/编译参数/gcc 版本,方便他人复现。
经验法则:图只是导航,数字才是证据。 火焰图负责让你 5 秒内找到怀疑对象,report/annotate/stat/计时负责把怀疑坐实成结论。
十二、常见问题
Q1:火焰图函数名全是地址或 [unknown]?
两类原因:① 二进制被 strip 或没加 -g,重新用 -g 编译、装对应 debuginfo;② 调用栈回溯断裂,--call-graph fp 在省略帧指针的代码上会断成 [unknown],换 --call-graph dwarf。内核符号是地址则因非 root 读不到 /proc/kallsyms(kptr_restrict=1),只分析用户态可忽略,要看内核需 root。
Q2:虚拟机里 cycles、cache-misses 全部 not supported?
云主机常见,PMU 没透传给客户机。用软件事件替代:task-clock、context-switches、page-faults、cpu-clock;默认采样源会回退到 cpu-clock,火焰图照样能画,只是拿不到 IPC/缓存命中等硬件指标。需要这些指标得换支持 vPMU 的环境或裸金属。
Q3:为什么 -F 99 而不是 100、1000?
99、999 这类质数/非整齐频率是为了避免与系统定时器(常为 100Hz)或程序自身周期节律共振,导致系统性采样偏差。短程序可临时用更高频率攒样本,长跑用 99Hz 足够且开销低。
Q4:优化后某个函数占比升高,是我把它改慢了吗?
先看是不是分母效应:总 CPU 时间下降时,未改动函数的相对占比会被动升高。用绝对墙钟时间和差分火焰图核实——只要它的绝对耗时没增加、差分图里没异常变红,就不是回归。
Q5:火焰图能看出多线程扩展性 / 锁竞争吗?
普通 CPU 火焰图不擅长。线程没抢到 CPU 的时间(Off-CPU)根本不会被 cycles 采样到。锁竞争用 perf-lock 和 Off-CPU 火焰图(采 sched:sched_switch),调度延迟用 perf sched,伪共享用 perf-c2c。
十三、配套实验与延伸阅读
本篇全部数据可一键复现,源码、Makefile、复现脚本和三张 SVG 都在:
- perf-read-flamegraph 动手实验(含
hotspot.c、run_lab.sh、base/opt/diff 三张火焰图)
相关文档:
| 你想继续了解 | 文档 |
|---|---|
| 火焰图怎么生成(四类图、选项全集) | 火焰图生成指南 |
perf report 全部交互与排序 | perf-report |
| 汇编级注解原理与输出 | perf-annotate |
| 采样参数、period/frequency | perf-record |
| 硬件/软件事件体系 | perf-events |
| 另一组 perf diff/bench 优化前后对比 | perf-bench-diff 实验 |
| perf 子命令总览与学习路径 | perf 工具完全指南 |
十四、一句话总结
读 perf 的图:先 stat 判定是不是 CPU-bound,再到火焰图顶部找最宽的平顶,垂直向下读调用链,用 perf report 的 self/children 分清"自己烧"还是"替子调用背锅",用 perf annotate 下钻到热点指令;优化后用差分火焰图看目标栈是否塌缩、对照组是否稳定,最后用多次绝对墙钟时间收口——警惕样本太少的噪声、回栈断裂的
[unknown]、以及分母变小导致的占比反升。