FPGA 行情解码子系统
概述
行情解码(Market Data Feed Handler)是量化交易系统中最先接触数据的一环,也是延迟压缩空间最大的环节。FPGA 行情解码从网络 MAC 层开始,将二进制行情报文解析为结构化数据,延迟可控制在 200-400 ns——这是 CPU 软件方案(1-15 μs)的 1/30。
bash
传统 CPU 方案 (10-100 μs)
┌────────┐   ┌────────┐   ┌───────────┐   ┌────────┐   ┌────────┐
│ NIC RX │──▶│ 中断   │──▶│ 内核协议栈 │──▶│ 拷贝到  │──▶│ 应用层  │
│        │   │ 处理   │   │ TCP/UDP   │   │ 用户态  │   │ 解码   │
└────────┘   └────────┘   └───────────┘   └────────┘   └────────┘
FPGA 方案 (~380 ns)
┌────────┐   ┌────────┐   ┌────────┐   ┌────────┐   ┌────────┐
│MAC过滤 │──▶│IP校验  │──▶│UDP解包 │──▶│协议解码│──▶│时间戳  │
│ (PHY)  │   │        │   │        │   │(字段提取)│   │打标    │
└────────┘   └────────┘   └────────┘   └────────┘   └────────┘
      ◀────────── 五级流水线,每周期处理一条行情 ──────────▶
1. 五级流水线解码架构
1.1 第一级:MAC 地址过滤
verilog
// MAC 过滤模块(简化示例)
module mac_filter (
    input  wire        clk,
    input  wire        rst_n,
    input  wire [7:0]  data_in,
    input  wire        data_valid,
    output reg         match,
    output reg  [7:0]  data_out,
    output reg         data_out_valid
);
    // 6 字节 MAC 地址匹配
    // 只放行交易所行情多播 MAC
    parameter [47:0] EXCHANGE_MAC = 48'h0100_5E00_0001;  // 多播地址
    reg [47:0] mac_rx;
    reg [2:0]  byte_cnt;
    // ... 状态机匹配逻辑
endmodule关键优化:
- 在 MAC 层就过滤无效流量,避免后续流水线浪费
- 匹配寄存器硬编码,单周期比较
1.2 第二级:IP 头校验
- 校验和验证(硬件并行计算,一个周期完成)
- 源 IP 白名单过滤(只允许交易所行情源 IP)
- 提取报文长度字段,用于后续 UDP 解包
1.3 第三级:UDP 解封装
- UDP 校验和(可选,交易所行情通常关闭以降低延迟)
- 提取目标端口(确定行情频道)
- 剥离 UDP 头,传递应用层载荷给第四级
1.4 第四级:协议解码(核心)
这是整个流水线中最复杂、最关键的一级。
上交所 FAST 协议解码
bash
FAST 报文结构:
┌──────────┐
│ PMAP     │  Presence Map —— 哪些字段存在
├──────────┤
│ TID      │  Template ID —— 使用哪个模板
├──────────┤
│ Field 1  │  根据 PMAP + Template 解码各字段
│ Field 2  │
│ ...      │
│ Field N  │
└──────────┘
FPGA 实现挑战:
- PMAP 可变长:需要先解析 PMAP 字节数,再决定后续字段的偏移
- Stop-bit 编码:FAST 整数使用 7bit + stop-bit 编码,需要逐字节解析
- 模板依赖:不同 TID 的字段列表不同
解决方案 —— 模板驱动的可重配置解码器:
bash
┌───────────────┐     ┌────────────────┐
│ FAST 比特流   │────▶│ 字段解析状态机  │
└───────────────┘     │                │
                      │ ┌────────────┐ │
                      │ │ 模板表     │ │
                      │ │ (BRAM)     │ │
                      │ │            │ │
┌───────────────┐     │ │ TID→字段   │ │
│ CPU 更新模板   │────▶│ │ 类型/偏移  │ │
│ (启动时/变更)  │     │ └────────────┘ │
└───────────────┘     └───────┬────────┘
                              │ 解码后字段
                              ▼
                     ┌────────────────┐
                     │ 结构化行情记录  │
                     │ (BRAM/FIFO)    │
                     └────────────────┘
深交所 STEP 协议解码
STEP 类似 FIX,使用 Tag=Value<SOH> 格式。FPGA 实现更简单:
- 硬件查找
=和<SOH>定界符 - 预编译的 Tag 查找表 (CAM/BRAM)
- 只提取策略需要的字段(价格、量、时间),忽略其余
1.5 第五级:本地时间戳打标
verilog
module timestamp_stamper (
    input  wire        clk,
    input  wire        pps,            // PTP 秒脉冲
    input  wire [63:0] ptp_time,       // PTP 同步后的时间
    input  wire        tick_valid,
    input  wire [127:0] tick_data,
    output reg         tick_out_valid,
    output reg [191:0] tick_out_data    // tick_data + 64-bit timestamp
);
    // 每个 tick 到达时,附上本地 PTP 时钟
    always @(posedge clk) begin
        if (tick_valid) begin
            tick_out_data <= {tick_data, local_counter};
            tick_out_valid <= 1'b1;
        end
    end
endmodule时间戳精度:
- 使用 PTP (IEEE 1588) 同步到交易所主时钟
- 本地计数器分辨率通常为 4-8 ns(125-250 MHz)
- 多 FPGA 节点间偏差 ≤ ±50 ns
2. 缓存与存储架构
2.1 乒乓缓存(Ping-Pong Buffer)
bash
写指针 → Buffer A (写入) ─┐
                          ├─→ 多路选择器 → 输出
读指针 → Buffer B (读取) ─┘
每轮切换:写满 A → 翻转 → 写 B 的同时输出 A优势:
- 读写完全解耦,无冲突
- 流水线不阻塞,持续吞吐
- 内存带宽利用率可达 85%
2.2 分级存储
| 存储层级 | 介质 | 容量 | 延迟 | 用途 |
|---|---|---|---|---|
| L1 | 片上 BRAM/URAM | 数十 MB | 1 周期 (~4ns) | 订单簿快照、模板表、输出 FIFO |
| L2 | 外部 QDR SRAM | 数十 MB | 5-10 ns | 完整订单簿、快照表 |
| L3 | 外部 DDR4 | 数 GB | 50-100 ns | 历史行情缓存、调试日志 |
| CPU 侧 | 主机 DDR | 数百 GB | ~100 ns (PCIe) | 策略分析、回测数据 |
3. 部分重配置(Partial Reconfiguration)
解决多协议兼容和在线升级问题的关键技术。
bash
┌──────────────────────────────────────────────┐
│                  FPGA 芯片                     │
│                                               │
│  ┌──────────────┐     ┌──────────────────┐   │
│  │ 静态区域      │     │ 可重配置区域      │   │
│  │ (Static)     │     │ (PR Region)     │   │
│  │              │     │                  │   │
│  │ · MAC/PHY    │     │ ┌──────────────┐ │   │
│  │ · 流水线控制  │◀───▶│ │  FAST 解码器  │ │   │
│  │ · PCIe DMA   │     │ └──────────────┘ │   │
│  │ · PTP 时钟   │     │ ┌──────────────┐ │   │
│  │              │     │ │  STEP 解码器  │ │   │
│  │  保持不变     │     │ └──────────────┘ │   │
│  │              │     │ ┌──────────────┐ │   │
│  │              │     │ │  FIX 解码器   │ │   │
│  └──────────────┘     │ └──────────────┘ │   │
│                        └──────────────────┘   │
└──────────────────────────────────────────────┘部署流程:
- 预先综合多个解码器比特流(FAST/STEP/FIX)
- 系统启动时根据交易环境加载对应比特流
- 协议变更时只需重新加载 PR 区域(毫秒级),无需重启整卡
- 静态区域(MAC、PCIe)保持运行,交易不中断
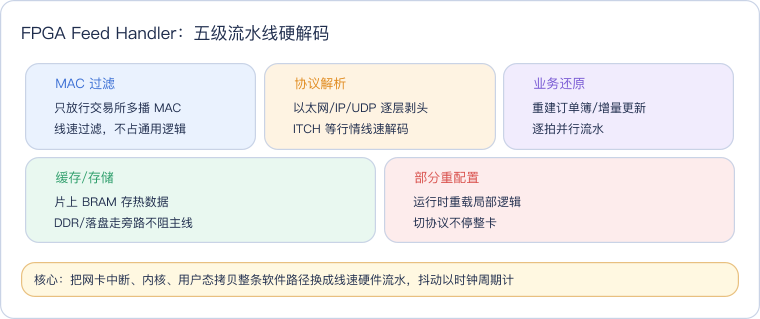
4. 性能基准
4.1 解码延迟对比
| 方案 | 单笔解码延迟 | 每秒处理能力 | 延迟标准差 |
|---|---|---|---|
| 普通 Linux recv + CPU 解码 | 12-15 μs | ~100K msg/s | 8-12 μs |
| DPDK + CPU 解码 | 3-5 μs | ~500K msg/s | 0.5-1 μs |
| FPGA 五级流水线 (200MHz) | 380 ns | 3M msg/s | 0.008 μs |
4.2 吞吐量验证
- 上交所 Level-2 峰值行情约 10 万条/秒(盘中)
- 开盘集合竞价瞬时可达 50 万条/秒
- FPGA 3M msg/s 的处理能力远超峰值需求
- 瓶颈不在解码,而在后续策略决策
5. 开发与调试
5.1 开发流程
bash
Verilog/VHDL 设计 → 功能仿真 (ModelSim) → 综合 (Vivado) →
布局布线 → 时序收敛 → 比特流生成 → 板级调试 (ILA)
5.2 调试工具
| 工具 | 用途 |
|---|---|
| ILA (Integrated Logic Analyzer) | FPGA 内部信号逻辑分析仪 |
| VIO (Virtual I/O) | 虚拟 I/O,在线读写 FPGA 寄存器 |
| IBERT | 高速收发器(SFP+)眼图与误码率测试 |
| JTAG-to-AXI | 通过 JTAG 访问 AXI 总线,读取内存状态 |
5.3 数据回放测试
python
# 典型的回放测试流程
1. 录下真实的交易所行情 pcap 文件
2. 通过 pcapreplay + 光口直连回放到 FPGA
3. FPGA 解码后通过 PCIe DMA 回传 CPU
4. CPU 对比软件解码结果 → 验证正确性
5. 测量 FPGA 解码延迟 → 确认时序
6. 设计陷阱与最佳实践
| 陷阱 | 影响 | 解决方案 |
|---|---|---|
| 跨时钟域未正确处理 | 亚稳态,数据损坏 | 使用双触发器同步器 + 异步 FIFO |
| 流水线气泡 | 吞吐下降 | 前向旁路、分支预测硬件化 |
| BRAM 读写冲突 | 数据错误 | 双端口 BRAM 或读写调度 |
| PMAP 解析的组合逻辑过长 | 时序不收敛 | 插入流水线寄存器 |
| 模板表过大 | BRAM 超限 | 外部 QDR SRAM 存放冷模板 |
参考资料
- 上交所 FAST 协议规范 (SSE Technical Specification)
- 深交所 STEP 协议规范 (SZSE Technical Specification)
- Xilinx UG909: Vivado Design Suite Partial Reconfiguration
- 《金融实时决策引擎:FPGA计算加速与数据流优化实践》—— 21ic (2025)
- 《基于FPGA的超低延时行情系统》—— 知乎/gexin.com.cn
总结
FPGA feed handler 把交易所行情的接收与解码做成五级硬件流水线:MAC 地址过滤(只放行行情多播)→ 以太网/IP/UDP 逐层剥头与 ITCH 等协议线速解码 → 重建订单簿与增量更新,热数据放片上 BRAM、落盘走旁路不阻主线,并用部分重配置在不停整卡的情况下切换协议逻辑。整条网卡中断、内核协议栈、用户态拷贝的软件路径被换成以时钟周期计的线速硬件,延迟和抖动都极低。关键不在单点快,而在各级并行流水、存储分层和可热更新;代价是开发门槛高、灵活性差,协议/策略频繁变化的部分仍应留在 CPU 侧。