分支误预测剖析
更新时间:2026-10-01。当 branch miss 比例显著,优化分支往往比优化运算更见效。
一、代价
误预测后核已沿错误路径投机执行,检测到错误时丢弃这些指令并重定向取指,付出固定的冲刷/重灌拍数,规则性越差的分支越频繁。
二、测量与对策
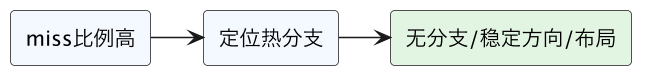
perf stat -e branches,branch-misses,比例高再用 record/annotate 定位是哪个分支。对策:
- 消除分支:算术/掩码、条件传送(cmov),但简单可预测分支用 cmov 反而增加依赖。
- 让方向稳定(排序、改数据结构)。
likely/unlikely影响代码布局。
三、常见坑
- 对高度可预测分支做 cmov,变慢。
- 只加 likely 不改数据可预测性。
- 不量化就“直觉某分支慢”。
小结
误预测代价是冲刷重灌,定位后按“去分支/稳方向/改布局”处理,cmov 要看预测性。下一篇 CPI 栈与 Top-Down。
总结
一次分支误预测意味着核已沿错误路径投机执行、检测到错误时必须丢弃这些指令并重灌前端,付出十几到几十拍的固定冲刷代价;先用 branch-misses/branches 看比例、再用 annotate 定位热分支,然后按“消除分支(掩码/cmov)、让方向稳定、用 likely/unlikely 改布局”处理——但对高度可预测的简单分支强上 cmov 反而增加依赖变慢,务必先量化再动手。