io_uring 异步 IO 框架深入
一、io_uring 设计动机
1. Linux AIO 的历史债务
- AIO 的痛点:仅支持 O_DIRECT、不支持 buffered IO、接口复杂、完成通知靠信号
- 社区对 AIO 的持续不满与替代方案探索
2. io_uring 的核心思想
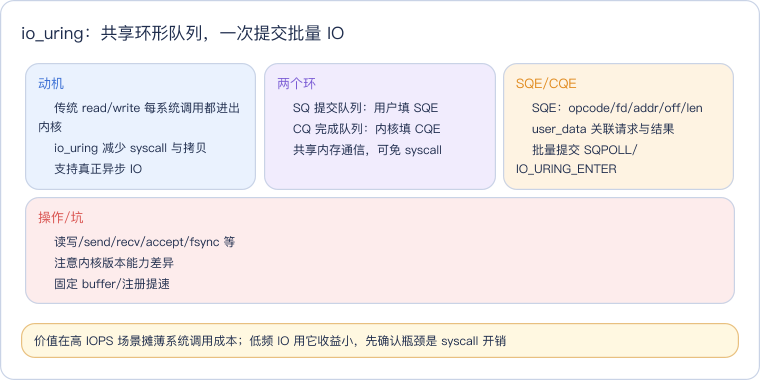
- 共享内存环形缓冲区:Submission Queue (SQ) + Completion Queue (CQ)
- 内存映射 (
mmap) 消除ioctl系统调用开销 - 批量提交与批量收割
二、io_uring 接口与数据结构
1. 核心结构
c
struct io_uring_sqe {   // Submission Queue Entry
    __u8  opcode;       // IORING_OP_READV, IORING_OP_WRITEV, etc.
    __u8  flags;
    __u16 ioprio;
    __s32 fd;
    __u64 off;          // 文件偏移
    __u64 addr;         // 用户态 buffer 地址
    __u32 len;
    __u32 splice_flags;
    __u64 user_data;    // 用户自定义标识
    ...
};
struct io_uring_cqe {   // Completion Queue Entry
    __u64 user_data;    // 对应 sqe 的 user_data
    __s32 res;          // 返回值(字节数或负错误码)
    __u32 flags;
};
2. 内存布局
- SQ Ring: head(内核读) + tail(用户写) + SQE 数组
- CQ Ring: head(用户读) + tail(内核写) + CQE 数组
IORING_SETUP_SQPOLL内核轮询模式:独立内核线程轮询 SQ
3. 三种操作模式
- 默认模式:每次
io_uring_enter()提交 + 等待完成 - SQPOLL 模式:内核线程持续轮询 SQ,用户无需系统调用即可提交
- IORING_SETUP_IOPOLL:设备端轮询(仅 NVMe 等支持),极低延迟
三、io_uring 支持的操作
1. 基础 IO
IORING_OP_READV/IORING_OP_WRITEV:Vectored IOIORING_OP_READ_FIXED/IORING_OP_WRITE_FIXED:固定 buffer(避免每次注册)IORING_OP_FSYNC/IORING_OP_FADVISE:同步与预读
2. 零拷贝操作
IORING_OP_SENDFILE/IORING_OP_SPLICE:文件到网络零拷贝IORING_OP_READ/IORING_OP_WRITE与 O_DIRECT 配合
3. 网络 IO
IORING_OP_ACCEPT/IORING_OP_CONNECT/IORING_OP_RECV/IORING_OP_SEND- 与 epoll 通过
IORING_OP_POLL_ADD/IORING_OP_POLL_REMOVE集成
4. 高级特性
- 链接操作 (
IOSQE_IO_LINK):前一个完成才执行下一个 - 固定文件 (
IORING_REGISTER_FILES):避免每次 fd→file 查找 - 固定 buffer (
IORING_REGISTER_BUFFERS):复用预注册内存 - 事件通知:
IORING_OP_POLL_ADD监控 fd 可读/可写 - 超时操作:
IORING_OP_TIMEOUT/IORING_OP_LINK_TIMEOUT
四、性能量化对比
1. 系统调用次数
| 场景 | 传统 read | AIO | io_uring (默认) | io_uring (SQPOLL) |
|---|---|---|---|---|
| 单次 4K 读 | 1 syscall | 2 (submit + getevents) | 1 (enter) | 0 (无需 syscall) |
| 批量 100 × 4K | 100 syscalls | 2 | 1 (enter+批量收割) | 0 |
2. IOPS 对比
| 操作 | 传统 sync IO | AIO | io_uring | SPDK |
|---|---|---|---|---|
| 4K 随机读 (QD=1) | 12K | 15K | 40K | 200K+ |
| 4K 随机读 (QD=32) | - | 80K | 180K | 600K+ |
| 4K 随机写 (QD=1) | 10K | 13K | 35K | 180K+ |
测试条件:NVMe SSD、CPU 绑核、
IORING_SETUP_SQPOLL
3. 延迟分布(P99)
| 模式 | P50 | P95 | P99 | P99.9 |
|---|---|---|---|---|
| sync IO (buffered) | 8us | 30us | 150us | 2ms |
| io_uring (默认) | 5us | 15us | 50us | 500us |
| io_uring (IOPOLL) | 3us | 8us | 15us | 30us |
五、io_uring 的坑与最佳实践
1. 已知陷阱
- 内核版本兼容性(5.1+ 基础、6.0+ 完善)
- 安全性限制:
kernel.io_uring_disabled控制非特权用户访问 - SQ 满时的阻塞行为
- CQE ordering 与 linked ops 的语义
2. 最佳实践
- 固定文件 + 固定 buffer:减少每次操作的开销
- SQPOLL 模式:适合延迟敏感场景(会消耗一个 CPU 核)
- 批量提交:
SQE攒一批后再io_uring_submit() - 与 epoll 的正确集成方式
3. 与 SPDK 的关系
- SPDK:用户态 NVMe 驱动,绕过内核,延迟最低
- io_uring:走内核 NVMe 栈,兼容性好,无需专用驱动
- 选型:极致延迟 → SPDK;通用场景 → io_uring
六、C/C++ 使用示例
1. liburing 基础用法
c
struct io_uring ring;
io_uring_queue_init(QUEUE_DEPTH, &ring, 0);
struct io_uring_sqe *sqe = io_uring_get_sqe(&ring);
io_uring_prep_read(sqe, fd, buf, size, offset);
io_uring_sqe_set_data(sqe, user_data);
io_uring_submit(&ring);
struct io_uring_cqe *cqe;
io_uring_wait_cqe(&ring, &cqe);
// 处理 cqe->res
io_uring_cqe_seen(&ring, cqe);
2. 批量操作示例
c
for (int i = 0; i < BATCH_SIZE; i++) {
    sqe = io_uring_get_sqe(&ring);
    io_uring_prep_read(sqe, fds[i], bufs[i], sizes[i], offsets[i]);
}
io_uring_submit(&ring);
for (int i = 0; i < BATCH_SIZE; i++) {
    io_uring_wait_cqe(&ring, &cqe);
    // 收割
    io_uring_cqe_seen(&ring, cqe);
}
七、相关参考
- Direct IO vs 页缓存
- 零拷贝深入(sendfile/splice 与 io_uring 对比)
- 存储设备性能
- 网络 IO 模型
八、参考资料
liburing源码与测试用例:https://github.com/axboe/liburing- 《Efficient IO with io_uring》Jens Axboe, PDF
- https://kernel.dk/io_uring.pdf
九、一句话总结
io_uring 用 SQ/CQ 两个共享环形队列批量提交 IO、摊薄系统调用开销,支持真正异步;最大收益在高 IOPS 场景,低频 IO 收益小,且要注意内核版本能力差异。