性能工具与 perf 的差异及综合使用指南
概述
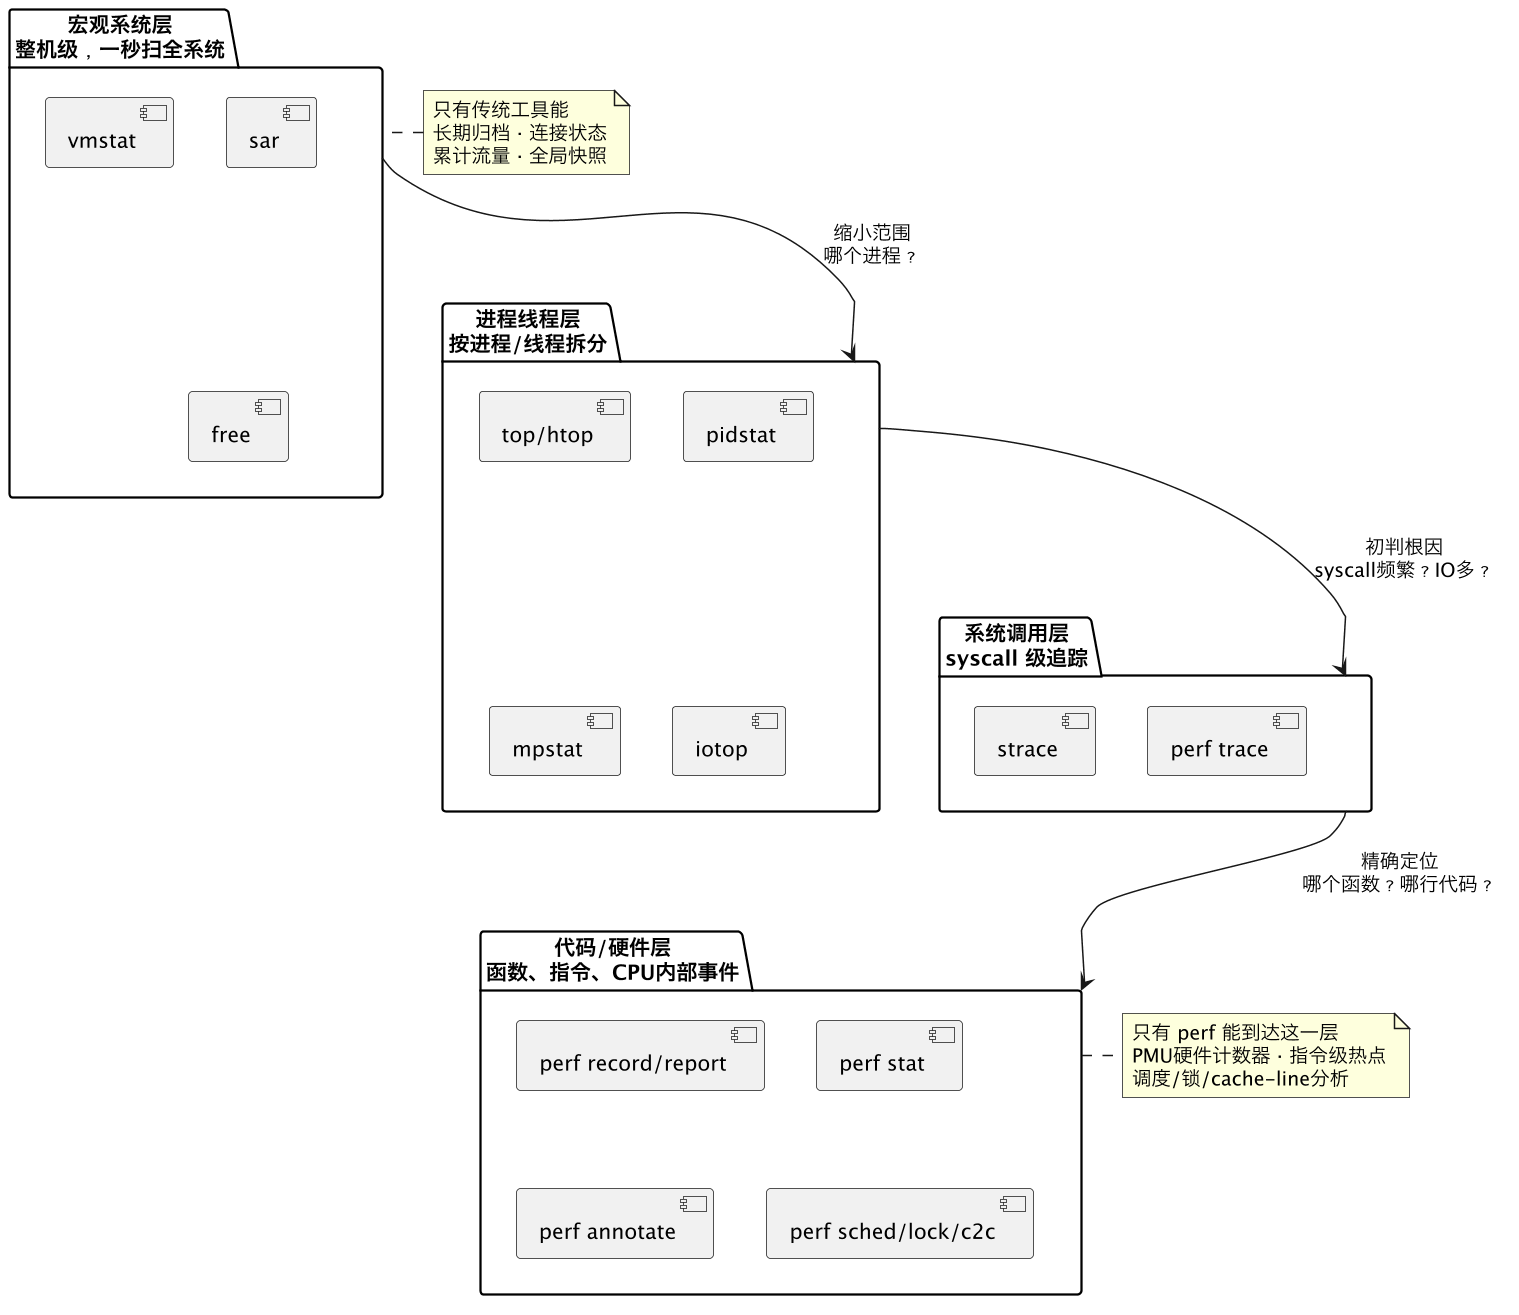
Linux 性能工具按抽象层级从高到低排列,越上层越宏观(覆盖面大但精度低),越下层越微观(精度高但只盯单点)。perf 是唯一能穿透到 L4(代码/硬件层)的工具,但 L1-L3 的工具各有 perf 不可替代的独特价值。
核心认知:不是"perf 替代传统工具",而是"传统工具做初步分诊、缩小范围,perf 做精确活检、锁定根因"。两者串联使用,缺一不可。
一、工具谱系:谁看得见什么
1.1 维度矩阵
| 工具 | 系统级 | 进程级 | 线程级 | 函数级 | 指令级 | 硬件事件 | 历史 | 连接状态 |
|---|---|---|---|---|---|---|---|---|
| vmstat | ✅ | ❌ | ❌ | ❌ | ❌ | ❌ | ❌ | ❌ |
| sar | ✅ | ❌ | ❌ | ❌ | ❌ | ❌ | ✅ | ❌ |
| top/htop | ✅ | ✅ | ✅ | ❌ | ❌ | ❌ | ❌ | ❌ |
| mpstat | ✅(per-core) | ❌ | ❌ | ❌ | ❌ | ❌ | ❌ | ❌ |
| pidstat | ❌ | ✅ | ✅ | ❌ | ❌ | ❌ | ❌ | ❌ |
| free | ✅ | ❌ | ❌ | ❌ | ❌ | ❌ | ❌ | ❌ |
| iostat | ✅(disk) | ❌ | ❌ | ❌ | ❌ | ❌ | ❌ | ❌ |
| iotop | ❌ | ✅ | ❌ | ❌ | ❌ | ❌ | ❌ | ❌ |
| ss/netstat | ✅ | ✅ | ❌ | ❌ | ❌ | ❌ | ❌ | ✅ |
| strace | ❌ | ✅ | ✅ | ❌ | ❌ | ❌ | ❌ | ❌ |
| numastat | ✅(NUMA) | ✅ | ❌ | ❌ | ❌ | ❌ | ❌ | ❌ |
| perf | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | 部分 | ❌ |
1.2 perf 的"盲区"(传统工具不可替代的原因)
| perf 做不到 | 原因 | 替代工具 |
|---|---|---|
| 7×24 历史回溯 | perf 是瞬时采样,不存档 | sar |
| 网络连接状态/端口-进程映射 | 连接状态不在 PMU 事件里 | ss, lsof |
| 磁盘 IO 累计吞吐量 | 不是计数器语义,采样会丢 | iostat, iotop |
| 系统调用完整参数/错误码 | 采样会丢事件,全事件模式开销巨大 | strace |
| NUMA 全局访存快照 | 需要计数器累加,perf 只能采样 | numastat |
| 进程内存分布(虚拟内存/VMA) | 不在 PMU 事件里 | /proc/PID/maps, pmap |
| 文件描述符泄漏 | 与 CPU 无关 | lsof, /proc/PID/fd |
二、逐工具 vs perf 深度对比
2.1 vmstat —— 整机第一眼
| 维度 | vmstat | perf |
|---|---|---|
| 做什么 | r(运行队列)、b(阻塞)、si/so(swap)、bi/bo(IO)、in/cs(中断/上下文切换) | 所有指标都能通过对应事件拿到 |
| perf 能替代吗 | 技术上能,perf stat -e context-switches,cpu-migrations,page-faults -a 可做 | — |
| 为什么不用 perf 替代 | 启动成本:vmstat 1 零配置,perf stat 需要知道事件名 + root 权限。vmstat 一个命令看清整机情绪 | perf 做这个属于屠龙刀切菜 |
| 互补模式 | vmstat 定大方向 → 按维度选专用工具 → perf 深入 | ✅ |
一句话:vmstat 是问"系统忙不忙"的第一个问题,perf 是问"为什么忙"的最后一个答案。
2.2 top/htop —— 进程热力图
| 维度 | top/htop | perf |
|---|---|---|
| 做什么 | %CPU、%MEM、VIRT/RES、进程树、TIME+ | perf top 显示函数级 CPU 占用 |
| 关键差异 | top 看进程,perf top 看函数。同一进程可能 80% CPU 花在 memcpy | perf record 可离线分析 |
| 互补模式 | top -H 找到高 CPU 线程 → perf record -p <PID> -t <TID> -g 采样 | ✅ |
| 能否替代 | 不能。perf top 看不到内存占用、进程状态(D/Z/T)、启动时间、累计 CPU 时间 | — |
一句话:top 告诉你"谁在吃 CPU",perf 告诉你"它吃 CPU 时在干什么"。
2.3 mpstat —— 逐核展开
| 维度 | mpstat | perf |
|---|---|---|
| 做什么 | 每个 CPU 核的 %usr/%sys/%iowait/%irq/%soft/%steal/%idle | perf stat -A 可逐核采集硬件事件 |
| 关键差异 | mpstat 一眼看出"16 核里只有核 3 忙"、"软中断全压在核 0" | perf 能告诉你核 3 在忙什么函数、核 0 的软中断在哪个驱动 |
| 互补模式 | mpstat 发现单核瓶颈/中断不均衡 → perf record 指定核 --cpu 3 | ✅ |
| 能否替代 | 不能。mpstat 是零成本宏观体检,perf stat 每个事件都要指定且输出冗长 | — |
一句话:mpstat 回答"负载分配健康吗",perf 回答"不健康的那个核具体在干什么"。
2.4 pidstat —— 进程/线程多维度拆分
| 维度 | pidstat | perf |
|---|---|---|
-u CPU | 按线程显示 %usr/%system/%guest/%CPU | 可做到但需要 -t 指定每个线程 |
-w 上下文切换 | cswch/s(自愿) / nvcswch/s(非自愿) | perf stat -e context-switches,cpu-migrations |
-d IO | 每线程 rkB/s, wkB/s, iodelay | perf 无法累计 IO 吞吐 |
-r 缺页 | minflt, majflt | perf stat -e page-faults |
| 开销 | pidstat -t -u -w -d 1 几乎无感知 | perf stat -a 有 0.1-0.5% 开销 |
| 互补模式 | pidstat 看线程画像(谁是 IO 型谁是 CPU 型)→ perf 采样对应线程 | ✅ |
一句话:pidstat 是多线程程序的"体检报告"——告诉你每线程的 CPU/IO/CS 画像;perf 是"CT 扫描"——告诉你某线程 CPU 花在哪个函数。
2.5 iostat —— 磁盘 IO 宏观视图
| 维度 | iostat | perf |
|---|---|---|
| 做什么 | r/s,w/s,rkB/s,wkB/s,await,%util,avgqu-sz | perf trace 可见单次 read/write 调用和耗时 |
| perf 能替代吗 | 不能。%util、avgqu-sz、累计 rkB/wkB 这些聚合指标 perf 没有对应事件 | 块层 tracepoint 能做到部分,但无法替代 iostat 的简洁 |
| 互补模式 | iostat 确认磁盘是否真的忙 → iotop 找进程 → strace -p PID 看读写什么文件 | perf trace 可替代 strace 的一部分,但开销 < strace |
| 关键判断 | %util 近 100% + await 高 → 磁盘是瓶颈(机械盘) | %util 低但 await 高 → SSD 内部队列满或坏块 |
一句话:iostat 回答"磁盘打满了吗",iotop/strace/perf 回答"谁把磁盘打满的、读写什么文件"。
2.6 strace —— 系统调用追踪
| 维度 | strace | perf trace |
|---|---|---|
| 追踪方式 | 全事件:每次 syscall 都记录参数、返回值、errno、耗时 | 采样:默认采样会丢事件;全事件模式(--comm)开销仍低于 strace |
| 输出可读性 | 极佳:read(3, "HTTP/1.1 200 OK...", 4096) = 1024 <0.000012> | 较好,但默认精简 |
| 错误码 | 清晰展示 EAGAIN/EINTR/ENOMEM | 不如 strace 直观 |
| 开销 | 很高,生产环境需谨慎 | 较低,perf 走 PMU 中断而非 ptrace |
| 适用场景 | 排查"为什么总重试""为什么返回 EAGAIN" | 统计每个 syscall 的频次分布和耗时分布 |
| 互补模式 | strace -c 找到高频 syscall → perf record -e syscalls:sys_enter_<name> 看内核路径 | ✅ |
strace 不可替代的场景:排查逻辑 bug("为什么 open 返回 ENOENT?"),perf 看不到 errno。
一句话:strace 是系统调用的"完整录像"(参数+返回值+错误),perf trace 是"统计抽样"(频次+耗时分布+内核路径)。
2.7 sar —— 历史回溯
| 维度 | sar | perf |
|---|---|---|
| 采集方式 | 后台 daemon(sysstat),每 10 分钟存档一次 | 瞬时采样 |
| 历史回溯 | ✅ "昨天 3 点 CPU 为什么飙高" | ❌ 无法回溯 |
| 能看什么 | CPU/内存/IO/网络/调度 全部指标的历史曲线 | 只能看当前 |
| 互补模式 | sar 回溯历史异常时间点 → 在相似负载下用 perf 重现分析 | ✅ |
| 能否替代 | 绝对不能。sar 是性能分析唯一的时间机器 | — |
一句话:sar 是监控录像机(事后回放),perf 是手术显微镜(当场解剖)。
2.8 ss / lsof —— 网络连接与文件句柄
| 维度 | ss / lsof | perf |
|---|---|---|
| 做什么 | 连接状态(TIME-WAIT/CLOSE-WAIT)、端口-进程映射、fd 数量 | 完全做不到 |
| 为什么 perf 做不到 | 连接状态和 fd 不在 PMU 事件范围内,与 CPU 性能无关 | — |
| 何时用 | 排查连接泄漏、端口耗尽、fd 泄漏 | 这些问题通常不伴随 CPU 异常 |
| 互补模式 | 无直接互补——属于完全不同的排查维度 | ❌ |
一句话:ss/lsof 排查资源泄漏(连接、fd),perf 排查性能瓶颈(CPU、cache、锁),两者排查目标不同,不存在替代关系。
2.9 numastat / numactl —— NUMA 亲和性
| 维度 | numastat | perf |
|---|---|---|
| 做什么 | 每个 NUMA 节点的 hit/miss 计数,进程级访问分布 | perf stat -e node-loads,node-load-misses 可做 |
| perf 能替代吗 | 技术上能,但门槛高:需要知道准确的 PMU 事件名,且不同架构事件名不同 | — |
| 互补模式 | numastat 发现 30% 远程访问 → numactl 绑核绑内存 → perf stat 验证效果 | ✅ |
| 独有价值 | numastat -p <PID> 看进程在各节点的内存分布,perf 采样不到全局分布 | — |
一句话:numastat 给出 NUMA 问题的"全局快照",perf stat 给出"每次访问的分布和开销"。
2.10 free —— 内存概览
| 维度 | free | perf |
|---|---|---|
| 做什么 | total/used/free/shared/buff/cache/available | 不涉及 |
| 为什么 perf 做不到 | 内存使用量不是性能事件 | — |
| 互补模式 | 无直接互补——free 排查的是"够不够",perf 排查的是"快不快" | ❌ |
三、工具互补关系总表
| 工具 | 独有长板 (perf 做不到) | perf 长板 (该工具做不到) | 最佳组合 |
|---|---|---|---|
| vmstat | 一秒看出 CPU/IO/内存/swap 综合情绪 | 无法定位函数热点 | vmstat 定方向 → 按维度下钻 |
| top/htop | 进程列表 + CPU% + 内存%,交互式排序筛选 | 无法定位进程内部哪种函数占 CPU | top -H 找到线程 → perf record -t TID |
| mpstat | 逐核 %usr/%sys/%soft/%irq,零成本 | 无法知道单核在跑什么函数 | mpstat 发现单核瓶颈 → perf record --cpu N |
| pidstat | 线程级 CPU/IO/CS/缺页画像,iodelay | 无法定位函数热点 | pidstat 画线程像 → perf record -t TID |
| iostat | %util/await/avgqu-sz/累计吞吐 | 无法知道哪行代码在读写 | iostat 确认 IO 瓶颈 → iotop 找进程 → strace 看文件 |
| strace | syscall 完整参数+errno,适合逻辑排查 | 看不到用户态计算 + 内核内部路径 | strace -c 找高频调用 → perf record -e syscalls:* |
| sar | 7×24 历史归档,事后回溯 | 无法看到函数级耗时 | sar 回看历史峰值 → perf 重现 |
| ss/lsof | 连接状态、fd 计数、端口映射 | 完全无关 | 独立使用 |
| numastat | 全局 NUMA hit/miss 分布 | 无法定位到具体访问代码 | numastat 发现远程访问 → perf stat -e node-loads + perf c2c |
| free | 内存总量/可用量,swap 使用量 | 完全无关 | 独立使用 |
四、综合使用:四层下钻排查法
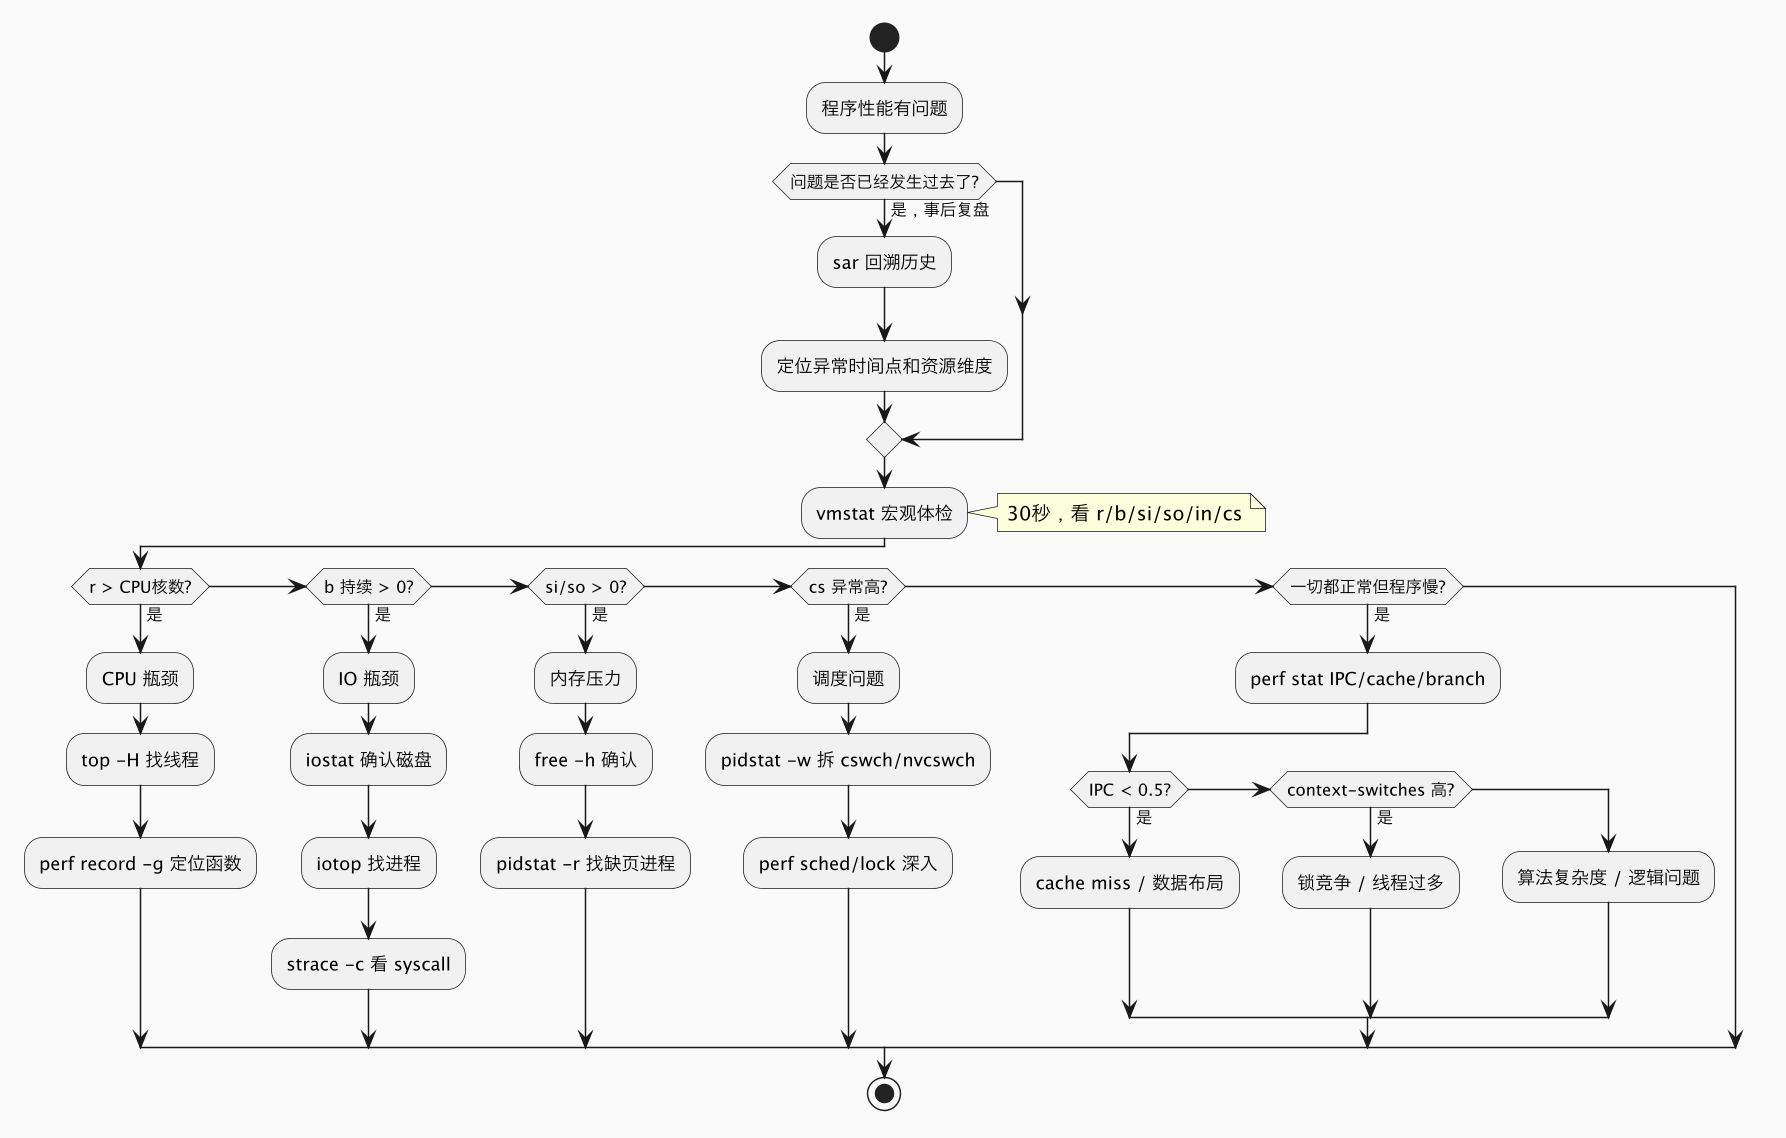
4.1 方法论
vmstat 1                          L1: 宏观体检(30秒)
  │                                 看:r/b/si/so/in/cs/bi/bo
  │                                 问:系统忙在 CPU、IO、还是内存?
  │
  ├─ r 高 (CPU) ─────────────── L2: 进程线程定位
  │   top -H → pidstat -t -u
  │   找到高 CPU 线程后 → perf
  │
  ├─ b 高 / wa 高 (IO) ──────── L2: IO 定位
  │   iostat -x → iotop → pidstat -d
  │   找到 IO 进程后 → strace / perf trace
  │
  ├─ si/so > 0 (内存压力) ───── L2: 内存定位
  │   free -h → pidstat -r
  │   找到缺页进程后 → perf record -e page-faults
  │
  ├─ in/cs 异常 (调度/中断) ──── L2: 调度定位
  │   mpstat -P ALL → pidstat -w
  │   → perf sched latency / perf lock
  │
  └─ 无明显异常但程序慢 ──────── L3/L4: 直接 perf
      perf stat -e cycles,instructions,cache-misses,branch-misses
      看 IPC、cache miss、分支预测失败
4.2 标准四步排查脚本
#!/bin/bash
# 性能排查四步法:对一个正在运行的程序的完整诊断
PID=$1
DUR=30
echo "=== 第一步:整机宏观体检 (vmstat) ==="
vmstat 1 5
echo ""
echo "=== 第二步:进程画像 (pidstat 多维度) ==="
pidstat -p $PID -t -u -w -d -r 1 $DUR
echo ""
echo "=== 第三步:perf stat 硬件事件 ==="
perf stat -e cycles:u,cycles:k,instructions:u,instructions:k,\
cache-misses,cache-references,branch-misses,branches,\
context-switches,cpu-migrations,page-faults \
-p $PID -- sleep $DUR
echo ""
echo "=== 第四步:perf record 函数热点 ==="
perf record -g -F 99 -p $PID -o perf_${PID}.data -- sleep $DUR
echo "→ perf report -i perf_${PID}.data 查看结果"
4.3 快速判据速查
| 观察 | 判据 | 动作 |
|---|---|---|
vmstat r > CPU 核数 × 2 | CPU 严重过载 | top -H 找进程 → perf record |
vmstat b 持续 > 0 | 有任务卡在 IO | iostat 确认磁盘 → iotop 找进程 |
vmstat si/so > 0 | swap 活跃,内存不够 | free -h → pidstat -r 找缺页进程 |
vmstat cs > 10万/s | 上下文切换过于频繁 | pidstat -w 拆 cswch/nvcswch → perf lock |
pidstat %system > 40% | 内核态消耗异常 | strace -c 找高频 syscall → perf record -e syscalls:* |
pidstat iodelay 持续 > 几十 ms | 线程在等磁盘 | iotop → strace -p -e read,write |
pidstat nvcswch/s > 几千 | 非自愿切换频繁,CPU 竞争 | 线程数是否 >> CPU 核数 → perf sched latency |
perf stat IPC < 0.5 | CPU 在空转等内存 | perf stat -e stalled-cycles-backend,cache-misses |
perf stat cache-miss% > 10% | 缓存利用率差 | perf c2c 排查伪共享;检查数据布局 |
perf stat branch-miss% > 5% | 分支预测失败严重 | 考虑消除分支或用 __builtin_expect |
五、场景化组合速查
场景 1:CPU 使用率高(最常见)
top -H -p $PID                     ← 找到高 CPU 线程
  └─ perf record -g -t $TID -- sleep 30
     └─ perf report / 火焰图        ← 定位热点函数
        └─ perf annotate <func>     ← 汇编级分析
场景 2:CPU 100% 但 IPC 极低(CPU 在"假忙")
perf stat -e cycles,instructions,cache-misses,stalled-cycles-backend -p $PID
  → IPC < 0.5, cache-miss% > 10%
  → perf record -e cache-misses -g   ← 按 cache miss 采样,非按周期
  → 错位数据布局 / 伪共享 / 遍历顺序不对
场景 3:IO 等待高,磁盘可能是瓶颈
vmstat 1                            ← 看 b 列是否 > 0
iostat -x 1                         ← 看 await/%util
  → %util 近 100%, await 高 → 机械盘打满
  → %util < 30%, await 高 → SSD 坏块或 TRIM
iotop -o                            ← 找谁在读写
strace -c -p $PID                   ← 哪个 syscall 最多
  → read 多 → strace -e read -p $PID 看读什么文件
  → fdatasync 多 → 写惩罚,考虑 O_DIRECT 或 io_uring
场景 4:程序慢但 CPU/IO 指标全正常
perf stat -e cycles,instructions,cache-misses,branch-misses,\
context-switches,cpu-migrations -p $PID -- sleep 30
  → IPC 正常 + 但 context-switches 高 → 锁竞争,perf lock
  → IPC 正常 + cpu-migrations 高 → NUMA 远端访问,numastat
  → IPC 低 + cache-misses 高 → 数据布局问题
  → IPC 正常 + branch-misses 高 → 分支密集代码
场景 5:多线程 + IO 混合程序
完整方法论 → perf-multithread-io-analysis
pidstat -t -u -w -d 1 30           ← 步骤1:画线程画像
  → CPU 型线程 → perf record -t TID
  → IO 型线程 → strace -c -p PID -t TID
  → 协调线程 → perf lock
场景 6:生产环境偶发延迟尖峰
sar -f /var/log/sa/sa$(date +%d)    ← 回溯今天历史
  → 找到尖峰时间点
  → 检查同时段的网络 (sar -n DEV)、IO (sar -b)、调度 (sar -w)
  → 重现:在类似条件下 perf record -g -F 99
场景 7:内核态 CPU 异常高(stime > 40%)
pidstat -u 1                        ← 确认 %system 高
strace -c -p $PID                   ← 找高频 syscall
  → futex 多 → 锁竞争
  → read/write 多 → IO 路径在内核栈
  → mmap/munmap 多 → 内存分配不健康
perf record -e syscalls:sys_enter_* -g -p $PID
  → 看内核内部哪个环节最耗时
场景 8:怀疑锁竞争 / 伪共享
perf lock record -g -p $PID -- sleep 30
perf lock report                    ← 哪个锁竞争最激烈
perf c2c record -g -p $PID -- sleep 30
perf c2c report                     ← 哪个 cache line 被多核争抢
  → 找到 struct 字段 → 加 padding 或 __cacheline_aligned
六、工具选择决策树
七、一句话总结
传统工具是"分诊台"(告诉你哪个器官不舒服),perf 是"CT 扫描"(告诉你细胞级病灶在哪);二者串联作战的模式是 L1(vmstat)→L2(top/pidstat/iotop)→L4(perf stat+record),每一步缩小搜索半径,5 个命令 15 分钟完成从"系统慢"到"这行代码是根因"的整个链路的排查。