上下文切换开销剖析
更新时间:2026-10-01。线程数远超核数时,大量时间消耗在切换而非计算。
一、成本构成
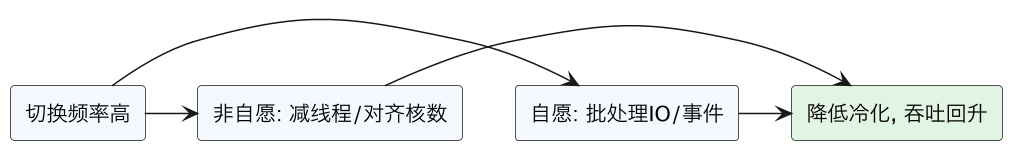
保存/恢复寄存器、TLB/缓存失效与冷化(切回时数据可能已被换走)是主要代价,单次可达数千周期量级。自愿切换(阻塞让出)通常合理;非自愿(抢占/时间片)在过订阅时高频出现。
二、测量
perf stat -e context-switches,cpu-migrations 看频率,结合 sched_switch 算类型;若每秒切换数万以上且吞吐低,多为线程/任务过细。
三、常见坑
- 线程数盲目设成远大于核数。
- 只看切换次数不算缓存冷化。
- 高频小任务/锁导致反复睡眠唤醒。
小结
上下文切换的大头是缓存/TLB 冷化;按切换类型分别用批处理和合理线程数治理。下一篇 perf timechart 可视化。
总结
上下文切换的真实成本远不止保存寄存器:切到新任务后其指令/数据可能已不在缓存,缓存与 TLB 冷化才是大头,单次可达数千周期;自愿切换(阻塞让出)通常合理,非自愿切换(时间片/抢占)在过订阅时高频出现——用 context-switches/sched_switch 统计频率并关联延迟,分别用“批处理 IO/事件减少自愿切换”和“把线程数对齐核数消除非自愿切换”来降低冷化、换回吞吐。