perf trace 深入
更新时间:2026-10-01。已有 perf trace,本文讲它相对 strace 的优势和怎么用于性能。
一、为什么开销低
strace 依赖 ptrace,每个 syscall 两次信号停等、对多线程高频率程序极慢。perf trace 走内核 tracepoint 聚合,默认系统/全线程,低扰动,可在较重负载上用。
二、画像与过滤
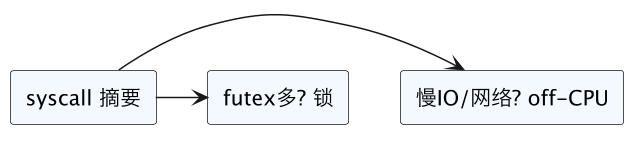
汇总每类 syscall 的次数、耗时、错误(如大量 EAGAIN/非阻塞、futex、IO),按 fd 看文件/网络模式;用 -e、-p/-t 收敛范围。慢 syscall(磁盘/网络等待)直接指向 off-CPU 根因。
三、常见坑
- 在高并发上用 strace 造成严重拖慢。
- 只看次数不看耗时/错误。
- 输出过多不做过滤。
小结
perf trace 用 tracepoint 低开销描绘 syscall 工作负载,慢/失败调用是 IO 与锁问题的线索。下一篇 perf sched 调度剖析。
总结
strace 靠 ptrace、每个 syscall 两次信号停等,在多线程高 syscall 频率下会把程序拖得极慢;perf trace 走内核 tracepoint 聚合、默认跟全线程、扰动低得多,能汇总每类 syscall 的次数/耗时/失败率并按 fd 看文件网络模式——重点不是次数而是慢 syscall(指向磁盘/网络的 off-CPU 根因)和错误码(大量 EAGAIN/futex 指向 IO 模式或锁问题),用 -e/-p/-t 收敛范围。