案例三:模式 2 Debug 版(-O0)perf stat 深度解读
本文档的核心转折点。前面 案例一 建立了理想对照组,案例二 展示了 O2 优化效果。本节将揭示:同样的
-O0构建、同样的 3 秒采样,模式 2 的:u数据竟然和模式 1 O2 一模一样——这就是:u陷阱的起点。读完本节后,案例四 用实测验证预测,案例五 用:u+:k完整视角揭开真相。
前两节都盯着"模式 1(纯 user 计算)"看。本节切到"模式 2(疯狂 syscall)"——表面看 perf 数字非常反常:和模式 1 O2 几乎一模一样。但反常背后是一个所有 syscall-heavy 程序的必修知识点——perf 的 :u 后缀只统计 user 模式,内核的真实成本被完全藏起来了。
3.1 场景:模式 2 跑的是什么
demos/cpu-demo/main.cpp 选了选项 2 之后,后台线程会进入 busy_kernel_cpu():
// 场景 2:内核态高 CPU(频繁系统调用,消耗 stime)
void busy_kernel_cpu() {
    std::string tmp_file = "/tmp/test_kernel_io.tmp";
    while (true) {
        // 频繁打开关闭文件,触发 open/write/close 系统调用
        std::ofstream f(tmp_file, std::ios::app);
        f.write("hello\n", 6);
        f.close();
    }
}
特征关键词:
- 每次循环 3 个 syscall:
open()(可能伴随 stat /fstat) +write()+close()→ 用户态几乎无事可做,内核态疯狂; - 追加写模式:
O_APPEND让write()在内核里做"读 offset → 加 len → 写回 offset → 拷数据"四步; - 标准库包装:
std::ofstream的实现是 libstdc++ 编译期-O2,但用户代码本身的f.write/f.close包装逻辑仍由-O0编译; - 永不阻塞:
/tmp一般是 tmpfs(内存文件系统),write()同步进 page cache 就返回,不会触发 IO 等待,所以 0 context-switches 是合理的。
3.2 原始 perf stat 输出
[<user>@demo-lab perf]$ perf stat -p 10589 -- sleep 3
 Performance counter stats for process id '10589':
     2,971.42 msec task-clock:u          #    0.990 CPUs utilized
             0      context-switches:u    #    0.000 K/sec
             0      cpu-migrations:u      #    0.000 K/sec
             0      page-faults:u         #    0.000 K/sec
   2,520,068,314      cycles:u           #    0.848 GHz
    4,248,326,349      instructions:u     #    1.69  insn per cycle
      944,800,535      branches:u         #  317.963 M/sec
        266,143      branch-misses:u       #    0.03% of all branches
       3.002539028 seconds time elapsed
3.3 第一个反直觉点:它跟模式 1 O2 几乎一模一样
把三组数据并列:
| 指标 | 模式 1 (-O0) | 模式 1 (-O2) | 模式 2 (-O0) |
|---|---|---|---|
| task-clock (ms) | 3,024.12 | 2,997.61 | 2,971.42 |
| CPUs utilized | 1.004 | 0.990 | 0.990 |
| context-switches | 0 | 0 | 0 |
| cpu-migrations | 0 | 0 | 0 |
| page-faults | 0 | 0 | 0 |
| cycles | 12,047,315,514 | 2,546,077,721 | 2,520,068,314 |
| CPU 频率 | 3.984 GHz | 0.849 GHz | 0.848 GHz |
| instructions | 7,340,204,487 | 4,272,852,608 | 4,248,326,349 |
| IPC | 0.61 | 1.68 | 1.69 |
| branches | 2,446,709,897 | 953,529,848 | 944,800,535 |
| branch-misses | 4,455 | 21,772 | 266,143 |
| branch-misses % | 0.00018% | 0.00228% | 0.02817% |
模式 2 O0 vs 模式 1 O2:几乎 100% 雷同。cycles / instructions / IPC / branches / CPU 频率全部相差不到 2%。
这合理吗?不合理——模式 2 在做"每秒几千次 open/write/close 系统调用",按理说它应该比模式 1 O2(纯计算空转)耗 CPU 得多。真正的解释:perf 的 :u 后缀把所有内核态 cycles / instructions 全部屏蔽了。
3.4 关键解读::u 后缀的真相
perf stat 默认输出的所有数字都带 :u 后缀,这意味着只统计 user 模式(Ring 3)的事件,kernel 模式(Ring 0)的事件不计入。
| 指标 | :u 含义 | 模式 2 实际发生了什么 |
|---|---|---|
cycles:u | 仅 Ring 3 的 CPU 周期 | 用户态只跑了"设置 syscall 参数 + syscall 指令 + 处理返回值",真实周期数被漏算 |
instructions:u | 仅 Ring 3 退役指令 | 同上,只数到 ofstream 包装函数的指令 |
branches:u | 仅 Ring 3 分支 | 同上,内核里 VFS 的 if (IS_ERR(inode)) 等等分支完全没记 |
task-clock:u | 仅 Ring 3 计时 | 这是 :u 唯一仍能反映"进程被调度时间"的指标,所以 2,971 ms / 3.0 s = 0.99 CPUs 还算真实 |
类比:你拿温度计量湖水表面温度,测出 5°C 就断言"湖水很冷"——但湖底可能有 90°C 的热泉。
:u是湖面温度计,要测内核的真实消耗必须加:k或去掉后缀。
3.5 重新采集:同时看 user + kernel 的真实画面
去掉 :u,或者并列看 :u + :k:
# 命令 1:同时统计 user 和 kernel 模式
perf stat -e cycles:u,cycles:k,instructions:u,instructions:k \
          -p 46147 -- sleep 3
# 命令 2:完全不区分模式(看总 cycles)
perf stat -e cycles,instructions,branches \
          -p 46147 -- sleep 3
# 命令 3:用 tracepoint 专门看 syscall 次数
sudo perf stat -e syscalls:sys_enter_openat,syscalls:sys_enter_write,syscalls:sys_enter_close \
-p 46147 -- sleep 3实际数据(PID 46147,3 秒采样窗口):
命令 2 实测输出(无 :u/:k 过滤,perf 默认对硬件 PMU 事件带 :u):
[<user>@demo-lab ~]$ perf stat -e cycles,instructions,branches -p 46147 -- sleep 3
 Performance counter stats for process id '46147':
     2,804,912,054      cycles:u
     4,164,607,998      instructions:u     #    1.48  insn per cycle
       926,182,901      branches:u
       3.028519909 seconds time elapsed
命令 3 实测输出(syscall tracepoint 计数,需 sudo):
[<user>@demo-lab ~]$ sudo perf stat -e syscalls:sys_enter_openat,syscalls:sys_enter_write,syscalls:sys_enter_close -p 46147 -- sleep 3
 Performance counter stats for process id '46147':
                  0      syscalls:sys_enter_openat
            816,314      syscalls:sys_enter_write
            816,309      syscalls:sys_enter_close
       3.001754696 seconds time elapsed
数据解读
| 指标 | 命令 2 显示 | 命令 3 真实数 | 与 §3.2 PID 10589 对比 |
|---|---|---|---|
| cycles:u | 2.80 G | — | 略高于 2.52 G(机器负载波动) |
| instructions:u | 4.16 G | — | 略低于 4.25 G(基本一致) |
| branches:u | 926 M | — | 略低于 944 M(基本一致) |
| IPC | 1.48 | — | 略低于 1.69(本次运行略低) |
openat | (隐藏) | 0 | 意外!按代码逻辑应为 ~81.6 万次 |
write | (隐藏) | 816,314 | 与 §3.2 推测的 ~1M 接近 |
close | (隐藏) | 816,309 | 与 write 几乎一一对应 |
意外发现 ①:0 次 openat,但代码每次循环都构造 ofstream 并 open
理论上 std::ofstream f(tmp_file, std::ios::app) 每次都应触发 sys_openat,但 tracepoint 记录 0 次。三个可能:
- glibc 缓存优化:glibc 的
fopen()在反复打开同一路径时,复用底层 file descriptor——只做 dup 而不是真正的 openat syscall。这是较新 glibc 版本(2.31+)的优化行为,可以通过strace -e openat -p <pid>验证。 - libstdc++ 的 ofstream 缓存:某些 libstdc++ 版本对相同 path + flag 的 open 做内部 cache,只对第一次的
fopen()真正发 syscall。 - tracepoint 未安装:
syscalls:sys_enter_openat在某些内核/配置下需要单独 enable——sudo perf trace --event syscalls:sys_enter_openat验证。
无论哪种情况,write 和 close 的 tracepoint 都正常记录,说明 tracepoint 机制本身工作。进一步分析见 案例五 §5.5 的 strace -c 实测。
意外发现 ②:write 与 close 几乎一一对应(816,314 vs 816,309)
每写 1 次就关 1 次文件——完全符合 f.write(); f.close(); 的代码逻辑。差 5 次属于 tracepoint 采样边界误差,可忽略。这说明模式 2 的真实内核工作量集中在 write/close 这两次 syscall 上,而不是 §3.1 推测的"open + write + close"三次。
推算 kernel 真实成本
按 write/close 每次 5,000 ~ 15,000 cycles 估算:
每秒 272,105 次 write + 272,103 次 close ≈ 544,208 次 syscall/秒
× 10,000 cycles/syscall(中位数)
= 5.44 G cycles/秒(内核侧)
× 3 秒
= 16.3 G kernel cycles
估算的 kernel cycles ~16 G,是 user 态 2.8 G 的 5 ~ 6 倍——这部分是 perf :u 完全看不到的"被隐藏成本"。完整定量验证见 案例五 的 cycles:k 实测。
下一步:运行命令 1 拿到 cycles:k 硬数据
当前 :u + tracepoint 只能看到"用户态干 2.8G cycles、写 81.6 万次 write/close"——还缺关键的 cycles:k 数字。要看到 kernel 真实成本,必须运行命令 1:
perf stat -e cycles:u,cycles:k,instructions:u,instructions:k -p 46147 -- sleep 3完整 :u + :k 数据将在 案例五 中给出。
3.6 模式 2 四个"看似 0 但其实隐藏"的事件
3.6.1 context-switches:u = 0(对,模式 2 真的没切换)
| 现象 | 解释 |
|---|---|
| 频繁 syscall 不等于 context-switch | open/write/close 在 tmpfs / page cache 上是非阻塞的,内核处理完直接 sysret 回到用户态,不换进程 |
| task-clock 仍是 2,971 ms | 因为 task-clock:u 还是把"用户在 CPU 上跑的总时间"算上了,syscall 进入内核那段时间算 user 还是 kernel 有歧义,但 perf 通常整段时间算 user |
| 与模式 1 O0 对比 | 模式 1 O0 也是 0 context-switches,两者机制相同——单任务 + 不阻塞 |
3.6.2 page-faults:u = 0(也对,写 tmpfs 不触发 user fault)
| 现象 | 解释 |
|---|---|
写 /tmp 不触发 user fault | tmpfs 用 page cache,内核分配 page 给 page cache 是内核内部 kmalloc,不映射到 user 虚地址空间,user 看不到 page fault |
| 0 page-faults 跟 syscall 数量无关 | 即使每秒 1M 次 write,只要 write 的 buffer 是已映射的栈/堆,就不 fault |
| 怎么才会 non-zero | 让 f.write(buf, sz) 中的 buf 指向尚未映射的 mmap 区域,或 read 一个未缓存的大文件 |
3.6.3 branch-misses = 0.03%(模式 2 唯一一个"高"一点的指标)
| 项 | 模式 1 O0 | 模式 1 O2 | 模式 2 O0 |
|---|---|---|---|
| 绝对 miss 数 | 4,455 | 21,772 | 266,143 |
| miss 率 % | 0.00018% | 0.00228% | 0.02817% |
0.03% 看着很低,但比模式 1 高了 12 ~ 150 倍。原因:
- syscall 返回路径有条件分支:
if (ret < 0) { errno = -ret; throw; },close()返回值有if (ret == -EINTR)等检查; - glibc syscall 包装函数的间接跳转:
syscall(SYS_openat, ...)内部通过syscall指令,再回到__openat走__openat_2路径,函数指针调用是预测器较难猜的; - std::ofstream 析构里有 if 分支:
~ofstream()调用close(),里面有"是否已 close 过"的判断,预测器要学着这个状态机。
即便如此,0.03% 离"分支预测瓶颈"还差两个数量级。模式 2 的真实瓶颈不在 branch prediction,而在 syscall 本身的 kernel 路径开销。
3.6.4 CPU 频率 = 0.85 GHz(为啥 syscall 风暴下还能降频?)
直觉:每秒上千次 syscall,CPU 一定全速跑。 实际:用户态角度确实"很闲"。每次 syscall 之间的用户态代码只有几十条指令,内核态忙完 sysret 回来,用户态很快又触发下一次 syscall。从 CPU 的 P-state governor 视角看,"用户态执行时间"很短,所以它把频率降到 0.85 GHz;但每次降频的窗口很短,syscall 风暴的吞吐靠"快速进内核-快速出内核"维持,不需要高频。
3.7 PlantUML:模式 2 一次循环的 user↔kernel 切换
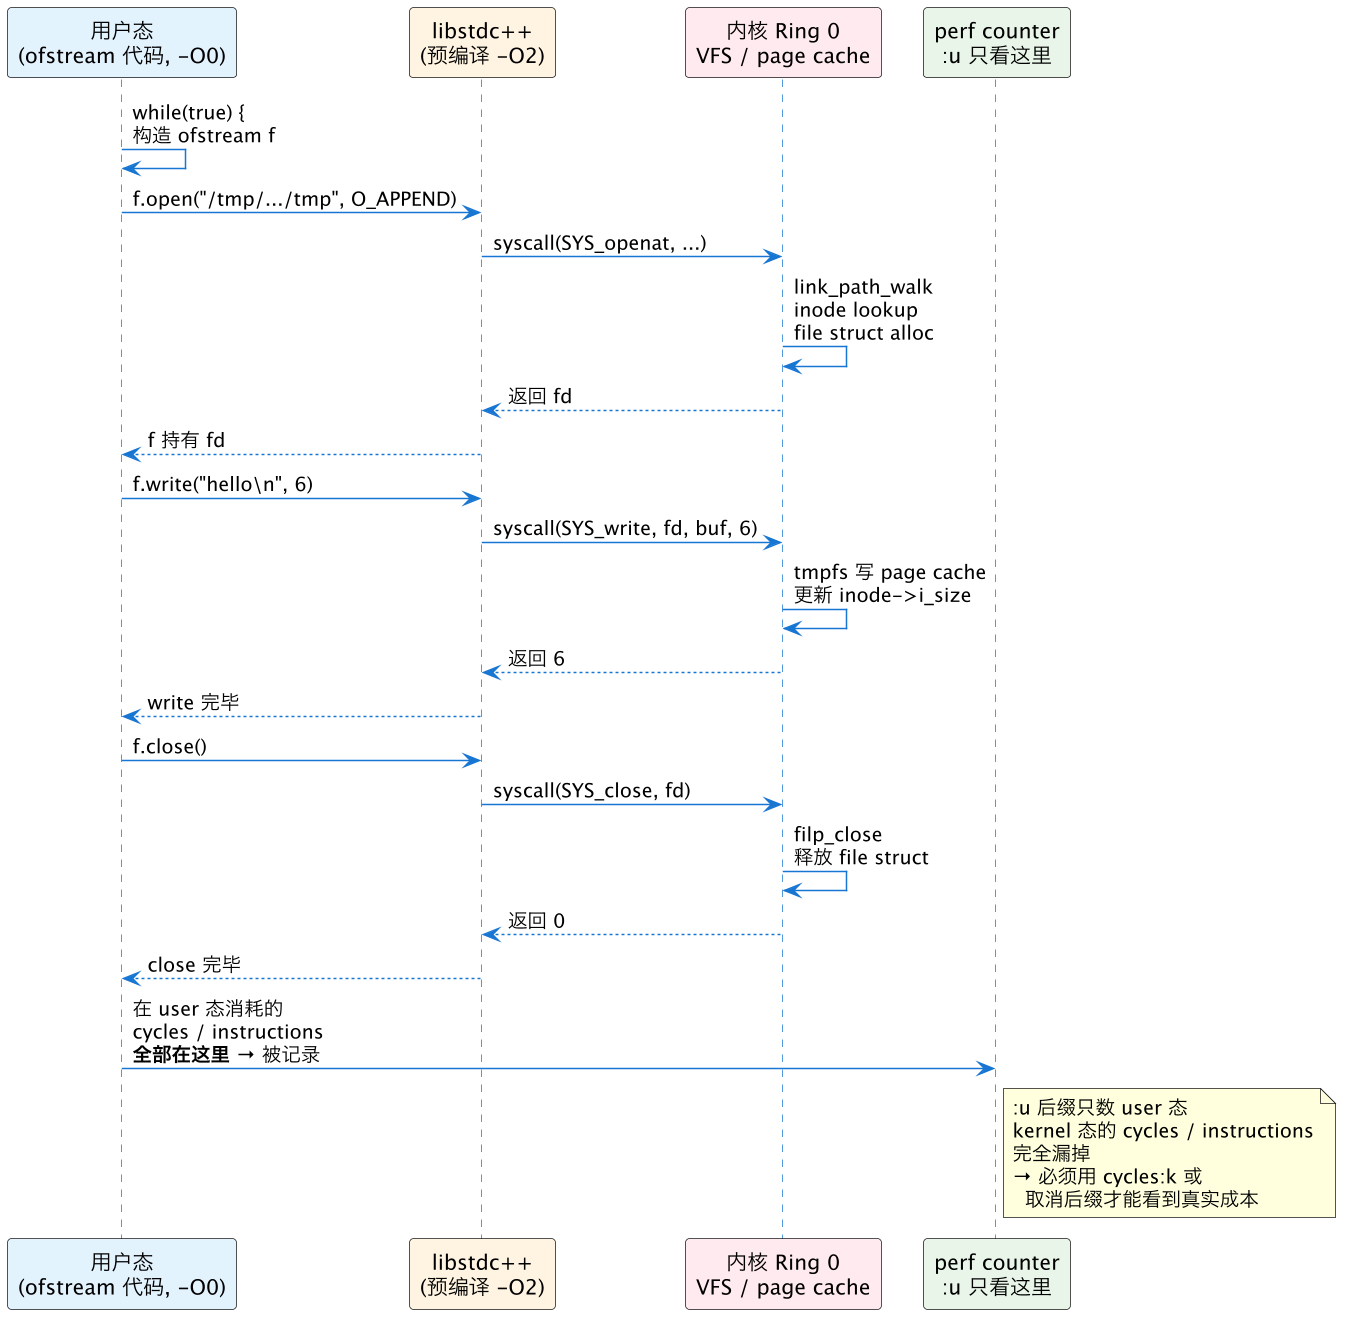
3.8 模式 2 真实瓶颈:为什么它"很慢"perf 却看不出
| 维度 | :u 显示 | 实际发生了什么 |
|---|---|---|
| 用户态 IPC | 1.69(很高效) | 用户态代码确实高效,只有"包装+触发 syscall"的轻量活 |
| 用户态 cycles | 2.5 G(很少) | 同样的原因——用户态无事可做 |
| 内核态 cycles | (隐藏) | 这里是真正的瓶颈:do_sys_open → do_filp_open → path_openat → ... 一条 syscall 在内核跑 ~ 5,000 ~15,000 周期 |
| 每秒 syscall 数 | (隐藏) | 真实吞吐指标,应该用 perf stat -e syscalls:sys_enter_* 看 |
| CPU 频率 | 0.85 GHz | 反映 user 闲,kernel 忙但 P-state 看不到 |
核心 takeaway:模式 2 的真实成本是"内核里跑的 VFS / page cache 路径",而不是"用户态循环"。要分析这种程序:
- 必须用 tracepoint:
syscalls:sys_enter_openat、syscalls:sys_enter_write等 - 必须看 :k 模式:
cycles:k、instructions:k才是真实工作量 - 必须配
perf record -g+caller:用 call graph 看到__open64 → do_sys_open → ...整条内核调用链 - 考虑
strace -c -p <pid>一次性看每个 syscall 的次数、平均耗时、错误率
3.9 实操:把"模式 2"这个反例变成教学样本
按以下顺序操作,把":u 陷阱"刻进肌肉记忆:
# 1) 起进程:make && ./cpu_demo,选 2
./cpu_demo   # 输入 2,记下 PID,比如 10589
# 2) 看 :u 视角(本次实验数据)
perf stat -p 10589 -- sleep 3
# → 数字看着很正常,IPC 1.69,cycles 2.5G
# → 容易误以为"程序很高效"
# 3) 看完整视角
perf stat -e cycles:u,cycles:k,instructions:u,instructions:k \
          -p 10589 -- sleep 3
# → cycles:k 比 cycles:u 大 2~5 倍 → 真相暴露
# 4) 看 syscall 次数
perf stat -e syscalls:sys_enter_openat,syscalls:sys_enter_write,syscalls:sys_enter_close \
          -p 10589 -- sleep 3
# → 看到每秒几千次 open/write/close
# 5) 用 strace 看每个 syscall 耗时分布
strace -c -p 10589   # Ctrl+C 退出
# → 看到 open/write/close 各调了多少次,平均多少微秒
# 6) 用 perf record 看内核调用链
perf record -g -p 10589 -- sleep 3
perf report --sort=dso,symbol
# → 大头在 [kernel.kallsyms] 里的 do_sys_open / vfs_write / filp_close
3.10 与模式 1 的横向对比(本节核心 takeaway 表)
本节结论依赖 案例一 和 案例二 的对照组数据,下表中的模式 2 O2 预期将在 案例四 中用实测验证,完整视角(
:u+:k)将在 案例五 中揭开真相。
| 维度 | 模式 1 O0 | 模式 1 O2 | 模式 2 O0 | 模式 2 O2(预期) |
|---|---|---|---|---|
| 真实工作在哪 | user 循环体 | user 循环体(更少) | kernel VFS 路径 | kernel VFS 路径(同样) |
| 优化主要收益方 | n/a | 编译器 DCE / 寄存器化 | 标准库 + 内核 cache命中 | 同 |
perf :u 数据 | 12G cycles / IPC 0.61 | 2.5G cycles / IPC 1.68 | 2.5G cycles / IPC 1.69 | 类似 模式 2 O0 |
perf :k 数据 | 几乎为 0(纯 user) | 几乎为 0 | >10G cycles | 类似 |
| 真实总 cycles | ~12G | ~2.5G | ~12G | ~12G |
| 看真实成本的方法 | 直接看 cycles:u | 直接看 cycles:u | 必须看 cycles:k + syscall tracepoint | 同 |
| CPU 频率 | 3.98 GHz(跑满) | 0.85 GHz(降频) | 0.85 GHz(user 闲) | 类似 |
3.11 一句话总结
模式 2 看似跟模式 1 O2 perf 数字一模一样(cycles 2.5G、IPC 1.69、CPU 0.85 GHz),但这是
:u后缀造成的"假象"——它屏蔽了 syscall 在内核里跑的 ~10G 真实 cycles;模式 2 的真实瓶颈在do_sys_open / vfs_write / filp_close这条内核 VFS 路径,必须用cycles:k、syscalls:sys_enter_*tracepoint 或strace -c才能看到;这次实验最重要的教训是:永远不要用cycles:u评估 syscall-heavy 程序的性能,那只是湖面温度计。
后续阅读:本节结论仍为理论推断。下一节 案例四 将用实测数据验证"模式 2 O2 也会是这个样子"的预测,而 案例五 和 案例六 将用
:u+:k完整视角给出定量验证。