perf 场景化学习架构:从入门到精通
通过 12 个独立 demo,逐个覆盖
perf stat、perf record、perf top、perf annotate、perf sched、perf lock、perf mem、perf c2c、perf trace、perf probe、perf list、perf script、perf diff的全部核心用法及 50+ 个关键 event。 每个 demo 遵循同一模板:程序(main.cpp)→ Makefile → README → 分析指南 → 一句话总结。
一、设计原则
1.1 为什么需要新 demo
| 现有 demo | 覆盖能力 | 缺失的 |
|---|---|---|
cpu-demo(3 场景) | perf stat 基本指标、:u/:k 视角陷阱、O0 vs O2 | 硬件 PMU 事件深入、采样+火焰图实战、tracepoint 事件 |
tlb-thrashing | dTLB-load-misses 单一事件、步长→TLB 拐点 | 多事件组合分析、perf record 采样实践 |
compiler-reordering | 编译器 UB 复现(非 perf 导向) | 锁争用、原子操作开销、perf lock |
crash-signals | 信号(非 perf 导向) | — |
核心缺口:缺少系统化的、逐事件逐子命令的实战 demo,现有 demo 都是为特定理论服务,而非为"学会用 perf"服务。
1.2 设计原则
- 一个 demo 一个核心知识点:每个 demo 聚焦 1~2 个 perf 子命令 + 2~5 个关键 event,不贪多
- 可独立运行:每个 demo 有自己的
Makefile+README.md,make run一键运行 - 输出可预测:每个 demo 的运行结果有明确的"正确答案",方便自检
- 渐进式:从最简单的
perf stat到复杂的perf probe+perf script - 复用现有 demo:4 个已有 demo 纳入学习路径,新做 8 个补齐缺口
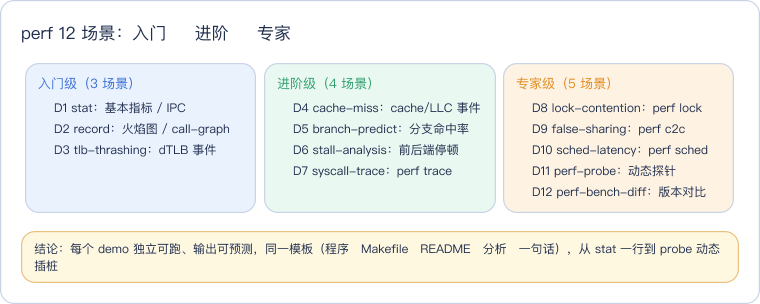
二、12 场景全景
┌─────────────────────────────────────────────────────────────────────────────┐
│                         perf 学习路线图(12 场景)                              │
├─────────────────────────────────────────────────────────────────────────────┤
│                                                                             │
│  入门级(3 场景)          进阶级(4 场景)          专家级(5 场景)           │
│  ────────────────         ────────────────         ────────────────           │
│                                                                             │
│  D1 cpu-demo:stat         D4 cache-miss           D8 lock-contention         │
│  │  perf stat 基本指标     │  cache-references,    │  perf lock, futex,       │
│  │  task-clock, cycles,    │  cache-misses,         │  lockdep                 │
│  │  instructions, IPC      │  LLC-load-misses       │                          │
│  │  [已有]                 │  [新增]                │  [新增]                   │
│  │                         │                        │                          │
│  D2 cpu-demo:record       D5 branch-predict        D9 false-sharing          │
│  │  perf record/report     │  branch-instructions,  │  perf c2c, cache-line    │
│  │  火焰图, call-graph     │  branch-misses          │  contention              │
│  │  [已有 + 补充]          │  [新增]                │  [新增]                   │
│  │                         │                        │                          │
│  D3 tlb-thrashing         D6 stall-analysis        D10 sched-latency         │
│  │  dTLB-loads,           │  stalled-cycles-       │  perf sched record/       │
│  │  dTLB-load-misses       │  frontend/backend       │  latency/timehist         │
│  │  [已有]                 │  [新增]                │  [已有文档 + 新增demo]    │
│  │                         │                        │                          │
│                            D7 syscall-trace         D11 perf-probe            │
│                            │  perf trace,            │  perf probe,             │
│                            │  syscalls tracepoint     │  dynamic tracepoint      │
│                            │  [新增]                │  [新增]                   │
│                                                     │                          │
│                                                     D12 perf-bench-diff       │
│                                                       perf bench,              │
│                                                       perf diff                │
│                                                       [新增]                   │
│                                                                             │
└─────────────────────────────────────────────────────────────────────────────┘
三、逐场景详细设计
D1: cpu-demo — perf stat 基础指标(已有,需补充分析指南)
| 项 | 内容 |
|---|---|
| demo 目录 | demos/cpu-demo/ |
| perf 子命令 | perf stat |
| 关键 event | task-clock, context-switches, cpu-migrations, page-faults, cycles, instructions, branches, branch-misses |
| 学习目标 | 读懂 perf stat 的 8 项默认输出,区分 utime/stime 场景,理解 IPC 基本含义 |
| 分析指南 | analysis-stat — 场景 1/2/3 各自的 perf stat 输出逐行解读 |
| 已有关联文档 | perf-case-studies/01~06(:u/:k 视角陷阱深度分析) |
D2: cpu-demo — perf record + 火焰图(已有程序,需补充分析指南)
| 项 | 内容 |
|---|---|
| demo 目录 | demos/cpu-demo/ |
| perf 子命令 | perf record, perf report, perf script |
| 关键 event | cycles(默认采样事件), instructions |
| 学习目标 | 采样调用栈 → 看懂 perf report 的 Overhead 列 → 生成火焰图 → 对比 O0 vs O2 下火焰图的差异 |
| 分析指南 | analysis-record — 场景 1/2 的 record→report→火焰图完整流程 |
| 已有关联文档 | perf §二~§三 |
D3: tlb-thrashing — TLB 事件分析(已有,需补充分析指南)
| 项 | 内容 |
|---|---|
| demo 目录 | demos/tlb-thrashing/ |
| perf 子命令 | perf stat, perf record |
| 关键 event | dTLB-loads, dTLB-load-misses, iTLB-loads, iTLB-load-misses, cycles, instructions |
| 学习目标 | 理解 TLB miss 率随工作集变化的规律,学会用 perf stat 定量测量 TLB 行为 |
| 分析指南 | analysis — 不同步长 D 的 perf stat 对比表 + perf record -e dTLB-load-misses -g 采样分析 |
| 已有关联文档 | tlb |
D4: cache-miss — 缓存未命中模式(新增)
| 项 | 内容 |
|---|---|
| demo 目录 | demos/cache-miss/ |
| perf 子命令 | perf stat, perf record, perf annotate |
| 关键 event | cache-references, cache-misses, L1-dcache-loads, L1-dcache-load-misses, LLC-loads, LLC-load-misses, cycles, instructions |
| 学习目标 | 对比顺序访问 vs 随机访问 vs 跨步访问的缓存命中率差异,理解"缓存友好"数据布局 |
| 程序设计 | 3 种遍历模式对比:① a[i] 顺序 ② a[rand()%N] 随机 ③ a[i*stride] 跨步(stride=16/64/256)。每种模式固定操作次数,用 perf stat 测 cache-misses 率 |
| 关键看点 | 顺序访问 L1 miss <1%,随机访问 L1 miss >50%;LLC miss 在数据集超过 LLC 大小后飙升 |
D5: branch-predict — 分支预测(新增)
| 项 | 内容 |
|---|---|
| demo 目录 | demos/branch-predict/ |
| perf 子命令 | perf stat, perf annotate |
| 关键 event | branch-instructions, branch-misses, branch-loads, branch-load-misses, cycles, instructions |
| 学习目标 | 理解分支预测器对有序/无序数据的不同表现,学会用 perf annotate 看汇编级分支行为 |
| 程序设计 | ① 排序数组的 if (a[i] > threshold) — 分支规律,预测成功率高 ② 随机数组的同样判断 — 分支无规律,预测失败率高 ③ 无分支写法 (sum += (a[i] > threshold)) 对比 |
| 关键看点 | 有序数组 branch-miss <1%,随机数组 ~50%;无分支写法牺牲可读性但消除 branch-miss |
D6: stall-analysis — 流水线停顿分析(新增)
| 项 | 内容 |
|---|---|
| demo 目录 | demos/stall-analysis/ |
| perf 子命令 | perf stat |
| 关键 event | stalled-cycles-frontend, stalled-cycles-backend, cycles, instructions, cache-misses, branch-misses, L1-icache-load-misses |
| 学习目标 | 区分前端停顿(取指瓶颈)vs 后端停顿(数据瓶颈),用组合事件定位根因 |
| 程序设计 | 4 种模式:① 纯计算(对照组,低 stall)② 大量函数指针间接调用(前端 stall)③ 随机内存访问(后端 stall)④ 长依赖链计算 s += s*s(后端 stall,数据依赖) |
| 关键看点 | stalled-cycles-frontend / cycles vs stalled-cycles-backend / cycles 的占比对比,理解"前端=喂不饱,后端=等数据" |
D7: syscall-trace — 系统调用追踪(新增)
| 项 | 内容 |
|---|---|
| demo 目录 | demos/syscall-trace/ |
| perf 子命令 | perf trace, perf stat -e 'syscalls:*' |
| 关键 event | syscalls:sys_enter_*, syscalls:sys_exit_*, context-switches |
| 学习目标 | 用 perf trace 实时看每个 syscall 的参数和耗时,对比 strace 的性能开销差异 |
| 程序设计 | 混合 3 种 syscall 模式:① read/write 小文件 IO ② futex 锁等待 ③ nanosleep 定时睡眠。用 perf trace -s 看各 syscall 的总耗时分布 |
| 关键看点 | perf trace 开销远低于 strace(基于 perf 而非 ptrace);futex 耗时反映锁争用程度 |
D8: lock-contention — 锁争用分析(新增)
| 项 | 内容 |
|---|---|
| demo 目录 | demos/lock-contention/ |
| perf 子命令 | perf lock record → perf lock report, perf stat -e 'syscalls:sys_enter_futex' |
| 关键 event | lock:contention_begin, lock:contention_end(kernel lock tracepoint) |
| 学习目标 | 用 perf lock 定位哪个锁争用最严重、平均等待时间、最大等待时间 |
| 程序设计 | 4 线程争用 3 种锁:① std::mutex 短临界区(轻争用)② std::mutex 长临界区(重争用)③ pthread_spinlock 极短临界区(对比 mutex)。运行 10 秒采集锁事件 |
| 关键看点 | perf lock report 输出每把锁的 contended/total/wait-time/max-wait;spinlock 在短临界区下等待时间 < mutex |
D9: false-sharing — 伪共享检测(新增)
| 项 | 内容 |
|---|---|
| demo 目录 | demos/false-sharing/ |
| perf 子命令 | perf c2c record → perf c2c report |
| 关键 event | cpu/mem-loads/, cpu/mem-stores/(Intel PEBS 精确采样) |
| 学习目标 | 理解 cache line 乒乓效应,用 perf c2c 的 HITM 指标定位伪共享 |
| 程序设计 | 2 线程各自自增相邻的 int:① 同一 cache line(伪共享,性能暴跌)② alignas(64) 隔开(正确,无竞争)。固定时间测吞吐量 |
| 关键看点 | 伪共享版本吞吐量暴跌 5~20x;perf c2c report 的 HITM%(本地命中修改)>50% 即确诊;perf c2c report -d 看 cache line 的地址分布 |
D10: sched-latency — 调度延迟诊断(已有文档 + 新增 demo)
| 项 | 内容 |
|---|---|
| demo 目录 | demos/sched-latency/ |
| perf 子命令 | perf sched record → perf sched latency / perf sched timehist / perf sched map |
| 关键 event | sched:sched_switch, sched:sched_wakeup, sched:sched_migrate_task, sched:sched_stat_runtime, sched:sched_stat_wait |
| 学习目标 | 用 perf sched 全套子命令分析调度行为,判断线程是"在运行"还是"在等调度" |
| 程序设计 | 混合 3 种调度模式:① CPU 密集型(一直跑,几乎不切换)② IO 等待型(usleep 频繁睡眠/唤醒)③ 多线程竞争(N 线程 > 核数,频繁抢占)。运行 10 秒录制调度事件 |
| 关键看点 | perf sched latency 看每线程平均/最大调度延迟;perf sched timehist -V 可视化时间线;perf sched map ASCII 调度图 |
| 已有关联文档 | perf-sched |
D11: perf-probe — 动态探针(新增)
| 项 | 内容 |
|---|---|
| demo 目录 | demos/perf-probe/ |
| perf 子命令 | perf probe, perf record -e probe:*, perf script |
| 关键 event | probe:*(用户自定义动态探针) |
| 学习目标 | 在任意函数入口/出口/指定行插入探针,采集参数值和调用栈 |
| 程序设计 | 一个简单函数 int do_work(int n) 被循环调用,参数 n 随机变化。用 perf probe 在 do_work 入口插探针 → perf record -e probe:do_work 采样 → perf script 看每次调用的参数分布 |
| 关键看点 | perf probe -x ./prog --add 'do_work n=%di' 抓函数参数;perf probe --del '*' 清理;比 printf 调试开销低、无需重编译 |
| 已有关联文档 | 实验入口 · 原理篇 |
D12: perf-bench-diff — 微基准测试 + 优化前后对比(新增)
| 项 | 内容 |
|---|---|
| demo 目录 | demos/perf-bench-diff/ |
| perf 子命令 | perf bench, perf stat, perf diff |
| 关键 event | cycles, instructions, IPC, cache-misses, branch-misses |
| 学习目标 | 用 perf bench 测系统基础性能 → 用 perf stat 测自己程序的优化前后 → 用 perf diff 定量对比 |
| 程序设计 | 一个可优化的函数:① 基线版(朴素实现,差缓存局部性)② 优化版(改数据布局/循环展开/预取)。分别 perf record → perf diff data1 data2 看各函数的 ±% 变化 |
| 关键看点 | perf diff 的 Delta% 列直观显示优化效果;perf bench mem memcpy 测内存带宽基线 |
四、Event 覆盖矩阵
下表列出 12 个场景覆盖的所有 perf event,打 √ 表示该场景的核心 event:
| Event 类别 | Event 名 | D1 | D2 | D3 | D4 | D5 | D6 | D7 | D8 | D9 | D10 | D11 | D12 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 软件事件 | task-clock | √ | √ | ||||||||||
context-switches | √ | ||||||||||||
cpu-migrations | √ | √ | |||||||||||
page-faults | √ | ||||||||||||
minor-faults | √ | ||||||||||||
major-faults | √ | ||||||||||||
| 核心计算 | cycles | √ | √ | √ | √ | √ | √ | √ | |||||
instructions | √ | √ | √ | √ | √ | √ | √ | ||||||
IPC | √ | √ | √ | √ | √ | √ | |||||||
ref-cycles | √ | ||||||||||||
| 流水线停顿 | stalled-cycles-frontend | √ | |||||||||||
stalled-cycles-backend | √ | ||||||||||||
| 分支预测 | branch-instructions | √ | √ | ||||||||||
branch-misses | √ | √ | √ | ||||||||||
branch-loads | √ | ||||||||||||
branch-load-misses | √ | ||||||||||||
| 缓存层级 | cache-references | √ | √ | ||||||||||
cache-misses | √ | √ | √ | ||||||||||
L1-dcache-loads | √ | ||||||||||||
L1-dcache-load-misses | √ | ||||||||||||
L1-icache-load-misses | √ | ||||||||||||
LLC-loads | √ | ||||||||||||
LLC-load-misses | √ | ||||||||||||
| TLB | dTLB-loads | √ | |||||||||||
dTLB-load-misses | √ | ||||||||||||
iTLB-loads | √ | ||||||||||||
iTLB-load-misses | √ | ||||||||||||
| Tracepoint | sched:sched_switch | √ | |||||||||||
sched:sched_wakeup | √ | ||||||||||||
sched:sched_migrate_task | √ | ||||||||||||
sched:sched_stat_runtime | √ | ||||||||||||
sched:sched_stat_wait | √ | ||||||||||||
syscalls:sys_enter_* | √ | ||||||||||||
syscalls:sys_exit_* | √ | ||||||||||||
lock:contention_begin | √ | ||||||||||||
lock:contention_end | √ | ||||||||||||
| PEBS | cpu/mem-loads/ | √ | |||||||||||
cpu/mem-stores/ | √ | ||||||||||||
| 动态探针 | probe:* | √ |
覆盖统计:12 个场景覆盖 40+ 个 perf event,涵盖软件事件、硬件 PMU 事件(核心计算/流水线/分支/缓存/TLB)、内核 tracepoint、PEBS 精确采样、动态探针 5 大类。
五、Perf 子命令覆盖矩阵
| 子命令 | D1 | D2 | D3 | D4 | D5 | D6 | D7 | D8 | D9 | D10 | D11 | D12 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
perf stat | √ | √ | √ | √ | √ | √ | √ | |||||
perf record | √ | √ | √ | √ | √ | √ | √ | √ | ||||
perf report | √ | √ | ||||||||||
perf top | √ | |||||||||||
perf annotate | √ | √ | ||||||||||
perf trace | √ | |||||||||||
perf lock | √ | |||||||||||
perf c2c | √ | |||||||||||
perf sched | √ | |||||||||||
perf probe | √ | |||||||||||
perf script | √ | |||||||||||
perf bench | √ | |||||||||||
perf diff | √ | |||||||||||
perf list | √ | √ | √ | √ | √ | √ | √ | √ | √ | √ | √ |
覆盖 14 个核心子命令,perf list 作为查找 event 的基础操作在每个场景都会用到。
六、文件结构规划
demos/
├── cpu-demo/                    # [已有] D1+D2 的 demo 程序
│   ├── main.cpp
│   ├── Makefile
│   ├── README.md
│   ├── analysis-stat.md         # [新增] D1 perf stat 分析指南
│   └── analysis-record.md       # [新增] D2 perf record + 火焰图分析指南

├── tlb-thrashing/               # [已有] D3 的 demo 程序
│   ├── main.cpp
│   ├── Makefile
│   ├── README.md
│   └── analysis.md              # [新增] D3 perf 分析指南

├── compiler-reordering/         # [已有] 非 perf 导向,不动
├── crash-signals/               # [已有] 非 perf 导向,不动

├── cache-miss/                  # [新增] D4
│   ├── main.cpp                 # 顺序/随机/跨步 3 种遍历
│   ├── Makefile
│   └── README.md                # 含 perf 命令 + 预期输出 + 分析解读

├── branch-predict/              # [新增] D5
│   ├── main.cpp                 # 有序/随机/无分支 3 种写法
│   ├── Makefile
│   └── README.md

├── stall-analysis/              # [新增] D6
│   ├── main.cpp                 # 4 种停顿模式
│   ├── Makefile
│   └── README.md

├── syscall-trace/               # [新增] D7
│   ├── main.cpp                 # 混合 syscall 模式
│   ├── Makefile
│   └── README.md

├── lock-contention/             # [新增] D8
│   ├── main.cpp                 # mutex 短/长 + spinlock
│   ├── Makefile
│   └── README.md

├── false-sharing/               # [新增] D9
│   ├── main.cpp                 # 同/异 cache line 对比
│   ├── Makefile
│   └── README.md

├── sched-latency/               # [新增] D10
│   ├── main.cpp                 # CPU/IO/竞争 3 种调度模式
│   ├── Makefile
│   └── README.md

├── perf-probe/                  # [新增] D11
│   ├── main.cpp                 # 带参数的函数循环调用
│   ├── Makefile
│   └── README.md

└── perf-bench-diff/             # [新增] D12
    ├── main.cpp                 # 基线版 + 优化版对比
    ├── Makefile
    └── README.md
concepts/tools/
├── perf-demos-architecture.md   # [本文档] 架构总览
├── perf-advanced.md             # [已有] 高级用法参考
├── perf-sched.md                # [已有] perf sched 完全指南
├── perf-case-studies/           # [已有] 基于 cpu-demo 的 6 个深度案例
└── perf-multithread-io-analysis.md  # [已有] 多线程+IO 方法论
七、推荐学习路径
路径 A:快速入门(2~3 小时)
D1 (perf stat 基础) → D2 (perf record 火焰图) → D4 (缓存) → D5 (分支预测)学会用 perf stat 看指标、perf record 看热点,理解 IPC、缓存命中率、分支预测失败率三大核心概念。
路径 B:系统进阶(5~6 小时)
D1 → D2 → D3 (TLB) → D4 → D5 → D6 (停顿分析) → D7 (syscall) → D12 (diff 对比)覆盖全部硬件 PMU 事件 + syscall tracepoint,能独立完成"宏观指标 → 热点函数 → 微架构瓶颈"的完整分析链路。
路径 C:专家级(8~10 小时)
全部 12 场景按编号顺序覆盖 perf lock、perf c2c、perf sched、perf probe 等高级子命令,具备多线程性能调优、锁争用诊断、伪共享检测、动态探针插桩等全栈分析能力。
八、与现有文档的协同
                    ┌──────────────────────────────────┐
                    │   tools/code/perf.md              │
                    │   (perf 命令大全,工具主文档)        │
                    └──────────┬───────────────────────┘

              ┌────────────────┼───────────────────────┐
              ▼                ▼                       ▼
┌─────────────────────┐ ┌──────────────┐ ┌────────────────────────────┐
│ concepts/tools/      │ │ concepts/    │ │ concepts/tools/             │
│ perf-advanced.md     │ │ cpu/pmu.md   │ │ perf-demos-architecture.md  │
│ (高级用法详解)        │ │ (PMU硬件原理) │ │ ★ 本文档 — 学习路线导读      │
└──────────┬──────────┘ └──────┬───────┘ └────────────┬───────────────┘
           │                   │                       │
           └───────────────────┼───────────────────────┘

            ┌──────────────────┼──────────────────────┐
            ▼                  ▼                      ▼
    ┌──────────────┐  ┌─────────────────┐  ┌──────────────────────┐
    │ demos/        │  │ concepts/tools/  │  │ concepts/tools/       │
    │ 12个demo程序   │  │ perf-case-studies│  │ perf-sched.md         │
    │ (实操)        │  │ (6个深度案例)     │  │ (sched专题)           │
└──────────────┘ └─────────────────┘ └──────────────────────┘| 文档 | 角色 | 与本架构关系 |
|---|---|---|
| perf | 命令大全(字典式查询) | 每个 demo 的"参考手册" |
| perf-advanced | 高级用法(原理讲解) | 每个 demo 的"理论基础" |
| pmu | PMU 硬件架构 | D4/D5/D6 的硬件原理解释 |
| perf-case-studies/ | 基于 cpu-demo 的深度案例 | D1/D2 的进阶补充 |
| perf-sched | perf sched 专题 | D10 的完整参考 |
九、实施优先级
| 优先级 | 场景 | 理由 |
|---|---|---|
| P0 | D4 cache-miss, D5 branch-predict, D6 stall-analysis | 覆盖最常用的硬件 PMU 事件,是分析"CPU 为什么忙但不出活"的核心能力 |
| P1 | D7 syscall-trace, D8 lock-contention, D10 sched-latency | 覆盖内核态 tracepoint 和专用子命令,解决"CPU 在内核里干什么"的问题 |
| P2 | D9 false-sharing, D11 perf-probe, D12 perf-bench-diff | 高级场景,需要特定硬件支持(PEBS)或 root 权限,但知识价值高 |
| 已有 | D1, D2, D3 | 程序已有,只需补充分析指南(analysis-*.md) |
十、一句话总结
12 个场景、8 个新 demo + 4 个已有 demo、40+ event、14 个 perf 子命令,从
perf stat一行命令到perf probe动态插桩,每个 demo 独立可跑、输出可预测——把 perf 从"查手册用的工具"变成"像用 ls 一样顺手"。