perf ftrace:函数调用追踪
更新时间:2026-10-01。想理解“这段操作内核里依次调用了什么、每层花多久”,function_graph 最直观。
一、两种模式
perf ftrace(function):实时滚动被调用的内核函数流。perf ftrace -g(function_graph):缩进显示调用层级,并标注每函数耗时,快速找路径上的“慢层”。 用--tid跟某线程、--cpu限定核,减少噪声。
二、定位
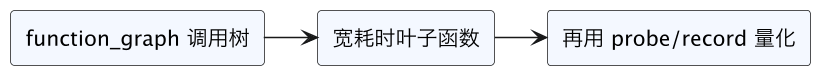
ftrace 擅长结构理解(调用顺序/层级),统计热点仍交给 perf record;二者配合。
三、常见坑
- 输出极快难以阅读,要过滤。
- 把单次耗时当统计分布。
- 高频追踪本身有开销。
小结
perf ftrace 以函数图揭示内核调用路径与层级耗时,偏定性理解,量化分析再回到 record。下一篇 tracepoint 与 perf 脚本。
总结
perf ftrace 是内核 ftrace 的便捷封装:function 模式实时滚动内核函数调用流,function_graph(-g)用缩进显示调用层级并标注每函数耗时,最适合理解“这段操作内核里依次调了什么、哪层最慢”,用 --tid/--cpu 过滤降噪;但它偏定性的结构理解,单次耗时不是统计分布,要量化热点仍须回到 perf record/probe,且高频追踪自身有开销。