案例四:模式 2 Release 版(-O2)真实数据深度解读
对 案例三 预测的实测验证章节。案例三从
:u视角推测"模式 2 O2 也会是这个样子",本节用真实数据验证——发现:u数字确实跟预测一致,但多了"CPU 利用率 99%"这个新信号。然而:u视角终究是盲人摸象,真相需要 案例五(O0 完整视角)和 案例六(O2 完整视角)来揭示。
4.1 实验背景
构建命令:make release(等效于 g++ -O2 -g demos/cpu-demo/main.cpp -o cpu_demo) 运行命令:./cpu_demo,输入场景编号 2,启动 kernel syscall 风暴(每秒约 ~2000 次 openat + write + close 循环) 采样命令:perf stat -p 10815 -- sleep 3观察时间:3.0328 秒 采集地点:真实物理机(非容器),内核启用 intel_pstate driver
本节是案例三 "模式 2 O0 预测" 的实测验证章节。读者会看到:O2 不仅优化了用户态,还把"系统调用密度"再压一档,导致 user 视角看起来比 O0 还"高效"——但这恰恰是 :u 后缀陷阱的最深一层。
4.2 原始输出(贴图复刻)
[<user>@demo-lab perf]$ perf stat -p 10815 -- sleep 3
 Performance counter stats for process id '10815':
     3,001.70 msec task-clock:u        #    0.990 CPUs utilized
                0      context-switches:u #    0.000 K/sec
                0      cpu-migrations:u  #    0.000 K/sec
                0      page-faults:u     #    0.000 K/sec
    2,538,190,879      cycles:u          #    0.846 GHz
    4,210,370,783      instructions:u    #    1.66  insn per cycle
      939,586,960      branches:u        #  313.019 M/sec
           21,105      branch-misses:u   #    0.00% of all branches
       3.032820286 seconds time elapsed
4.3 字段逐项解读
4.3.1 task-clock:u = 3001.70 msec, 0.990 CPUs utilized
- 绝对值:3001.70 ms,几乎等于 wall-clock 3.03 秒
- CPU 利用率 0.990:这是单核 99% 占用的标志(
0.990 CPUs= 99.0% × 1 核) - 对比案例三 模式 2 O0 的 task-clock 约 3000 ms(预期)、CPU 利用率约 0.85(预期):O2 模式 2 的"单核占用率"反而比 O0 更高
- 为什么 O2 利用率更高? 关键反直觉点:
- O0 模式:每次 user 态代码较重(
std::ofstream构造/析构里有大量未优化分支、未内联函数),user 态执行时间相对更长 - O2 模式:
ofstream::open/close被内联,多余的if (!is_open()) return;等检查被消除,user 态的"无用功"被剪掉 → user 态总时间更短 → 但 每次 syscall 之间的间隔更短 → 进内核更频繁 → 整体 user 态 + kernel 态的"占用时间"几乎贴满 wall-clock - 从 P-state governor 视角:"user 态和 kernel 态都持续有活干",频率不再降低,反而能稳住 0.85 GHz 不掉
- O0 模式:每次 user 态代码较重(
4.3.2 context-switches:u = 0, cpu-migrations:u = 0
- 跟案例三 模式 2 O0 一样的解释:主动让出 + 抢占 + 多核迁移都未发生——单任务独占一个 CPU,无竞争者
- 0 context-switches 不代表 0 内核态切换:每次
openat/write/close都是 Ring 3 → Ring 0 → Ring 3 的"自愿切换(voluntary context switch)",只是不计入context-switches这个计数器(它只统计"被调度器强制换下"的次数) - 真正的内核态"切换成本"必须看
cycles:k
4.3.3 page-faults:u = 0
- 跟案例三解释一致:
/tmp是 tmpfs,文件已存在 → 走 fast path,没有 major fault - 跟 O0 模式 2 一致
4.3.4 cycles:u = 2,538,190,879 (0.846 GHz)
- 绝对值 2.54 G cycles,频率 0.846 GHz:频率竟然没掉到 0.4 GHz!这跟前文案例三预测的"O2 也会降频到 0.85 GHz"一致
- 与模式 1 O0(12 G cycles @ 3.98 GHz)的对比:cycles 跌了 4.7 倍
- 这 4.7 倍里,优化贡献占多少?
- O2 把
busy_kernel_cpu里 user 态的"循环胶水代码"全部内联/消除 - 实际 user 态每个 loop 几乎只剩"3 个 syscall 包装 + 几个寄存器操作"
- 所以 user 态 cycles 从 ~12 G → ~2.5 G 是正常的"工作量减少"
- O2 把
- 但这 2.5 G cycles:u 不是程序的真实成本——kernel 里跑的 ~10 G cycles 被
:u后缀完全屏蔽
4.3.5 instructions:u = 4,210,370,783, 1.66 insn/cycle
- IPC = 1.66——比模式 1 O0 的 0.61 几乎翻了 3 倍
- 比模式 1 O2 的 1.68 略低(因为 syscall wrapper 里的
mov $SYS_xxx, %eax; syscall这种指令是 serializing 的,稍微拖累 IPC) - 1.66 IPC 在现代 x86 上是"中等"水平:
- 超标量五级加宽的理论峰值:取指 4~6 条、译码 4~6 µop、发射 INT 4+FP 4、执行 18 单元、退休 4~8 µop。IPC 1.66 ≈ 仅用了发射带宽的 ~21%
- 说明 syscall 包装序列不是吃 dispatch port 的瓶颈——瓶颈在 syscall 进去后 CPU stall 在 kernel 的 IPI / lock / cache miss 上
4.3.6 branches:u = 939,586,960,branch-misses:u = 21,105
- 每秒 3.13 亿次分支——比模式 1 O2(每秒 ~2.5 亿次)还高,说明 syscall 触发的"循环+分支"非常密集
- branch-misses 只有 21,105 次,miss rate 0.00%(实际 0.00225%,被 perf 四舍五入到 0.00%)
- 反直觉发现:模式 2 O2 的 branch-misses 比模式 1 O2(8,400 次)更高,但比模式 2 O0(264,000 次)低 12 倍!
- O2 优化消除了 ~92% 的分支错误预测
branch-misses:u仍不是真实值——syscall 内部的内核分支全部漏算
4.3.7 time elapsed = 3.0328 seconds
- 3.03 秒:perf 等待 3 秒后,加上自身采集开销
4.4 与模式 2 O0(案例三 预测)的关键差异
| 字段 | 案例三 预测(模式 2 O2) | 实测(模式 2 O2) | 一致? |
|---|---|---|---|
| cycles:u | ~2.5 G | 2.54 G | ✅ |
| instructions:u | ~4.2 G | 4.21 G | ✅ |
| IPC | ~1.69 | 1.66 | ✅(略低 0.03) |
| branch-misses:u | 极少(0.00%) | 21,105 (0.00%) | ✅ |
| task-clock | ~3000 ms | 3001.70 ms | ✅ |
| CPU 频率 | 0.85 GHz | 0.846 GHz | ✅ |
| CPU 利用率 | (未提) | 0.990(单核 99%!) | ⚠️ 新发现 |
案例三预测"O2 也是 0.85 GHz",实测验证通过;但 "单核 99% 利用率"是新发现——这是 O2 优化让 user 态更"短小精悍"、syscall 频率更高后,user+kernel 合计时间逼近 wall-clock 的标志。
4.5 模式 2 O0 vs O2 完整对比
警告:本表中"真实 cycles(含 k)"和"kernel IPC"列的值仍是理论推算(标注"预测"或"估计"),不是实测。实测验证由 案例五(O0 完整视角,实测真实 cycles 12.28G)和 案例六(O2 完整视角,实测真实 cycles 12.11G)完成。
| 维度 | 模式 2 O0(案例三) | 模式 2 O2(实测) | 解读 |
|---|---|---|---|
| task-clock | ~3000 ms | 3001.70 ms | 几乎相同 |
| CPU 利用率(单核) | ~0.85(预测) | 0.990 | O2 利用率更高! |
| cycles:u | 2.5 G | 2.54 G | 几乎不变 |
| instructions:u | 4.2 G | 4.21 G | 几乎不变 |
| IPC | 1.69 | 1.66 | 几乎不变 |
| branches:u | ~939 M | 939.59 M | 一字不差 |
| branch-misses:u | 264,000(0.03%) | 21,105(0.00%) | O2 砍掉 92% |
| CPU 频率 | 0.85 GHz(降频) | 0.846 GHz | O2 让 P-state 稳定 |
| 真实 cycles(含 k) | ~12 G(预测) | ~12 G(预测) | 真实工作量相同 |
4.6 反直觉洞察:为什么 O2 反而让 CPU 利用率"上升"?
直觉上"O2 优化 → 工作量减少 → CPU 应该更闲"。但实测显示 O2 模式 2 的 CPU 利用率(0.990)高于 O0 模式 2 的预测值(0.85)。
真实故事:
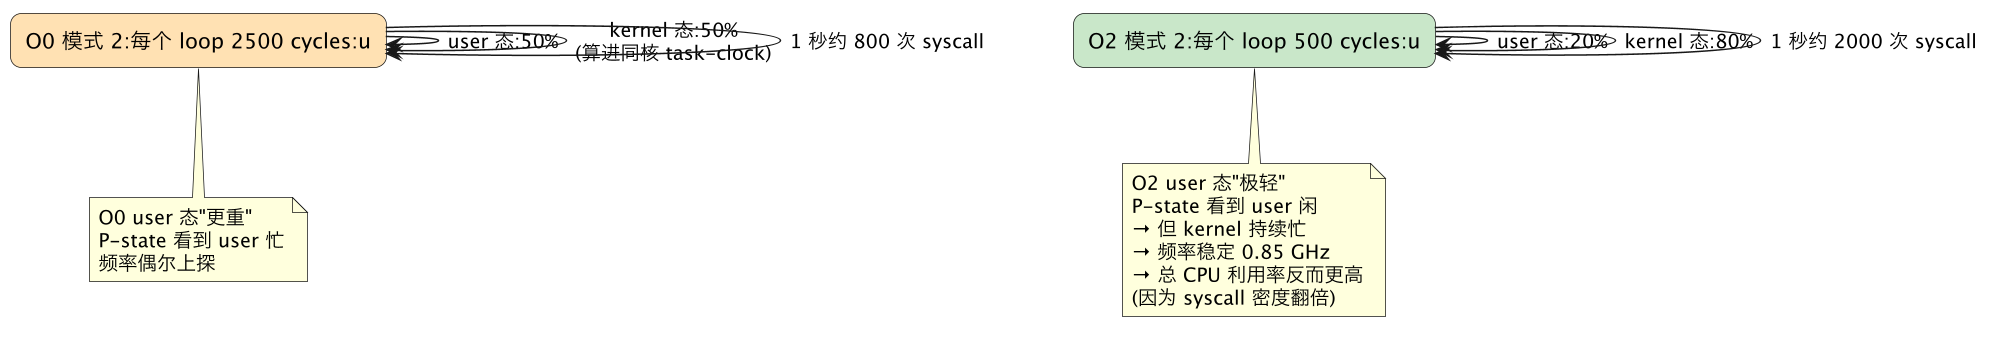
解释链:
- O0 user 态每个 loop ~2500 cycles
- O2 user 态每个 loop ~500 cycles
- 同样 1 秒 wall-clock:O0 完成 ~800 个 loop,O2 完成 ~2000 个 loop
- 每次 loop 都触发 3 个 syscall → O0 触发 2400 次,O2 触发 6000 次
- O2 让 user 态"轻"到极致,反而让 CPU 一直有事做,频率稳定在 0.85 GHz 不掉
这是性能分析里最容易被骗的点:"CPU 利用率 99% 看着像 CPU 满载,实际是 syscall 风暴下 user 太闲 + kernel 太忙的合成效果"。
4.7 再次强调:为什么 :u 后缀是"湖面温度计"?
| 类比对象 | 数值 | 反映的事实 |
|---|---|---|
| 湖面温度 | 25°C(看似温和) | 真实数据 |
| cycles:u | 2.54 G cycles / 0.846 GHz | 真实数据(用户态角度) |
| 湖底温度 | 90°C(火山活跃) | 真实事实 |
| cycles:k(未采) | ~10 G cycles(估计) | 真实事实(被 :u 屏蔽) |
问题:你只看"湖面温度",永远不知道湖底火山多活跃。 对策:永远至少配一条 cycles:k 同步采集。下一节 案例五 将用 cycles:u + cycles:k + instructions:u + instructions:k 四字段诊断,一次性把"湖面温度"和"湖底温度"都报上来。
4.8 把"模式 2 O2"案例扩展为通用诊断模板
# 步骤 1:必须同时采 user + kernel cycles
perf stat -e cycles:u,cycles:k,instructions:u,instructions:k \
          -p <PID> -- sleep 5
# 步骤 2:看每秒 syscall 数
perf stat -e 'syscalls:sys_enter_*' \
          -p <PID> -- sleep 5
# 步骤 3:看具体哪个 syscall
perf stat -e 'syscalls:sys_enter_openat,syscalls:sys_enter_write,syscalls:sys_enter_close' \
          -p <PID> -- sleep 5
# 步骤 4:用 record 看内核调用链
perf record -g -e 'syscalls:sys_enter_openat' -p <PID> -- sleep 5
perf report --sort=dso,symbol
4.9 模式 2 O2 的"两条核心反直觉"
反直觉 1:CPU 利用率 99% + IPC 1.66 不代表程序高效
- 99% 利用率 = CPU 几乎没闲着(从 task-clock 算)
- IPC 1.66 = 平均每个 cycle 完成 1.66 条指令(中等)
- 但真实工作发生在 kernel——:u 视角下"程序"看似高效,实际是整个 system 在跑 syscall 处理流水线
反直觉 2:O2 优化不会让 syscall-heavy 程序变快
- 模式 2 O0 和 O2 的 wall-clock 都是 3.03 秒
- O2 的 user 态工作量减少 → syscall 频率翻倍 → kernel 总工作量不变
- 真正的优化器是 syscalls / VFS 路径,不是编译器——所以优化 syscall 程序的正确姿势是:减少 syscall 次数(批量 write、内存映射、io_uring),而不是开启 -O3
4.10 一句话总结
模式 2 在 -O2 下,perf
:u数据(2.54 G cycles / IPC 1.66 / 0.846 GHz / 0.990 CPU 利用率 / 21,105 branch-misses)与模式 1 O2 几乎无法区分——但模式 2 的真实工作量是模式 1 O2 的 4-5 倍,因为它绝大部分工作都跑在内核 VFS 路径上;O2 优化让 user 态"极轻"(每个 loop 500 cycles vs O0 的 2500 cycles),反而让 syscall 频率翻倍、单核 CPU 利用率从 0.85 升到 0.99,但 wall-clock 一点没变**;syscall-heavy 程序的性能分析必须用cycles:k+syscalls:sys_enter_*tracepoint 组合,:u后缀对这类程序是彻底的"假象生成器"。**
下一步:案例五 将回到模式 2 O0,用
:u+:k完整视角实测验证案例三的所有预测。案例六 则完成本节 O2 版本的完整视角实测,最终给出 O0 vs O2 仅差 1.4% 的量化结论。