FPGA 订单执行子系统
概述
订单执行是将策略决策转化为交易所协议报文并发送的过程。在 FPGA 方案中,订单执行子系统从"收到触发信号"到"报文离开光纤"的延迟可控制在 50-200 ns,而软件方案需要 500-1500 ns。
软件方案 (500-1500ns)
触发信号 → 上下文 → 序列化 → NIC TX → DMA → MAC → 光纤
          (软件上下文切换、内存分配、系统调用)
FPGA 方案 (50-200ns)
触发信号 → 模板填充 → PIO写入TX队列 → MAC → 光纤
          (全硬件流水线,零软件介入)
1. 订单执行流水线
1.1 四阶段流水线
┌─────────┐    ┌─────────┐    ┌──────────┐    ┌──────────┐
│ 触发    │───▶│ 字段填充 │───▶│ 前置风控  │───▶│ MAC TX   │
│ 信号    │    │ 模板引擎 │    │ 硬连线检查│    │ 发送     │
└─────────┘    └─────────┘    └──────────┘    └──────────┘
  1 cycle        2-3 cycle      1-2 cycle       1 cycle
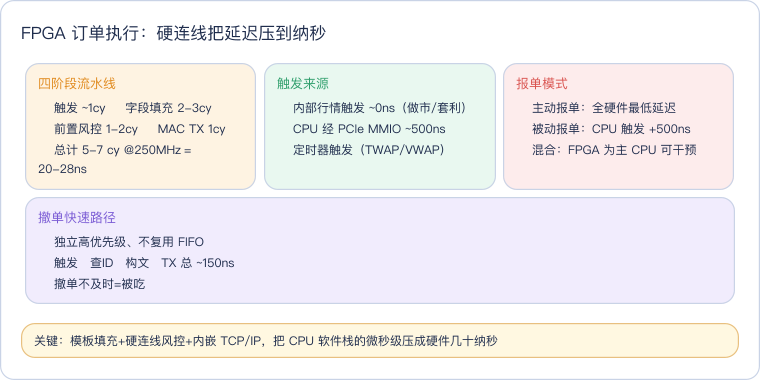
(~4ns) (~8-12ns) (~4-8ns) (~4ns)总延迟:5-7 个时钟周期 @250MHz = 20-28 ns(不含 MAC/PHY 发送层)
1.2 触发信号来源
| 来源 | 延迟 | 适用场景 |
|---|---|---|
| FPGA 内部触发(行情驱动) | ~0 ns | 做市、套利、条件单 |
| CPU 通过 PCIe MMIO 触发 | ~500 ns | 策略引擎决策后 |
| 定时器触发 | ~0 ns | TWAP/VWAP 等时间驱动 |
硬件触发逻辑示例(做市策略):
module market_maker_trigger (
    input wire clk,
    input wire [31:0] best_bid_price,   // 来自订单簿模块
    input wire [31:0] best_ask_price,
    input wire [31:0] target_spread,     // CPU 下发的参数
    // 输出触发信号
    output reg       place_bid,
    output reg       place_ask,
    output reg [31:0] bid_price,
    output reg [31:0] ask_price
);
    wire [31:0] current_spread = best_ask_price - best_bid_price;
    always @(posedge clk) begin
        if (current_spread > target_spread) begin
            // 价差大于目标 → 双边报价
            bid_price <= best_bid_price + 1;
            ask_price <= best_ask_price - 1;
            place_bid  <= 1'b1;
            place_ask  <= 1'b1;
        end else begin
            place_bid  <= 1'b0;
            place_ask  <= 1'b0;
        end
    end
endmodule
2. 订单模板填充引擎
2.1 设计思路
将订单协议的固定部分预存储在 BRAM 模板中,触发时只需填充动态字段。
模板 (BRAM):
┌─────────────────────────────────────────────┐
│ Header  | 账户 | 合约 | 价格=____ | 量=____  │ 预填充部分
│ (固定)  │(固定)│(固定)│ (动态)   │ (动态)   │
└─────────────────────────────────────────────┘
        触发时计算并填充 ↑          ↑
2.2 模板引擎架构
module order_template_engine (
    input  wire        clk,
    input  wire        trigger,
    input  wire [7:0]  template_id,    // 选择哪个模板
    input  wire [31:0] price,          // 动态价格
    input  wire [31:0] qty,            // 动态数量
    input  wire [63:0] order_id,       // 订单ID (自增)
    output reg         pkt_valid,
    output reg [7:0]   pkt_data,       // 逐字节输出
    output reg         pkt_last
);
    // 1. 读取模板 BRAM
    // 2. 遍历模板字节
    //    - 固定字节:直接输出
    //    - 占位符字节:替换为 price/qty/order_id 的对应字节
    // 3. 发送完成信号
endmodule性能:
- 固定开销 2-3 周期
- 每条字节 1 周期
- 一条典型 128 字节订单报文约需 130 周期 @250MHz = 520 ns(模板填充 + 串行输出)
3. 硬件化前置风控
3.1 风控必须在热路径上硬件化
软件风控的问题:如果风控在 CPU 上,FPGA 决策到 CPU 再到 FPGA 报单的来回需要 1-2 μs。这 1-2 μs 足够让一个错误订单穿过整个系统。
所以风控必须内嵌在 FPGA 流水线中,与订单填充同级。
3.2 风控检查类型与实现
3.2.1 仓位限制
module position_check (
    input wire clk,
    input wire [31:0] current_position,   // 当前持仓(来自订单簿)
    input wire [31:0] order_qty,          // 本次报单量
    input wire [31:0] max_position,       // CPU 下发的限额
    input wire        is_buy,             // 买卖方向
    output reg        allowed
);
    wire signed [32:0] new_position;
    assign new_position = is_buy ?
        (current_position + order_qty) :
        (current_position - order_qty);
    always @(posedge clk) begin
        allowed <= (new_position >= -max_position) &&
                   (new_position <= max_position);
    end
endmodule延迟:1 周期(组合逻辑 + 寄存器输出)
3.2.2 速率限制
module rate_limiter (
    input wire clk,
    input wire trigger,
    input wire [31:0] max_orders_per_sec,   // CPU 下发
    output reg        allowed
);
    reg [31:0] order_count;
    reg [31:0] window_counter;              // 1秒窗口计数器
    always @(posedge clk) begin
        if (window_counter == CLK_FREQ) begin  // 每秒重置
            order_count <= 0;
            window_counter <= 0;
        end else begin
            window_counter <= window_counter + 1;
        end
        if (trigger && (order_count < max_orders_per_sec)) begin
            order_count <= order_count + 1;
            allowed <= 1'b1;
        end else begin
            allowed <= 1'b0;
        end
    end
endmodule延迟:1 周期
3.2.3 自成交检查
伪代码逻辑:
if (报单方向 == 买入 且 当前挂单中已有卖出未成交) {
    // 可能自成交 → 拒绝 或 先撤单
}
FPGA 实现:在订单簿 BRAM 中维护本策略的挂单位图,下单前做 1 次读 + 1 次比较 = 2 周期。
3.2.4 价格偏离检查
// 防止"乌龙指":价格偏离市价超过阈值
wire price_ok = (order_price >= best_bid * 0.95) &&
                (order_price <= best_ask * 1.05);
3.3 风控并行化
所有风控检查在同一个时钟周期内并行执行,结果做与运算:
wire [NUM_CHECKS-1:0] check_results;
// 所有检查并行
assign check_results[0] = position_check_result;
assign check_results[1] = rate_limit_result;
assign check_results[2] = self_trade_result;
assign check_results[3] = price_deviation_result;
// ...
wire order_allowed = &check_results; // 全为 1 才放行总延迟:1-2 周期(并行检查 + 结果汇聚)
4. 低延时发送路径
4.1 发送路径对比
| 方案 | 延迟 | 说明 |
|---|---|---|
| 普通 Linux send/sendto | 10-50 μs | 系统调用 + 协议栈 + DMA |
| DPDK rte_eth_tx_burst | 1-3 μs | 用户态 DMA |
| Solarflare ef_vi PIO | 500-800 ns | 内存映射 NIC 寄存器 |
| FPGA PIO/CTPIO | 50-150 ns | 直接写入 MAC TX FIFO |
4.2 PIO(Programmed I/O)发送
CPU/FPGA ──MMIO 写──▶ NIC 寄存器 ──▶ MAC ──▶ PHY ──▶ 光纤
              ↑
         直接写设备寄存器,跳过 DMA 描述符环
FPGA 的 PIO 优势:
- 不需要 CPU 发起 MMIO 写(省去 CPU→PCIe→NIC 的往返)
- FPGA 直接驱动 MAC IP 核的 TX 接口
- 甚至可以将 MAC IP 直接集成在 FPGA 内部
4.3 CTPIO(Cut-Through PIO)
CTPIO 更进一步:边填充边发送,不等整帧完成。
传统方式:填充完整帧 → 发送
CTPIO: 填充第1字节 → 立即发送 → 填充第2字节 → 继续发送 → ...延迟优势:
- 128 字节报文,传统方式:填充 512 ns + 发送 12 ns = 524 ns
- CTPIO:第1字节延迟 4 ns,发送完成延迟 ~128 ns(线速发送约 100 ns)
- 节省 ~400 ns
条件限制:
- 需要报文格式足够规整(预先知道整帧长度)
- 不允许需要整帧计算字段(如 IP 校验和需在末尾)
5. FPGA 内嵌 TCP/IP 协议栈
5.1 为什么需要硬件 TCP
- 中国期货市场(CTP 接口)基于 TCP
- TCP 连接管理(SYN/ACK/FIN)和重传逻辑在软件中占用大量 CPU
- TCP 的 Nagle 算法、延迟 ACK 等是延迟杀手
- FPGA 硬件实现 TCP 可以精确控制每个段(segment)的发送时机
5.2 硬件 TCP 架构
┌──────────────────────────────────────┐
│          FPGA TCP Offload Engine     │
│                                      │
│  ┌──────────┐   ┌──────────┐        │
│  │ TX 引擎   │   │ RX 引擎   │        │
│  │ 连接表    │   │ 连接表    │        │
│  │ 重传定时器 │   │ 重组缓冲  │        │
│  │ 序列号管理 │   │ ACK 生成  │        │
│  └────┬─────┘   └────┬─────┘        │
│       │               │              │
│  ┌────┴───────────────┴─────┐        │
│  │       IP 层              │        │
│  │    (校验和、分片)         │        │
│  └───────────┬──────────────┘        │
│              │                       │
│  ┌───────────┴──────────────┐        │
│  │        MAC + PHY         │        │
│  │    (SFP+ 10G/25G)       │        │
│  └──────────────────────────┘        │
└──────────────────────────────────────┘
5.3 TCP 关键优化
| 优化项 | 软件 | FPGA |
|---|---|---|
| Nagle 算法 | 必须显式设置 TCP_NODELAY | 硬件不启用 |
| 延迟 ACK | 默认 40ms | 硬件立即 ACK |
| 序列号计算 | 软件递增 | 硬件寄存器递增 |
| 校验和 | CPU 计算 | 硬件并行计算 |
| 重传超时 | 200ms-数秒(软件定时器) | 可配置纳秒精度 |
| 连接数 | 数百到数千 | 数十(硬连接受限于资源) |
6. 订单执行模式
6.1 主动报单 vs 被动报单
| 模式 | 触发方 | 延迟特点 | 场景 |
|---|---|---|---|
| 主动报单 | FPGA 自主决策触发 | 最低延迟(全硬件) | 做市、条件触发 |
| 被动报单 | CPU 通过 PCIe 触发 | +500 ns(PCIe 往返) | 策略引擎决策 |
| 混合模式 | FPGA 触发 + CPU 可干预 | 灵活 | 做市为主 + 策略为辅 |
6.2 撤单路径
撤单是交易中最对延迟敏感的操作之一——不能及时撤单意味着被"吃"。
FPGA 撤单流水线:
触发撤单 → 查找原订单 ID → 构造撤单报文 → MAC TX
    ~20 ns     ~10 ns (BRAM查找)    ~15 ns     ~100 ns
总延迟:~150 ns撤单通常走独立的高优先级路径,不与报单复用 FIFO。
7. 性能基准
| 环节 | FPGA 延迟 | 软件延迟 | 加速比 |
|---|---|---|---|
| 触发判断 | 4 ns | 200-500 ns | 50-125× |
| 订单填充 | 12 ns | 200-400 ns | 16-33× |
| 风控检查 | 8 ns | 500-1000 ns | 62-125× |
| 报文发送 | 100 ns | 500-800 ns | 5-8× |
| 端到端 | ~150 ns | 1500-3000 ns | 10-20× |
参考资料
- Solarflare ef_vi PIO/CTPIO 技术白皮书
- Xilinx 10G/25G Ethernet Subsystem (PG210)
- 《HFT FPGA System with TCP/IP Stack》—— GitHub/muditbhargava66
- 《FPGA行情解码 + Rust策略引擎》—— 腾讯云开发者社区 (2026)
- Design Gateway - Nasdaq ITCH/OUCH FPGA IP
总结
FPGA 订单执行把软件栈的微秒级延迟压成硬件纳秒级:信号触发→模板字段填充(2-3cy)→硬连线前置风控(1-2cy)→MAC TX,四阶段共 5-7 个时钟周期、@250MHz 约 20-28ns(不含 MAC/PHY)。触发可来自 FPGA 内部行情(~0ns,做市/套利/条件单)、CPU 经 PCIe MMIO(~500ns)或定时器(TWAP/VWAP)。报单分全硬件自主的主动报单(最低延迟)、CPU 触发的被动报单和混合模式;撤单走独立高优先级路径、不复用报单 FIFO,触发→查原单 ID→构文→TX 总约 150ns。关键在于模板化填充、硬连线风控和 FPGA 内嵌 TCP/IP 协议栈,彻底绕开内核与操作系统调度——适合对延迟极致敏感的做市与套利,复杂策略决策仍留给 CPU。